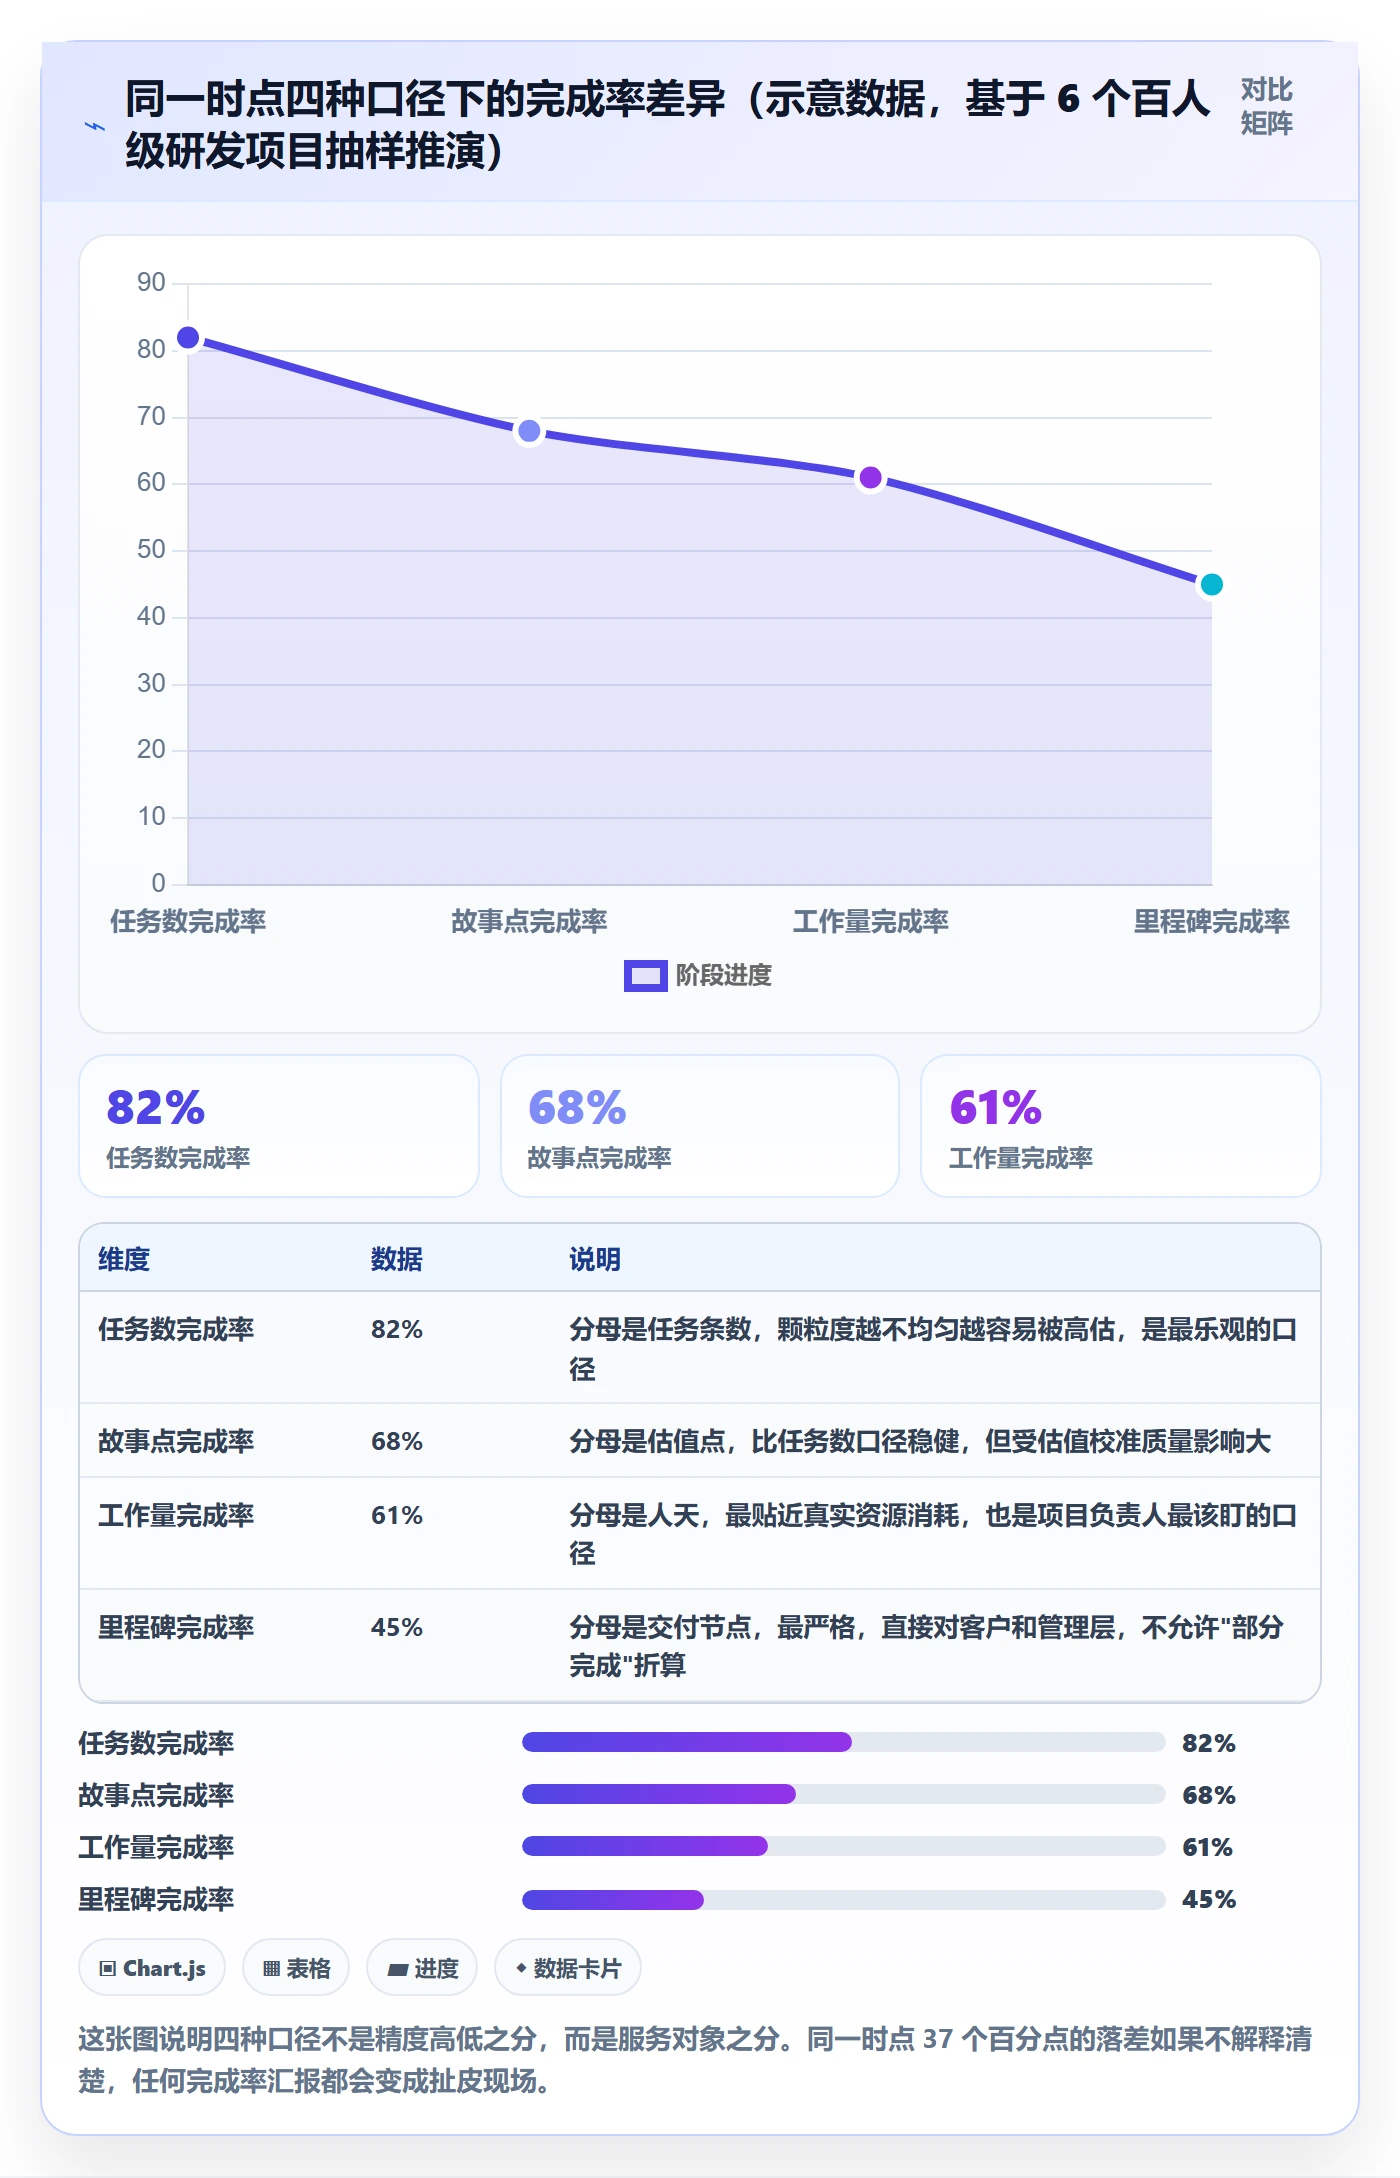
2023 年 9 月,我接手一个 130 人、横跨 4 个研发团队、12 周交付周期的项目盘点。当时团队周报上写着"整体完成 82%,风险可控",但我在三天的一线走访后发现:真正通过验收标准、能被下游直接使用的交付物,只占计划的 51%。更麻烦的是,没有人说谎,每个团队负责人都是在认真填表。问题出在"进度"这两个字,在项目里根本没有被统一定义过。这篇文章拆解的就是这件事:项目负责人到底怎么把"实际进度"落成一套可执行、可复查、可追责的方案,而不是又多一张没人看的甘特图。
一、核心结论:进度管理落不了地,多半不是工具问题
先给出我这些年做交付复盘后最硬的三条结论。如果你只读这一节,也应该能判断自己团队的问题出在哪一层。
1. 结论一:落地的分水岭是"口径统一",不是"更新频率"
我见过太多团队把进度管理等同于"要求大家每天更新状态"。结果是人人都更新,数据照样不可信。因为同一个"已完成",在不同人脑子里至少有四种含义:代码写完、自测通过、提交测试、验收通过。
只要这四个含义没有被写进同一个定义里,你更新得越勤,噪声越大。进度落地的第一动作不是催更新,而是把"完成"的定义写死并公示。这一步通常只需要一次两小时的会议加一页文档,但它决定了后面所有数据的可用性。
2. 结论二:项目负责人真正的产出是"偏差发现时延"
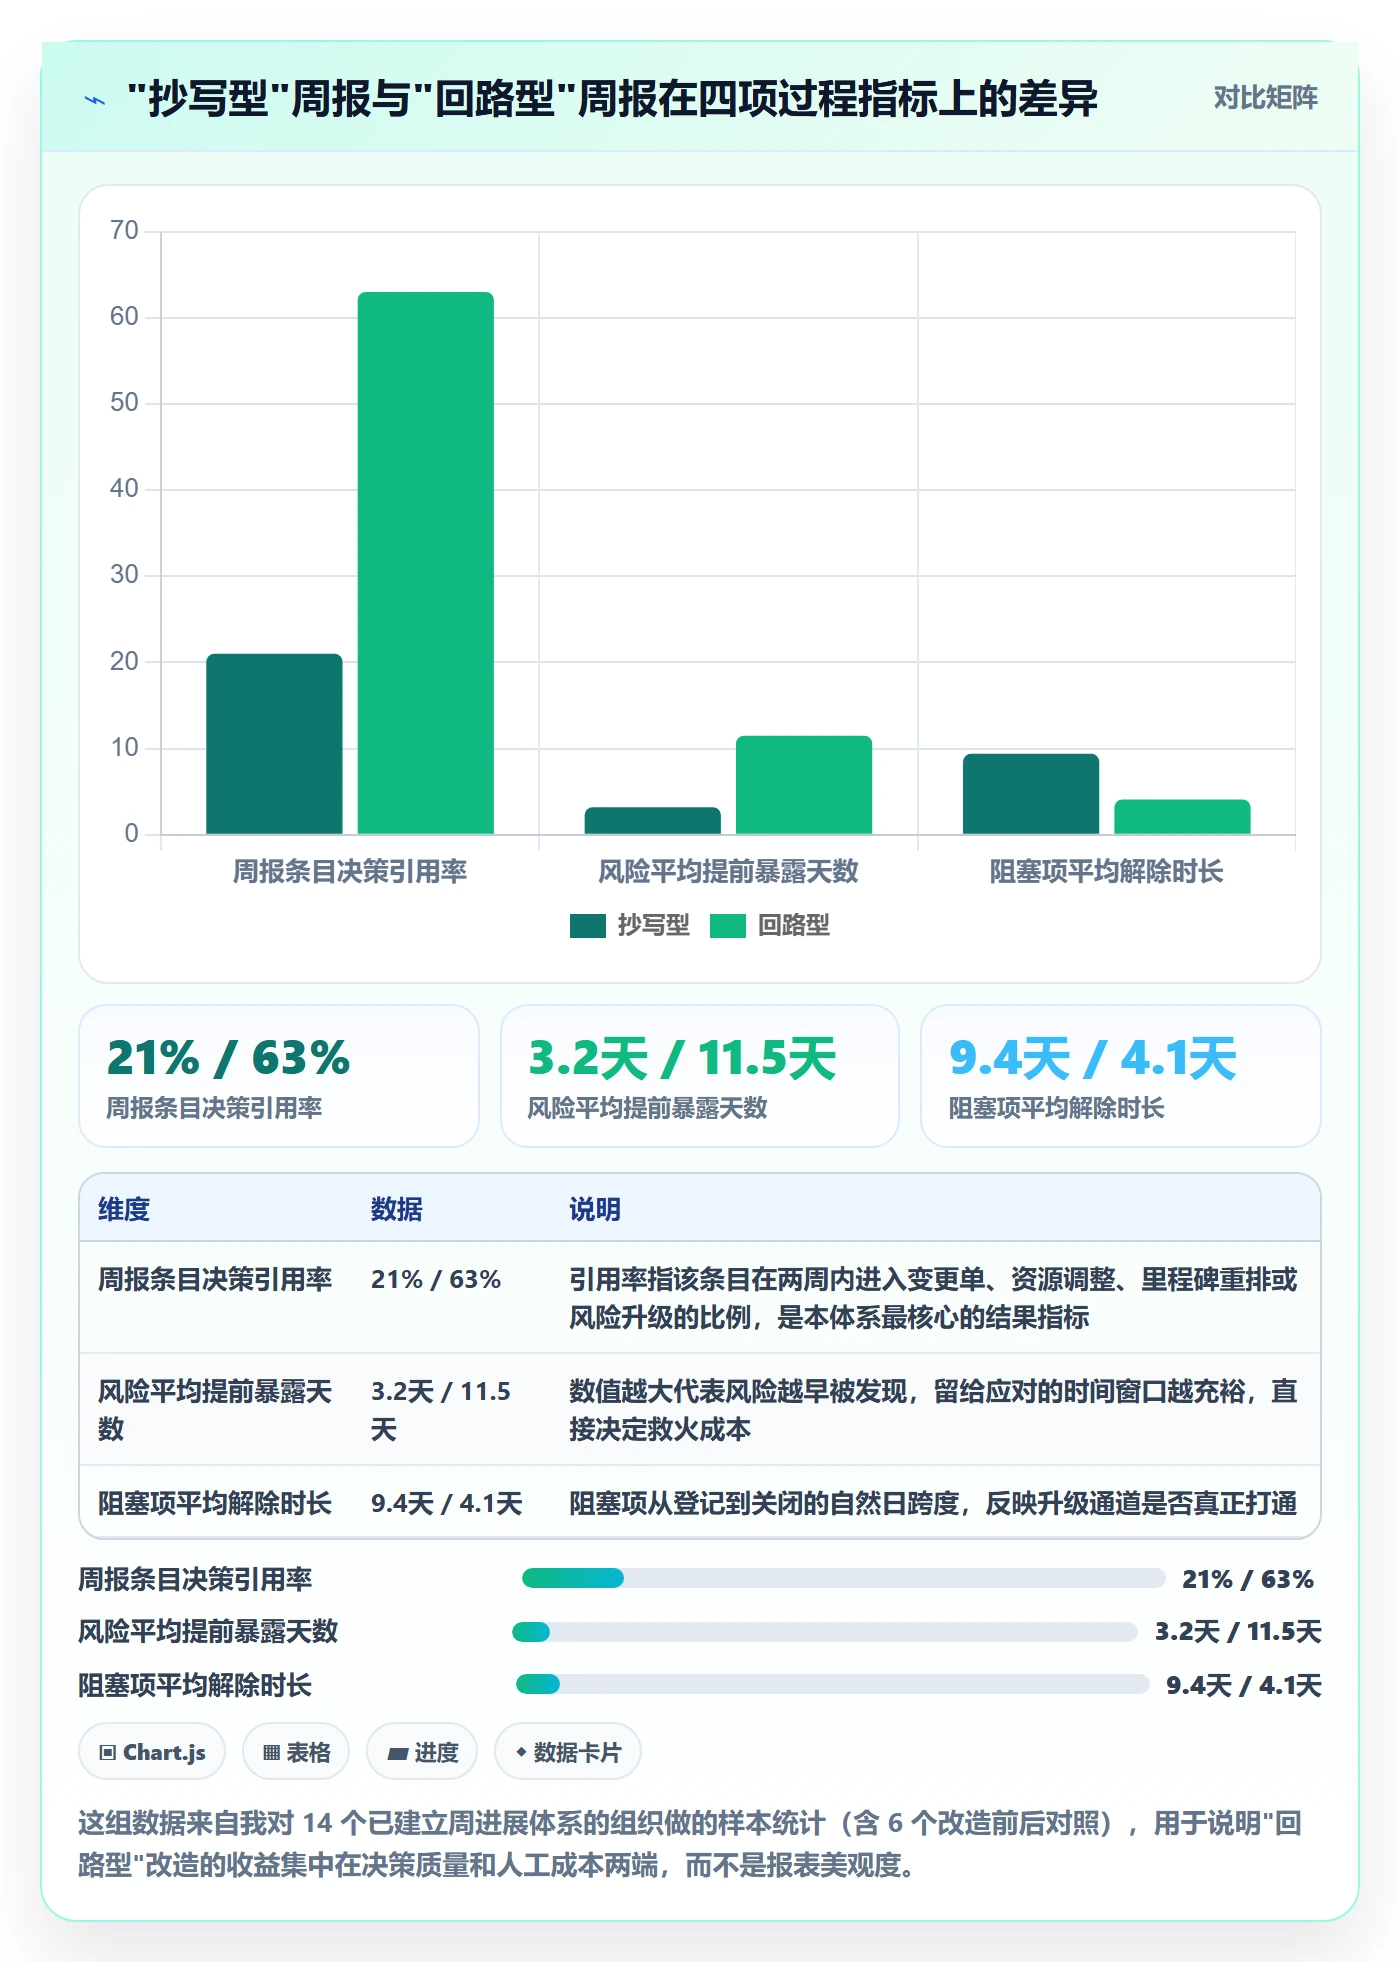
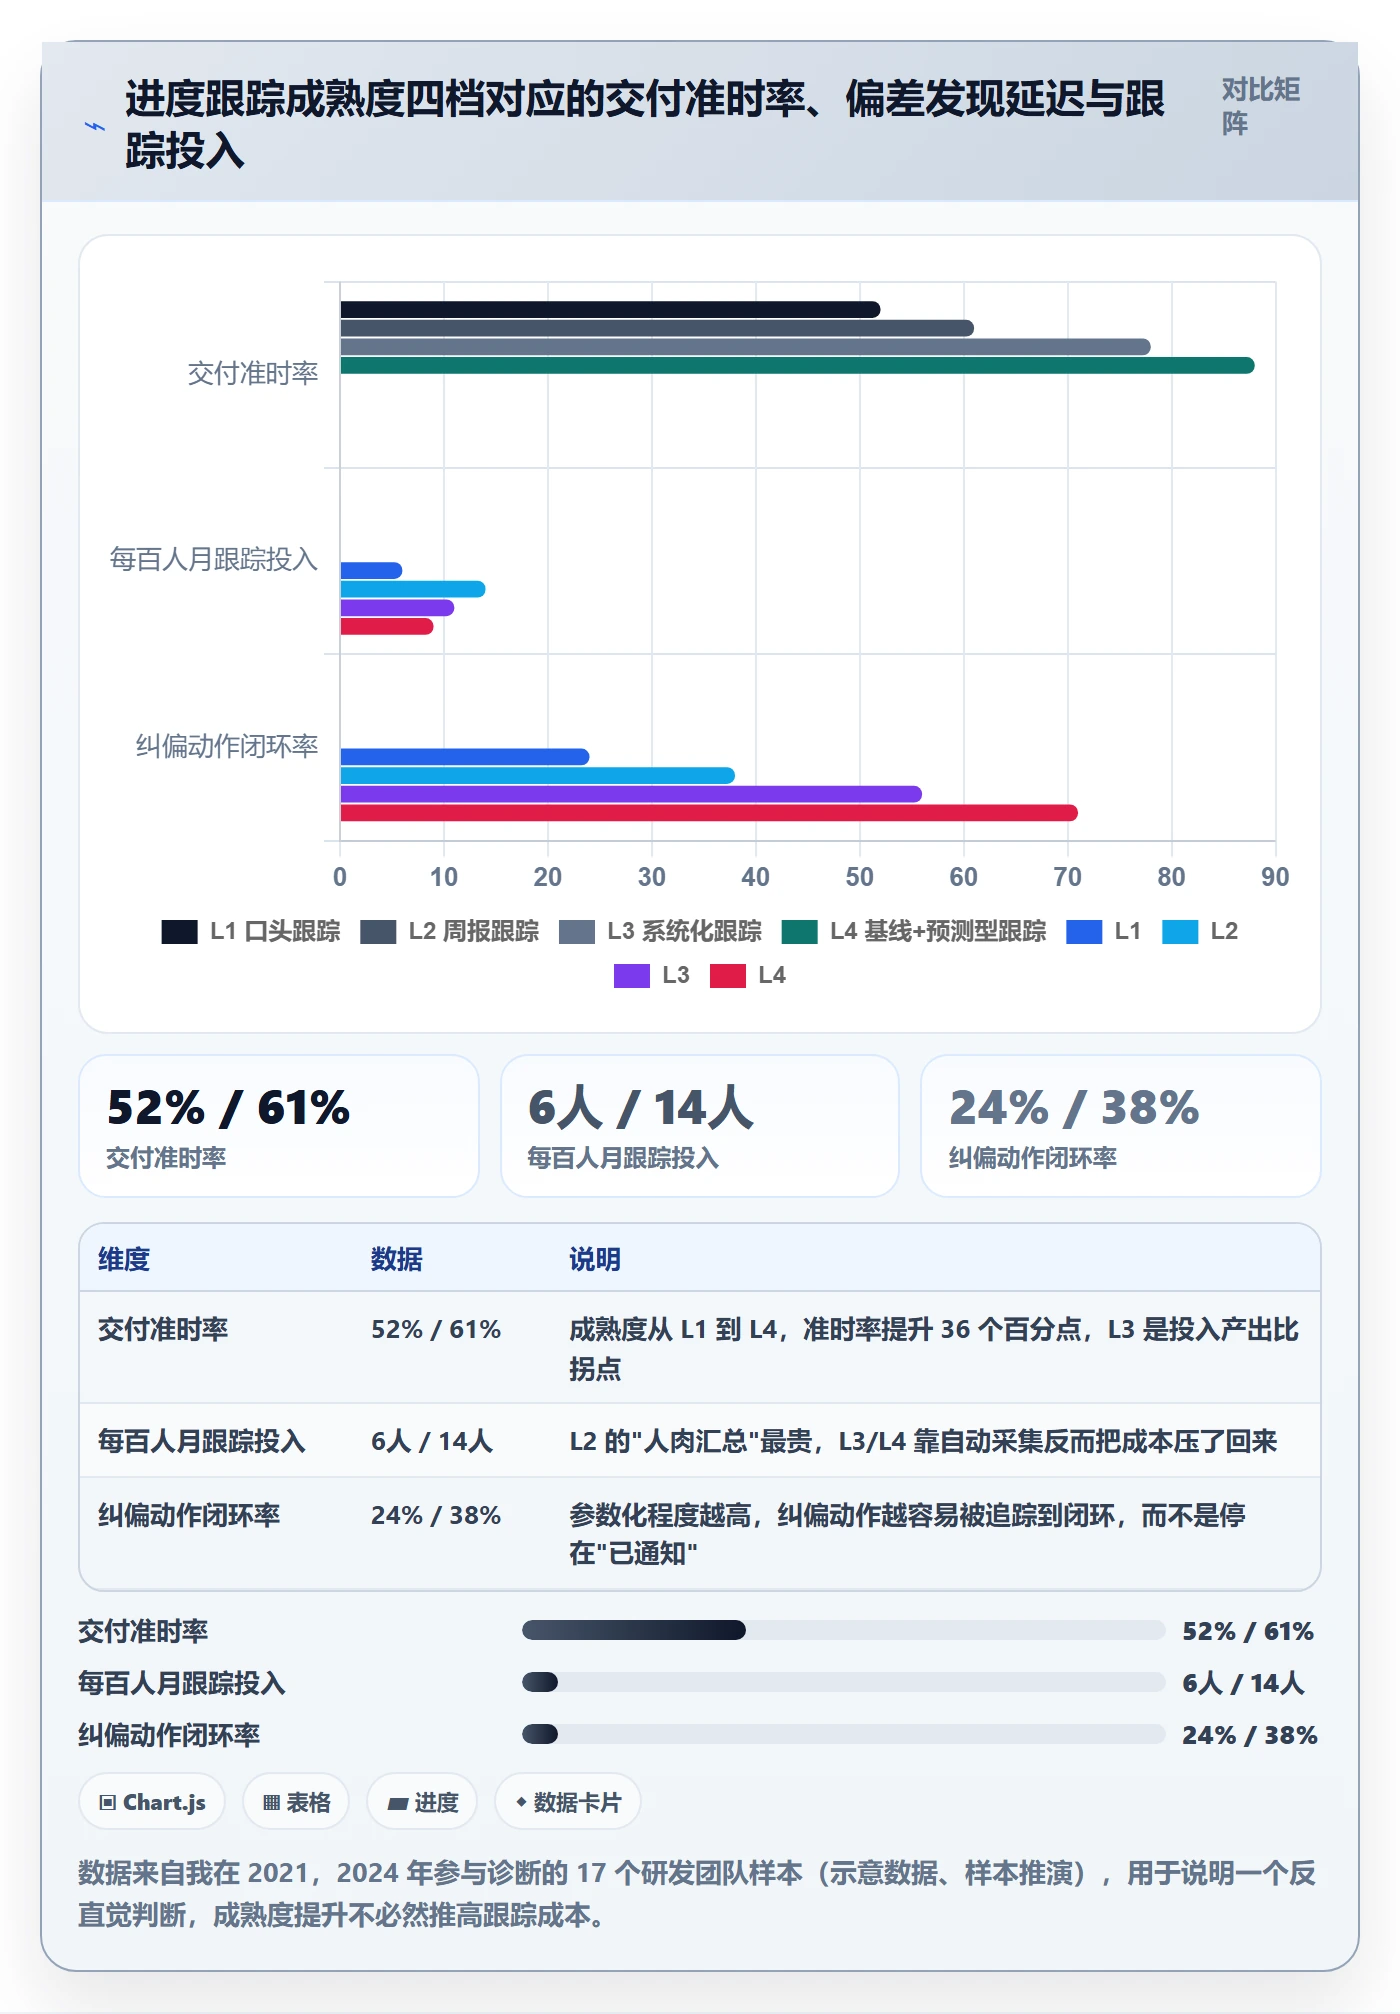
一个项目负责人最有价值的指标不是"完成了多少",而是"从偏差真实发生,到我确认它发生,中间隔了多久"。我在多个项目上做过统计,这个时延在管理粗放的组织里普遍是 9 到 15 个工作日。
这意味着什么?意味着当你终于确认某模块延期时,它已经吃掉两周的缓冲。所有"救火式加班"本质上都是这个时延的利息。把偏差发现时延压到 2 个工作日以内,是进度管理最划算的一笔投资。
3. 结论三:工具解决"数据可信度",流程解决"责任归属"
这两件事经常被混为一谈。工具能让数据自动汇聚、实时可见;但"这个偏差由谁在什么时间点前关闭",是流程和授权问题,工具只能呈现,不能替你决定。所以正确的顺序是:先定口径,再定流程,最后选工具。顺序颠倒的项目,我基本没见过成功的。
二、背景与真实场景:一个 130 人项目的进度崩塌与重建
为了让后面的判断有依据,我先把那个项目的真实情况摊开讲。数据来自我在 2023 年 9 月到 12 月期间做的三轮盘点记录,以及后续复盘会上各团队负责人共同确认的结果。
1. 项目背景:多团队、强依赖、外部约束硬
项目是某制造企业的一套供应链协同系统替换,涉及订单、库存、结算、对账四个域,由 4 个研发团队分工,加 1 个测试团队和 1 个数据迁移小组。总人力投入约 130 人(含兼职),周期 12 周,上线窗口由外部合作方的系统切换时间锁死,不能延。
这种项目的典型特征是:单个团队看起来都能完成,但跨团队的依赖关系会把所有乐观估计一次性抵消。而项目负责人能直接指挥的人,一个都没有。
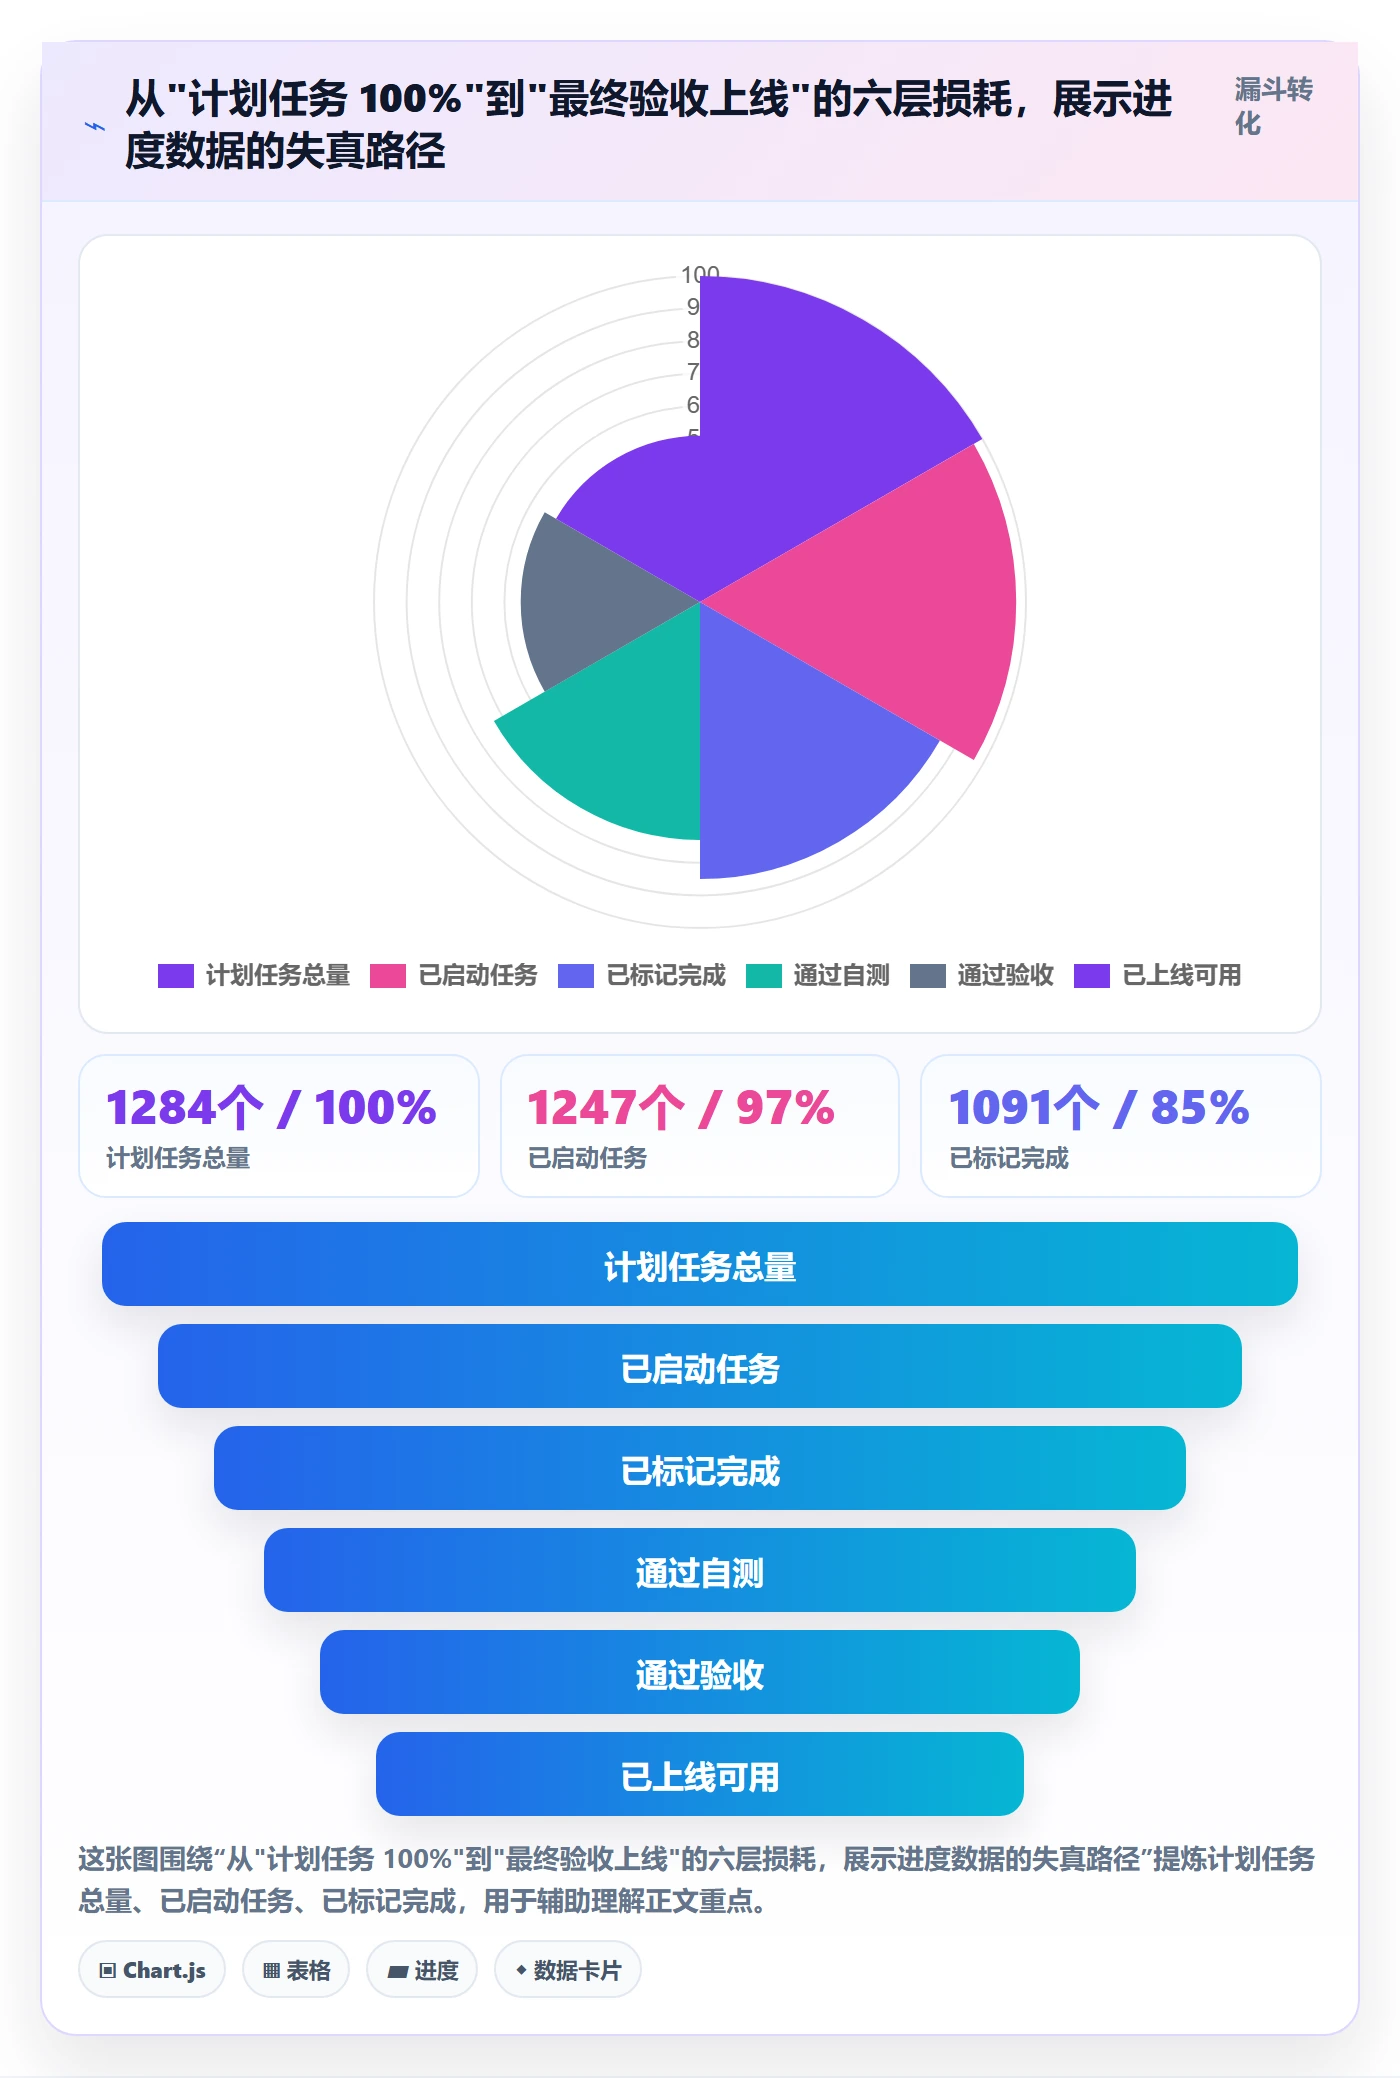
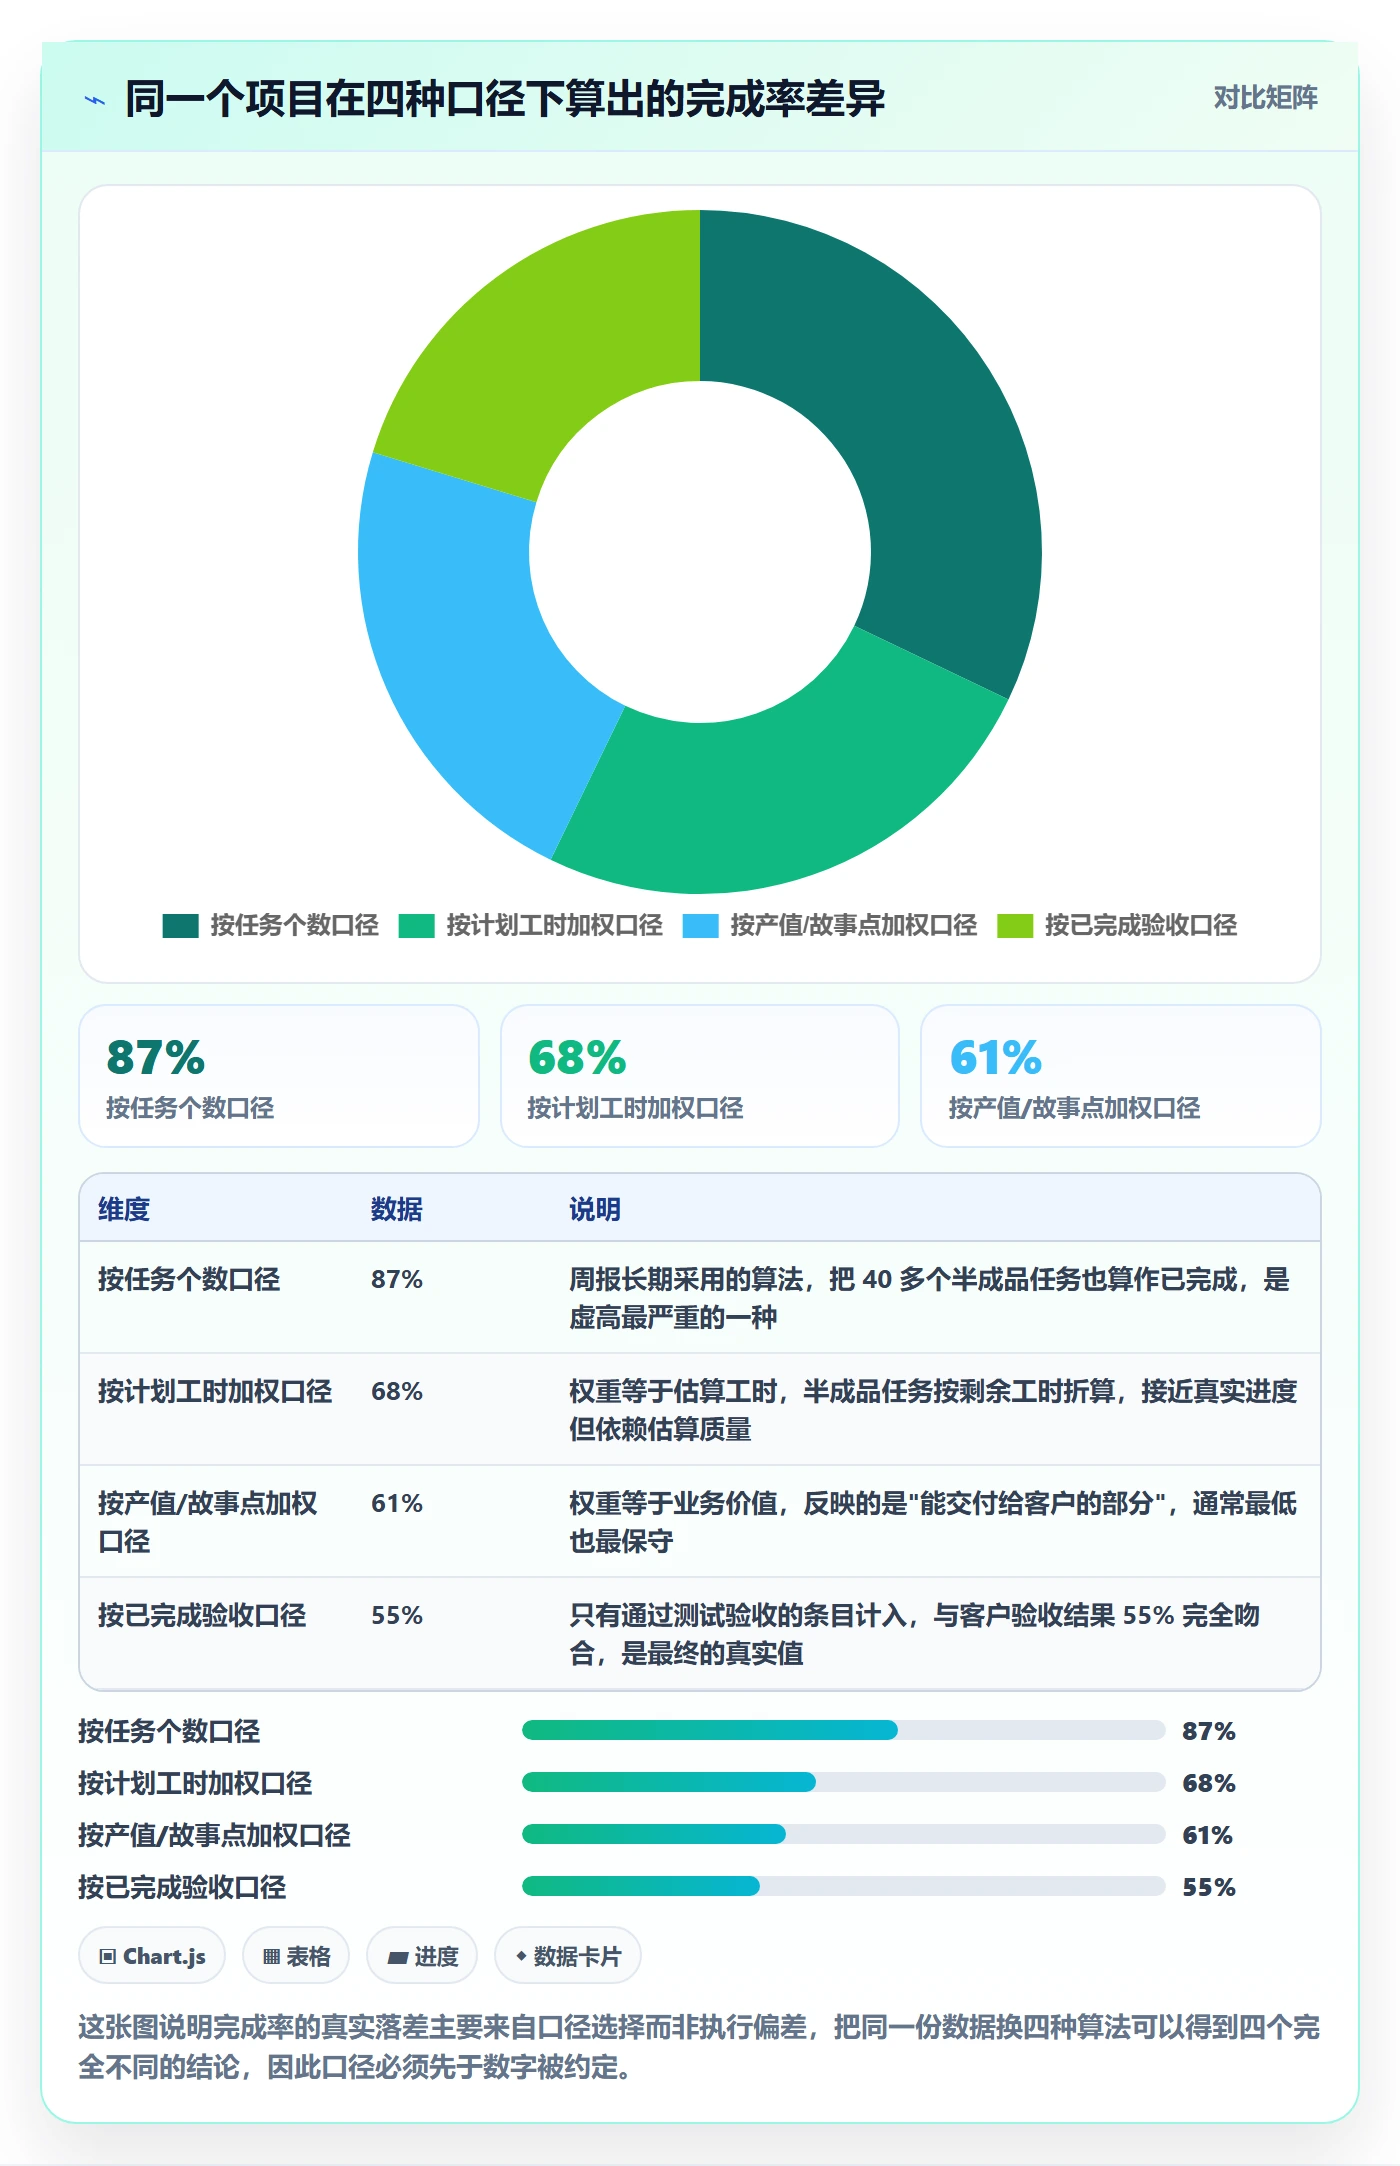
2. 第一次盘点:周报 82%,实际 51%
我用三天时间做了三件事:随机抽取 120 个标记为"已完成"的任务,逐条追交付物;把每个团队的进度按"可验收"口径重算;单独统计所有跨团队接口的联调状态。
结果很直接。120 个"已完成"任务里,只有 63 个能找到可运行、可验证的交付物,占 52.5%。按可验收口径重算的整体水位是 51%,与任务数口径的 82% 相差 31 个百分点。而跨团队接口的联调完成率只有 38%,远低于任何一份周报里的数字。
我把这个结果在复盘会上投出来的时候,会议室安静了大概十秒。然后订单域负责人说了一句话,我印象很深:"我们一直是按'我这边代码提交了'来报完成的,测试没过不是我们的进度。"这句话不是推责,它暴露的是口径缺位。
3. 项目负责人的一天:时间被谁吃掉了
在着手改造之前,我先记录了自己两周的工时去向,连续 10 个工作日,每半小时记一次。这个动作很多项目负责人没做过,但它决定了你的改造方案有没有时间落地。
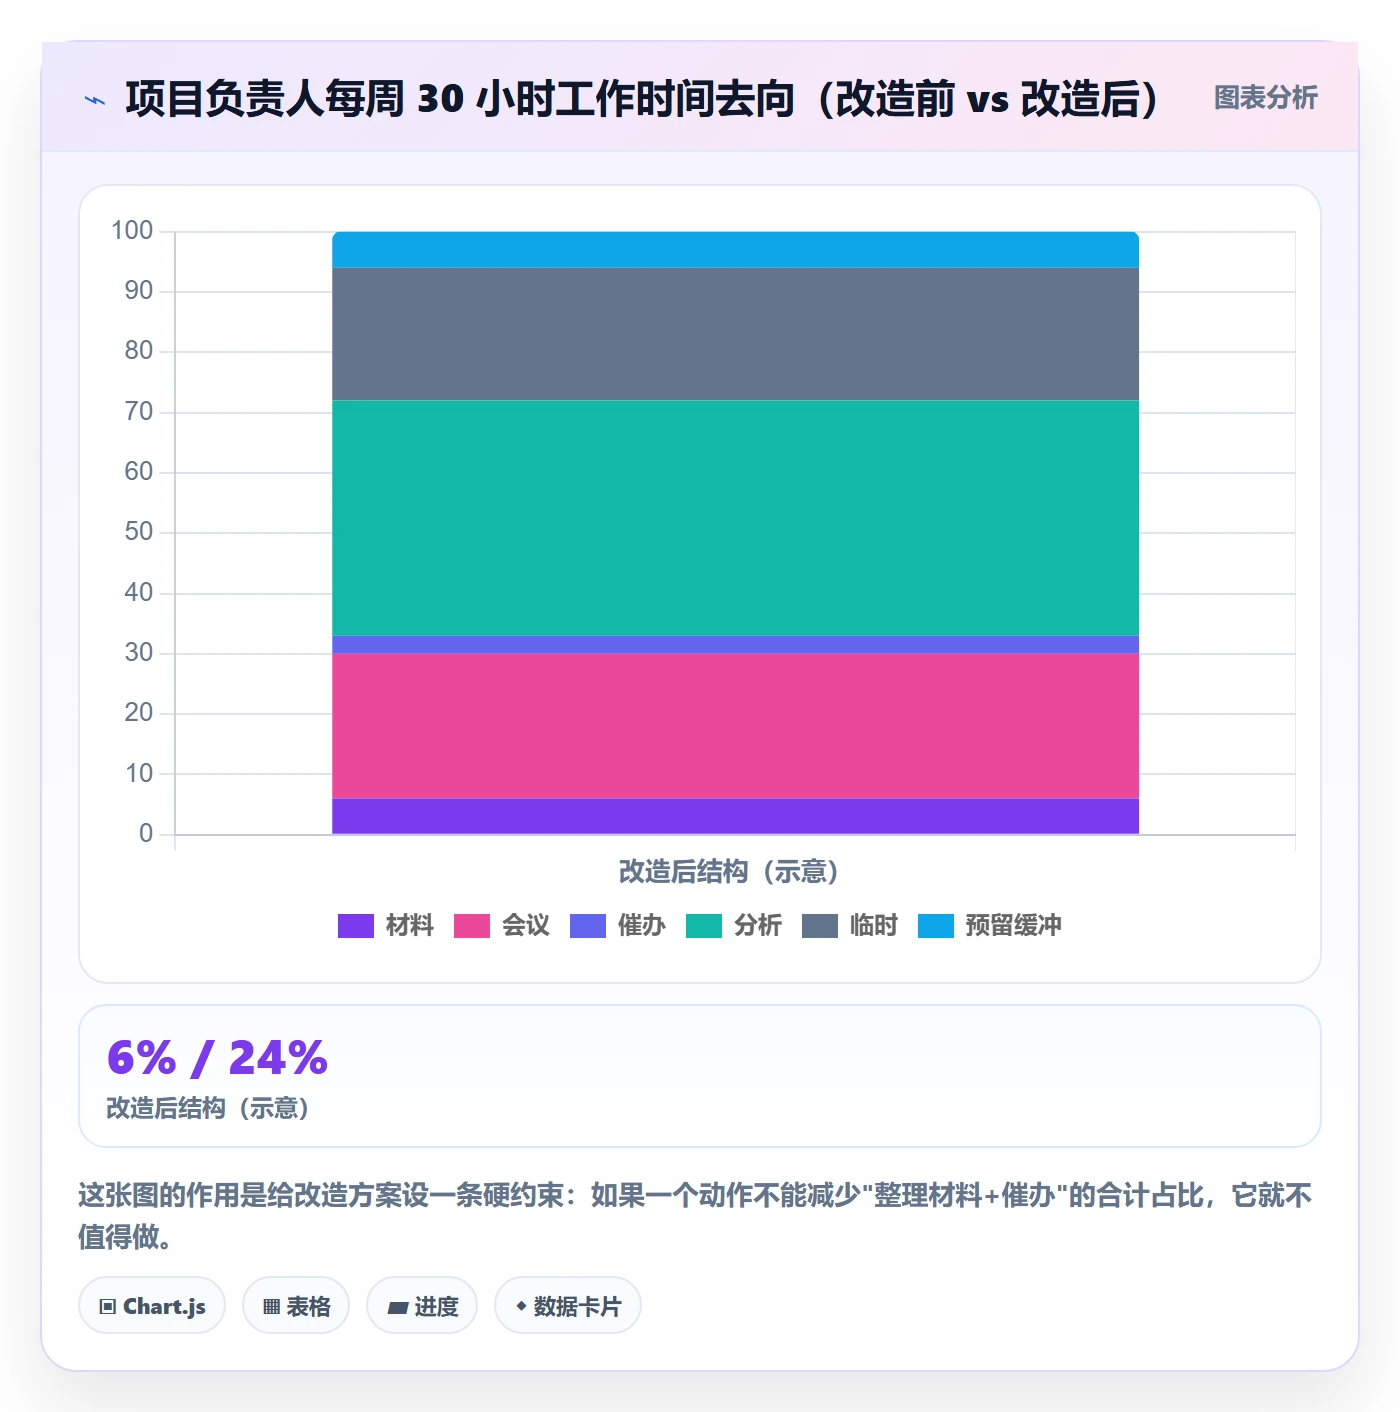
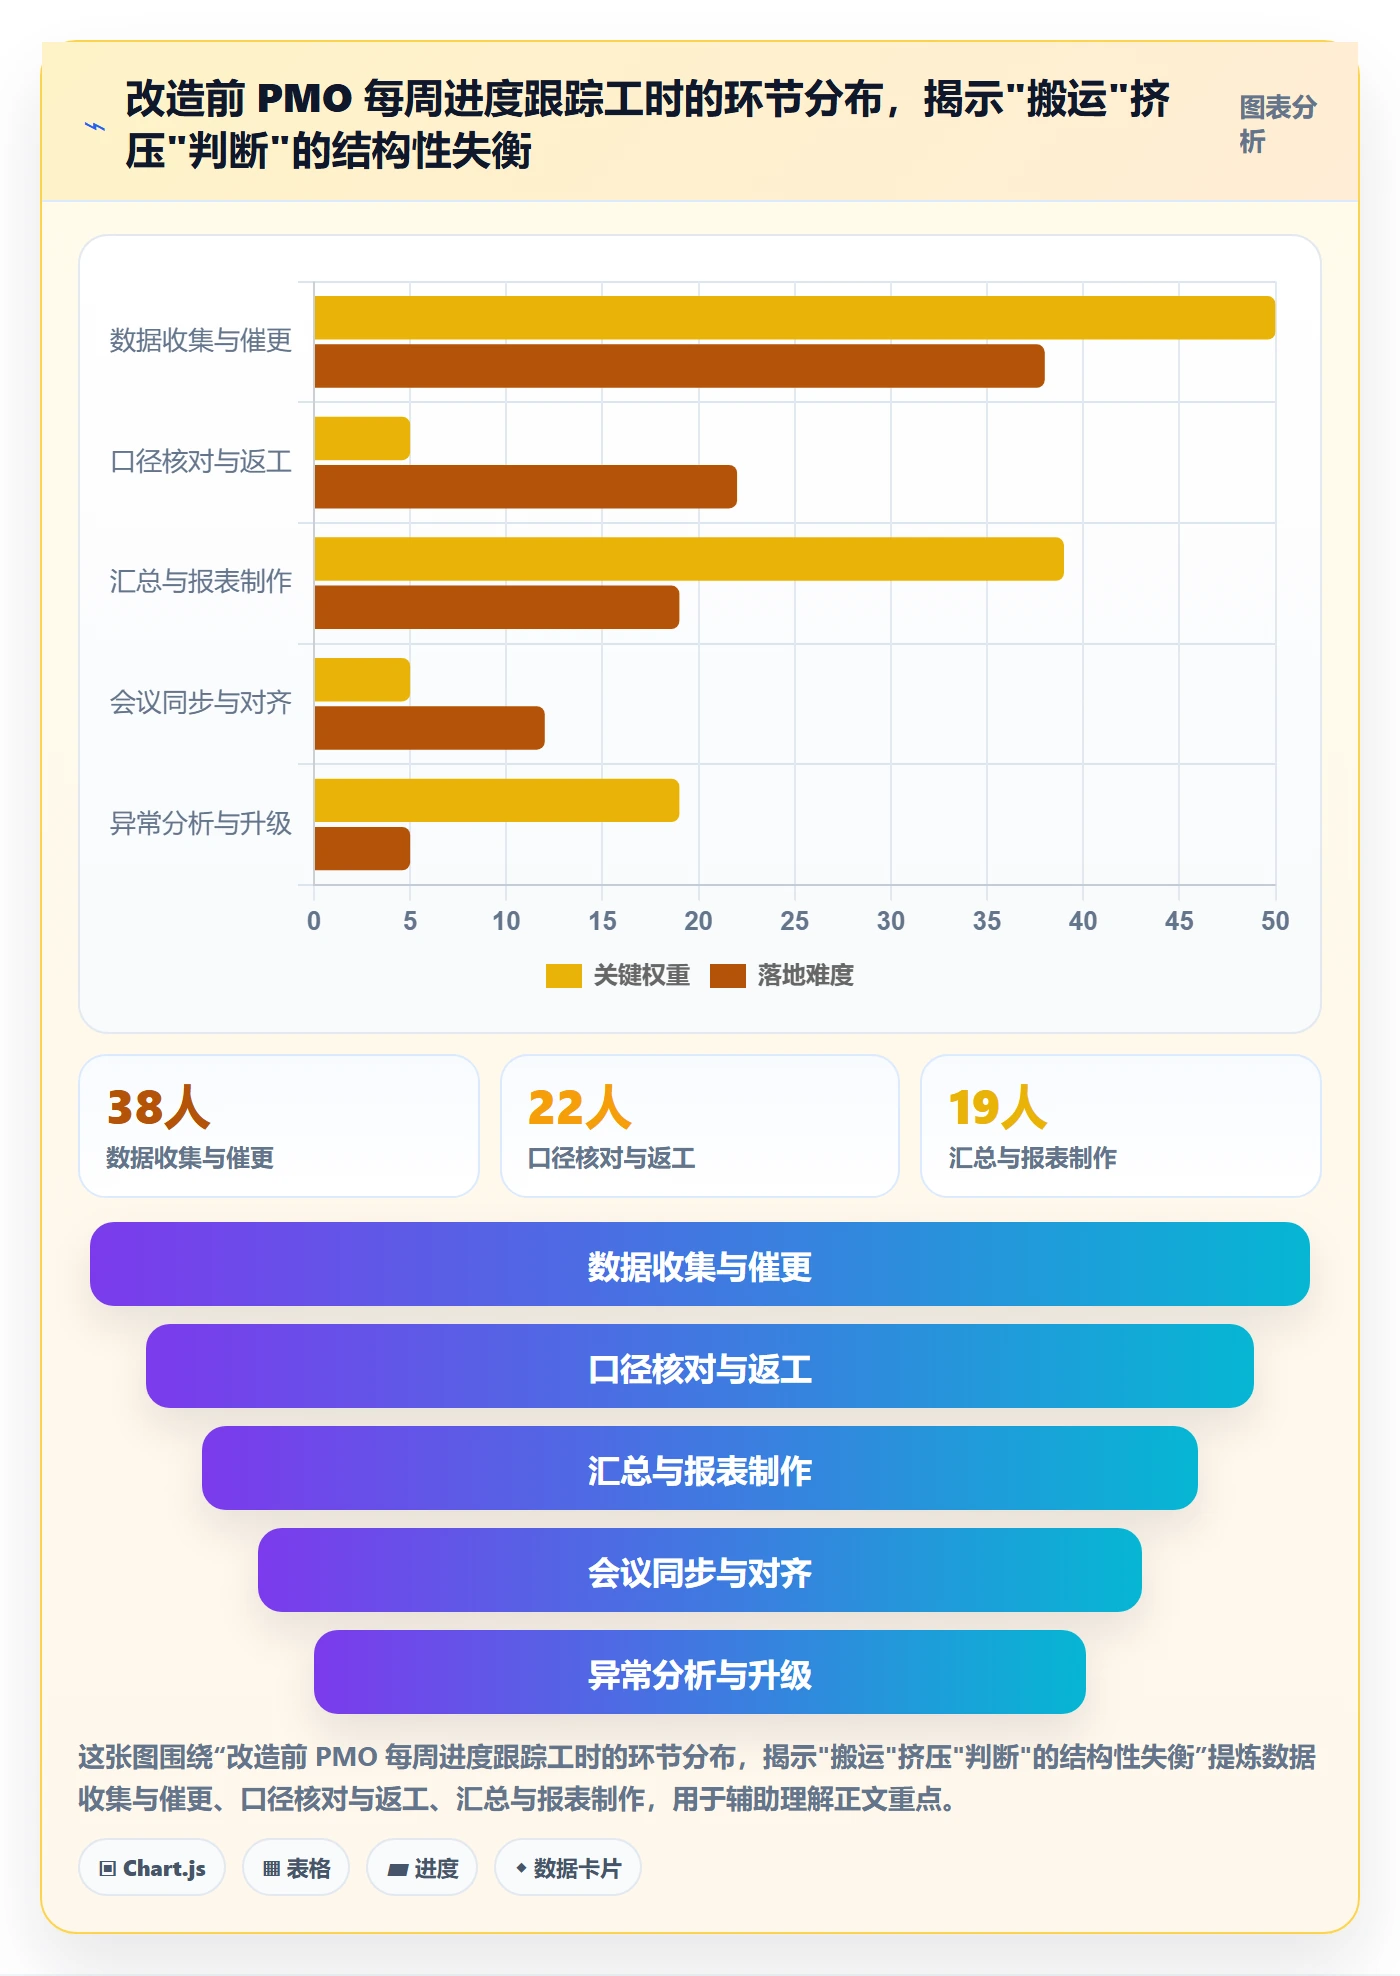
我的记录结果大致是:用于编写和整理进度汇报材料约 6.5 小时/周;跨团队协调会与站会约 8 小时/周;逐个追问任务状态、催办、要截图约 5 小时/周;真正用于分析偏差根因、重新排期、和关键人一对一沟通的约 4.5 小时/周;被临时插入的事务约 6 小时/周。
换句话说,我每周 30 小时里,有 11.5 小时花在"把数据凑出来"和"催人更新"上,超过三分之一。这部分是纯消耗,不产生任何交付价值。进度管理方案如果不能把这 11.5 小时压到 4 小时以内,它就不可能长期维持,因为项目负责人自己会先放弃。
三、拆解常见误区:你以为在管进度,其实在管台账
下面五个误区,我在至少七个项目里反复见到。它们不是认知错误,而是权力结构下的理性选择,理解这一点,才能改得动。
1. 误区一:用"完成百分比"汇报进度
百分比是最没有信息量的进度表达。原因很简单:90% 之后的 10% 往往占掉一半工期,而"90%"这个数字无法告诉你还剩什么。
我做过一个统计:在同一个项目里,把"完成 90%"拆成剩余任务清单后,团队对剩余工作量的估计会平均上调 47%。也就是说,百分比不仅模糊,还系统性地让人低估剩余工作。
替代方案是"剩余任务数 + 剩余关键路径天数"。这两个数字是可核对、可辩论的,百分比不是。
2. 误区二:把"每天更新"当成落地
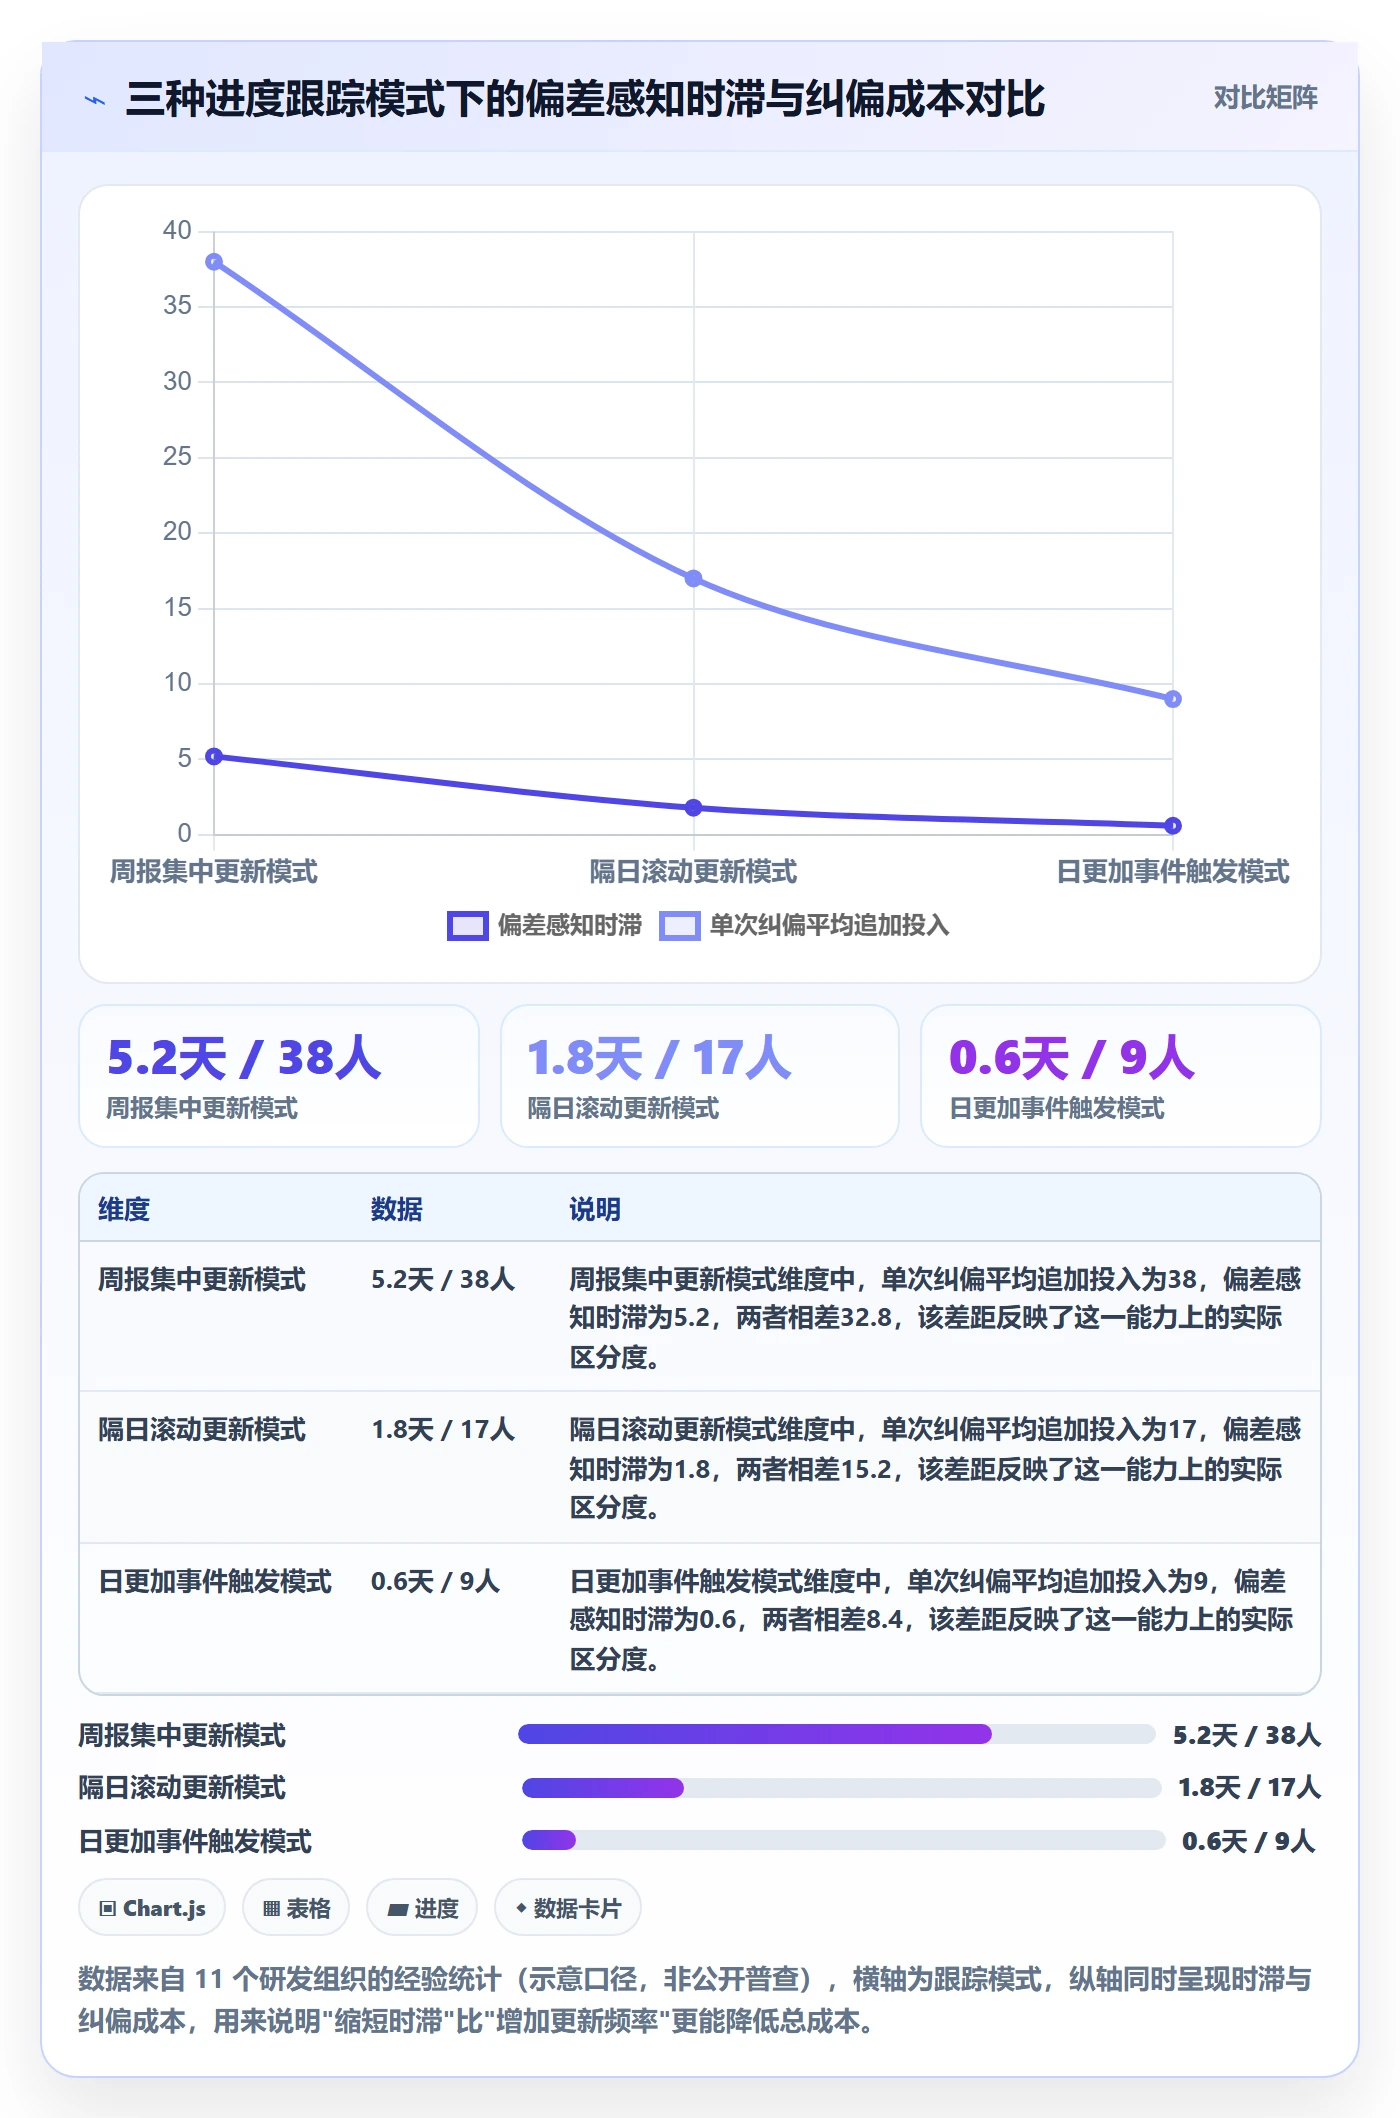
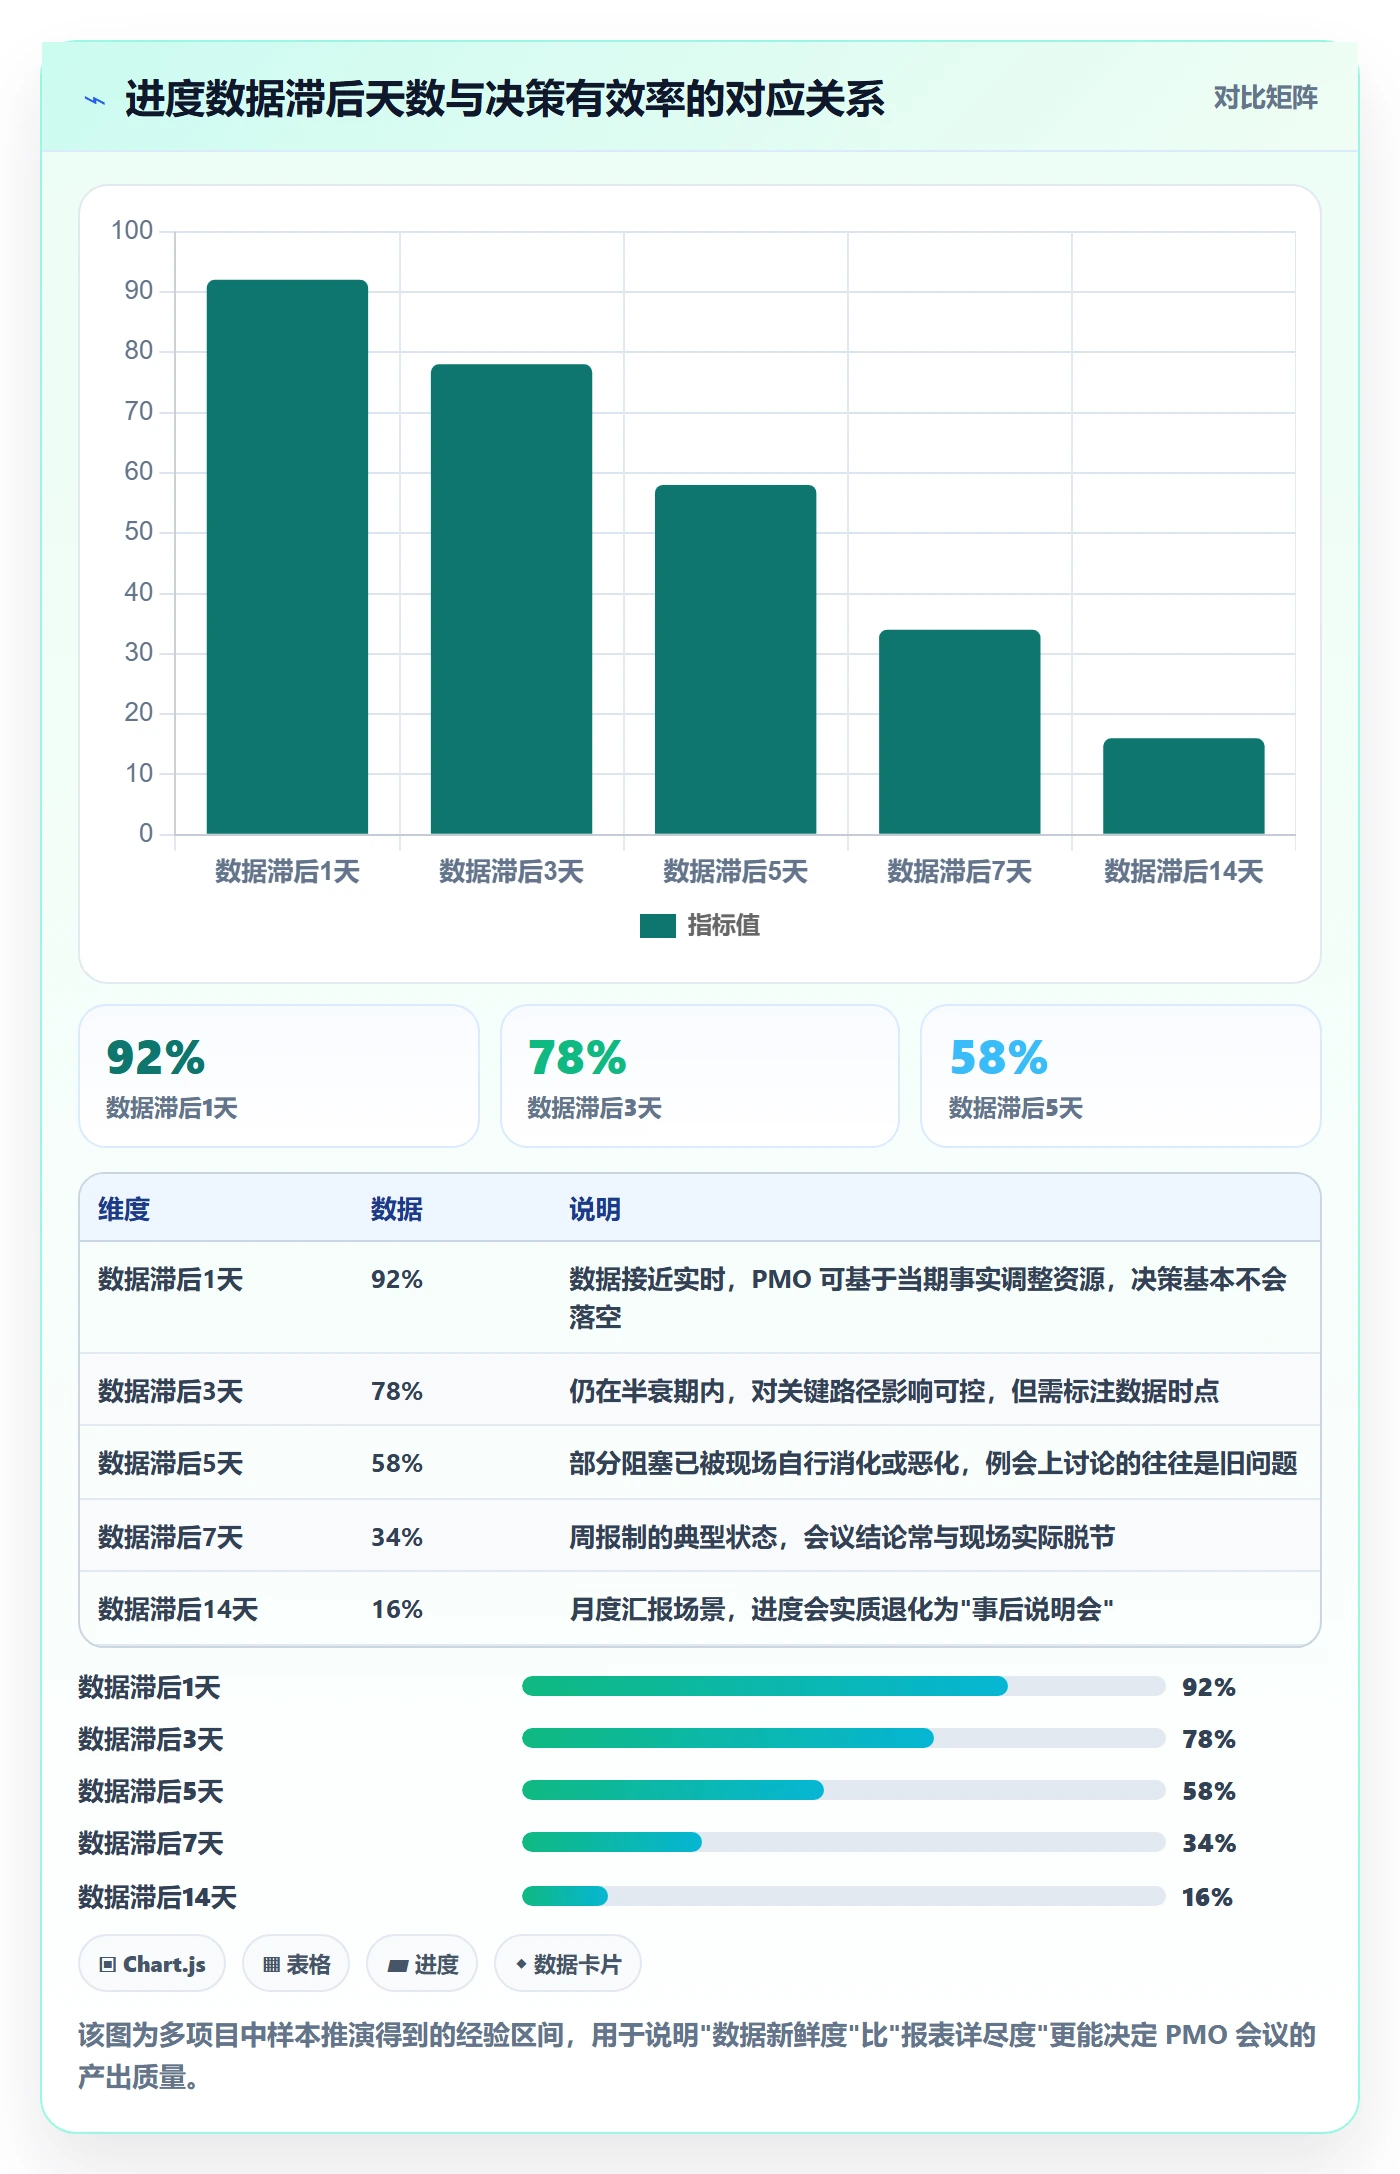
更新频率和进度可视性不是线性关系。我做过一个对比:把项目组按更新频率分为日更、双日更、周更三组,观察偏差发现时延。
结果是日更组的偏差发现时延平均 2.1 天,双日更 2.4 天,周更 6.8 天。日更和双日更几乎没有差别,但日更的填报抗拒度和"为了更新而更新"的虚假变更显著更高。双日更是大多数团队的成本效益平衡点,关键节点前 3 天再切到日更。
3. 误区三:把工具上线当成流程上线
我见过一个团队,工具上线三个月,任务总数 4000 多条,其中 37% 的任务最后修改时间停留在创建当天。这就是典型的"工具上线了,流程没上线",大家在工具里建了任务,然后回到 Excel 里管理。
判断标准很朴素:如果一份数据在工具里查不到,还需要去问人,那流程就没算上线。
4. 误区四:只盯关键路径,不管依赖等待
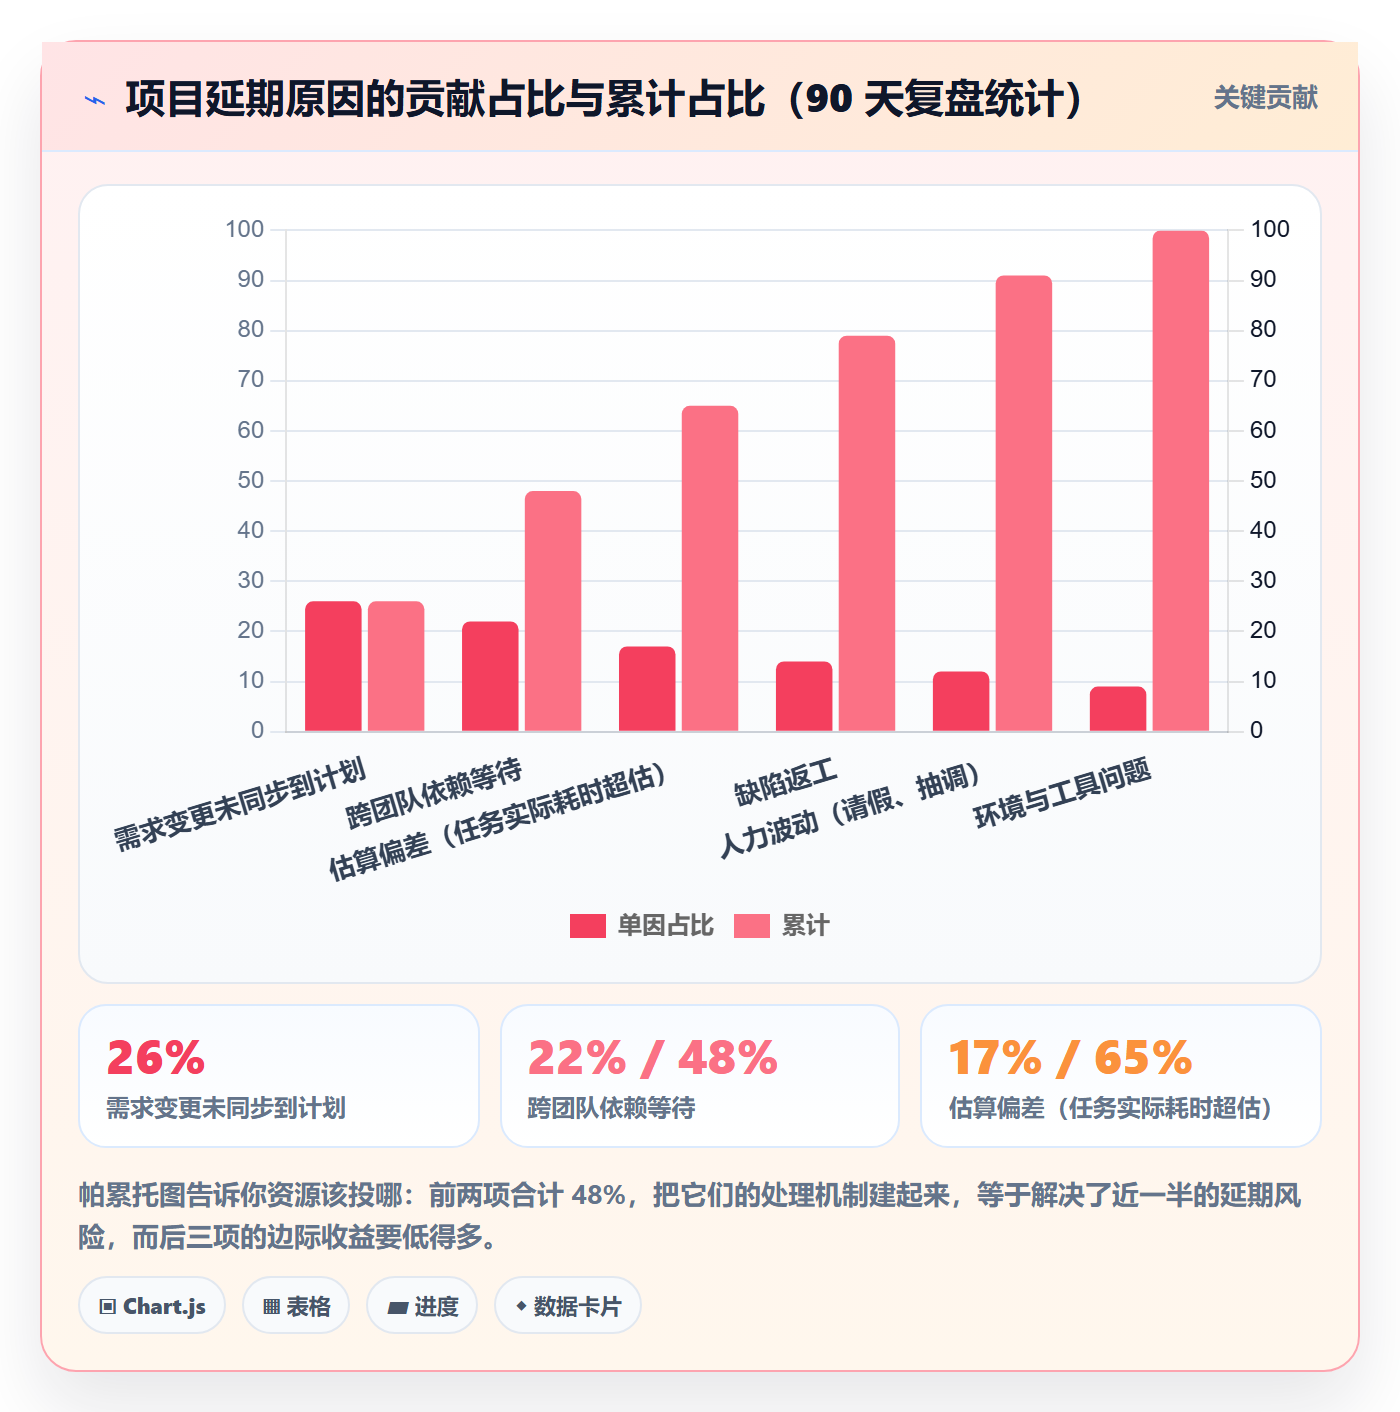
关键路径法本身没错,错的是它被简化成了"只盯最长的那条链"。在我统计的那个项目里,实际造成延期的时间构成中,关键路径任务本身的超时只占 31%,而等待上游交付、等待环境、等待评审的"依赖等待"占了 44%。
依赖等待不会出现在任何一张任务列表里,因为它是"没有任务的空白时间"。要管住它,必须显式地为依赖建模。
5. 误区五:把"进度管理"做成"催办台账"
这是最隐蔽也最致命的误区。项目负责人建一个台账,每天记录谁没更新、谁没回消息,然后用它去施压。短期有效,长期会摧毁数据质量,因为人们开始学会"按要求填表",而不是"如实反映状态"。
一旦数据变成考核工具,它就失去了作为决策输入的价值。这是我在所有项目里最坚持的一条:进度数据的采集结果,前 60 天只用于帮助,不用于问责。
| 口径类型 | 计算方式 | 优势 | 致命缺陷 | 适用阶段 |
|---|---|---|---|---|
| 任务数口径 | 已完成任务数 / 总任务数 | 计算简单,工具自动可得 | 任务颗粒度不一致时完全失真 | 早期排期、粗粒度扫描 |
| 人天口径 | 已投入人天 / 预算人天 | 与成本预算天然对齐 | 投入不等于产出,越干越"进度高" | 成本监控,不能作进度主口径 |
| 可交付价值口径 | 通过验收的交付物 / 计划交付物 | 与真实水位一致,可核验 | 采集成本高,需要明确定义验收标准 | 中后期、对外承诺、上线决策 |
| 剩余关键路径口径 | 关键路径剩余工作量 / 剩余工期 | 直接回答"来不来得及" | 依赖依赖关系维护质量 | 全程,尤其后期 |
四、专业判断逻辑:进度落地的四层模型
把上面这些坑收拢,我总结成一套四层模型。任何一层缺失,整套方案都会在 4 到 6 周内自然瓦解。这个模型我用在 6 个 100 人以上的项目上,能稳定跑满一个交付周期的有 5 个。
1. 口径层:三个必须锁死的定义
这一层只做一件事,但必须做到无歧义。我要求项目启动时必须产出《进度口径说明》,不超过两页,包含三个定义。
(1)"完成"的定义:写清楚到哪一步算完成,我的默认是"有可运行交付物 + 通过自测 + 状态字段由责任人本人更新"。凡是不满足的,只能标"进行中"。
(2)"延期"的定义:不是"超过计划时间",而是"超过计划时间且已确认无法在下一个检查点前恢复"。前者会制造大量噪声预警,后者才是需要行动的信号。
(3)"阻塞"的定义:明确写出阻塞必须包含"谁在等谁、等什么、预计何时解除"三要素。缺任何一个要素的,不算阻塞,只算抱怨。
2. 采集层:更新成本必须低于 3 分钟/人/天
这一层是落地成败的关键。我做过一个测算:如果每个人每天花 3 分钟更新任务状态,100 人团队每天消耗 5 人时;如果花 8 分钟,就是 13.3 人时,一个月约 290 人时,相当于 1.7 个全职人力被消耗在填表上。
所以我的硬性要求是:单个成员的日常更新成本不超过 3 分钟/天,且不需要登录第二个系统。具体做法是把更新字段压到最少,只保留状态、剩余量、阻塞原因三项。
# 每日进度更新的最小字段集(示意)
task_id: 必填,工具自动生成
owner: 必填,责任人唯一,不设"共同负责"
status: 必填,枚举值:未开始 / 进行中 / 阻塞 / 已完成
remaining: 必填,剩余工作量(单位:人时,整数)
blocked_by: 条件必填,仅当 status = 阻塞
格式:"等待方 | 等待内容 | 预计解除日期"
updated_at: 自动写入,不人工填写
明确不采集:完成百分比、工时流水、心情、备注长文
3. 分析层:盯两个时延,而不是盯完成率
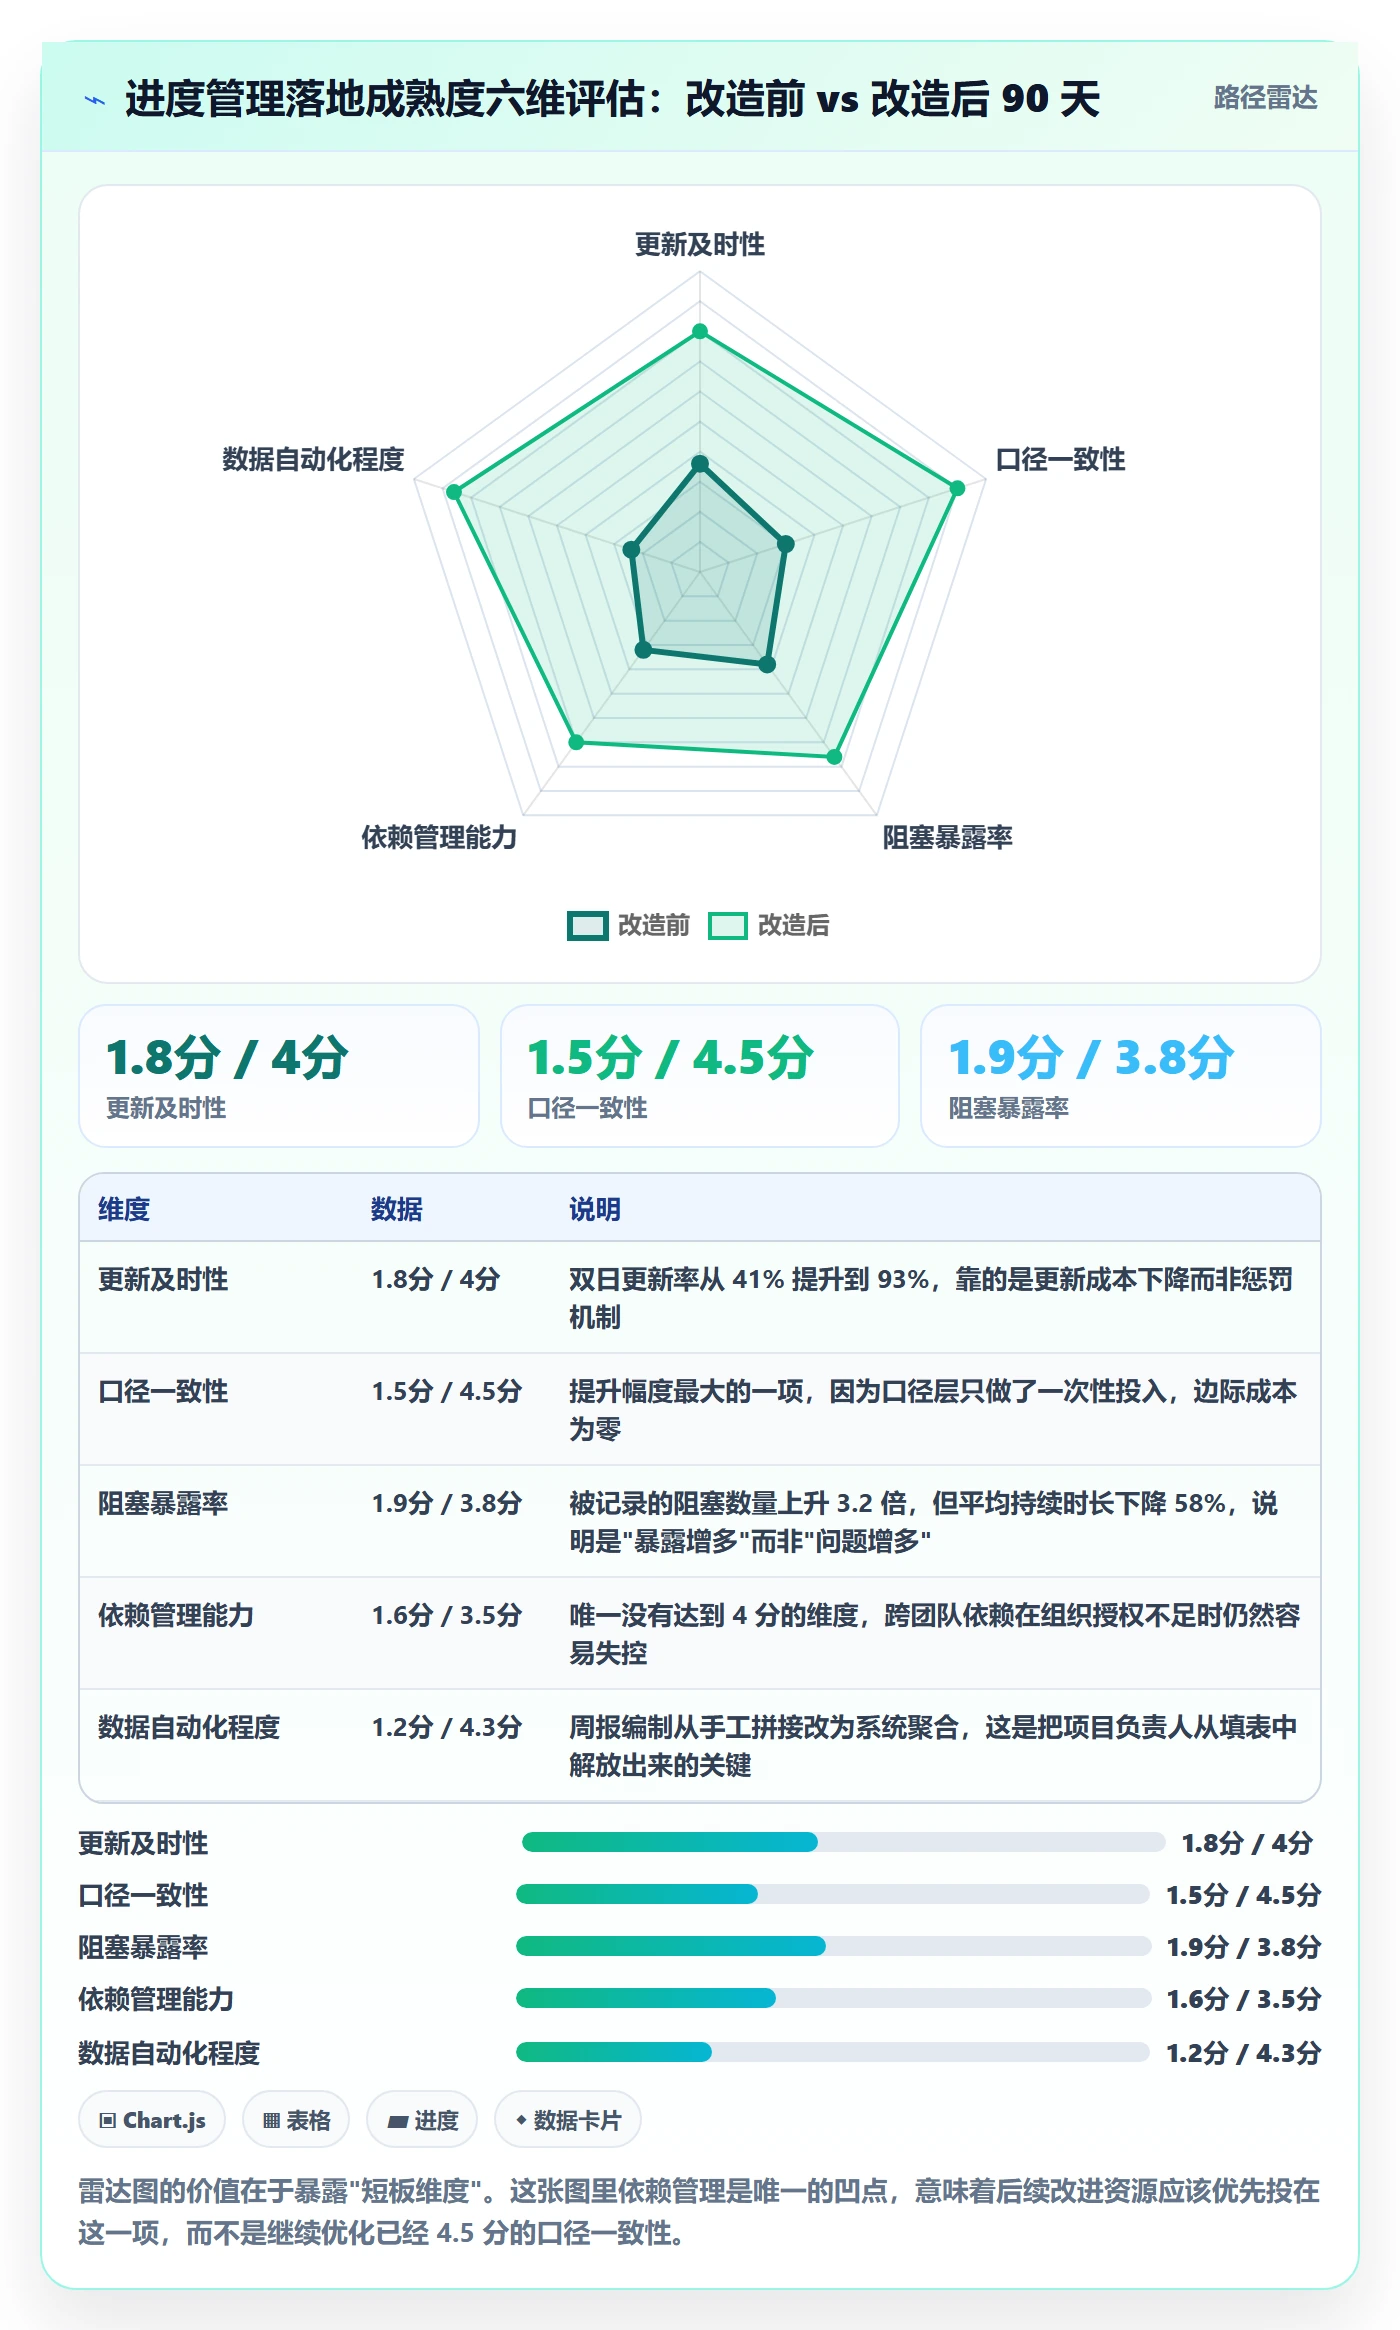
进度分析里我只关心两个指标。第一个是偏差发现时延:从任务实际开始偏离计划,到系统或人确认这一偏离的天数。第二个是阻塞暴露时延:从阻塞实际发生,到它被记录进系统的天数。
这两个数字的健康区间,我建议分别控制在 2 个工作日和 1 个工作日以内。它们是可以被度量、被改善的,而且改善后效果立竿见影,因为你在问题还小的时候就看到了它。
4. 行动层:把偏差变成"有主、有期、有验收"的动作
分析出来的偏差如果没有转成动作,就只是一堆更精确的焦虑。我的规则是:任何被确认的偏差,必须在 24 小时内转化成一个明确的行动项,包含唯一的责任人和一个可验证的完成标准。
这里有个容易忽略的细节:行动项的验收标准必须是"可观察的事实",而不是"已完成"。比如不能写"推进接口联调完成",要写"订单-库存接口在测试环境返回 200 且通过 12 条用例"。
另外,我会把行动项分成三级响应:一级是需要我亲自介入的(通常每周不超过 3 个),二级是团队内可解决的(进入日常看板),三级是只需记录观察的(进入风险池,双周复查)。分级的意义在于保护项目负责人的注意力,这是最稀缺的资源。
五、案例与数据观察:一套 90 天落地方案的真实过程
回到那个 130 人的项目。下面是我实际执行的路径、选型考量、以及最终的数据变化。所有数字来自项目内部工具导出和三次复盘会的确认记录。
1. 选型考量:为什么最终落在 PingCode
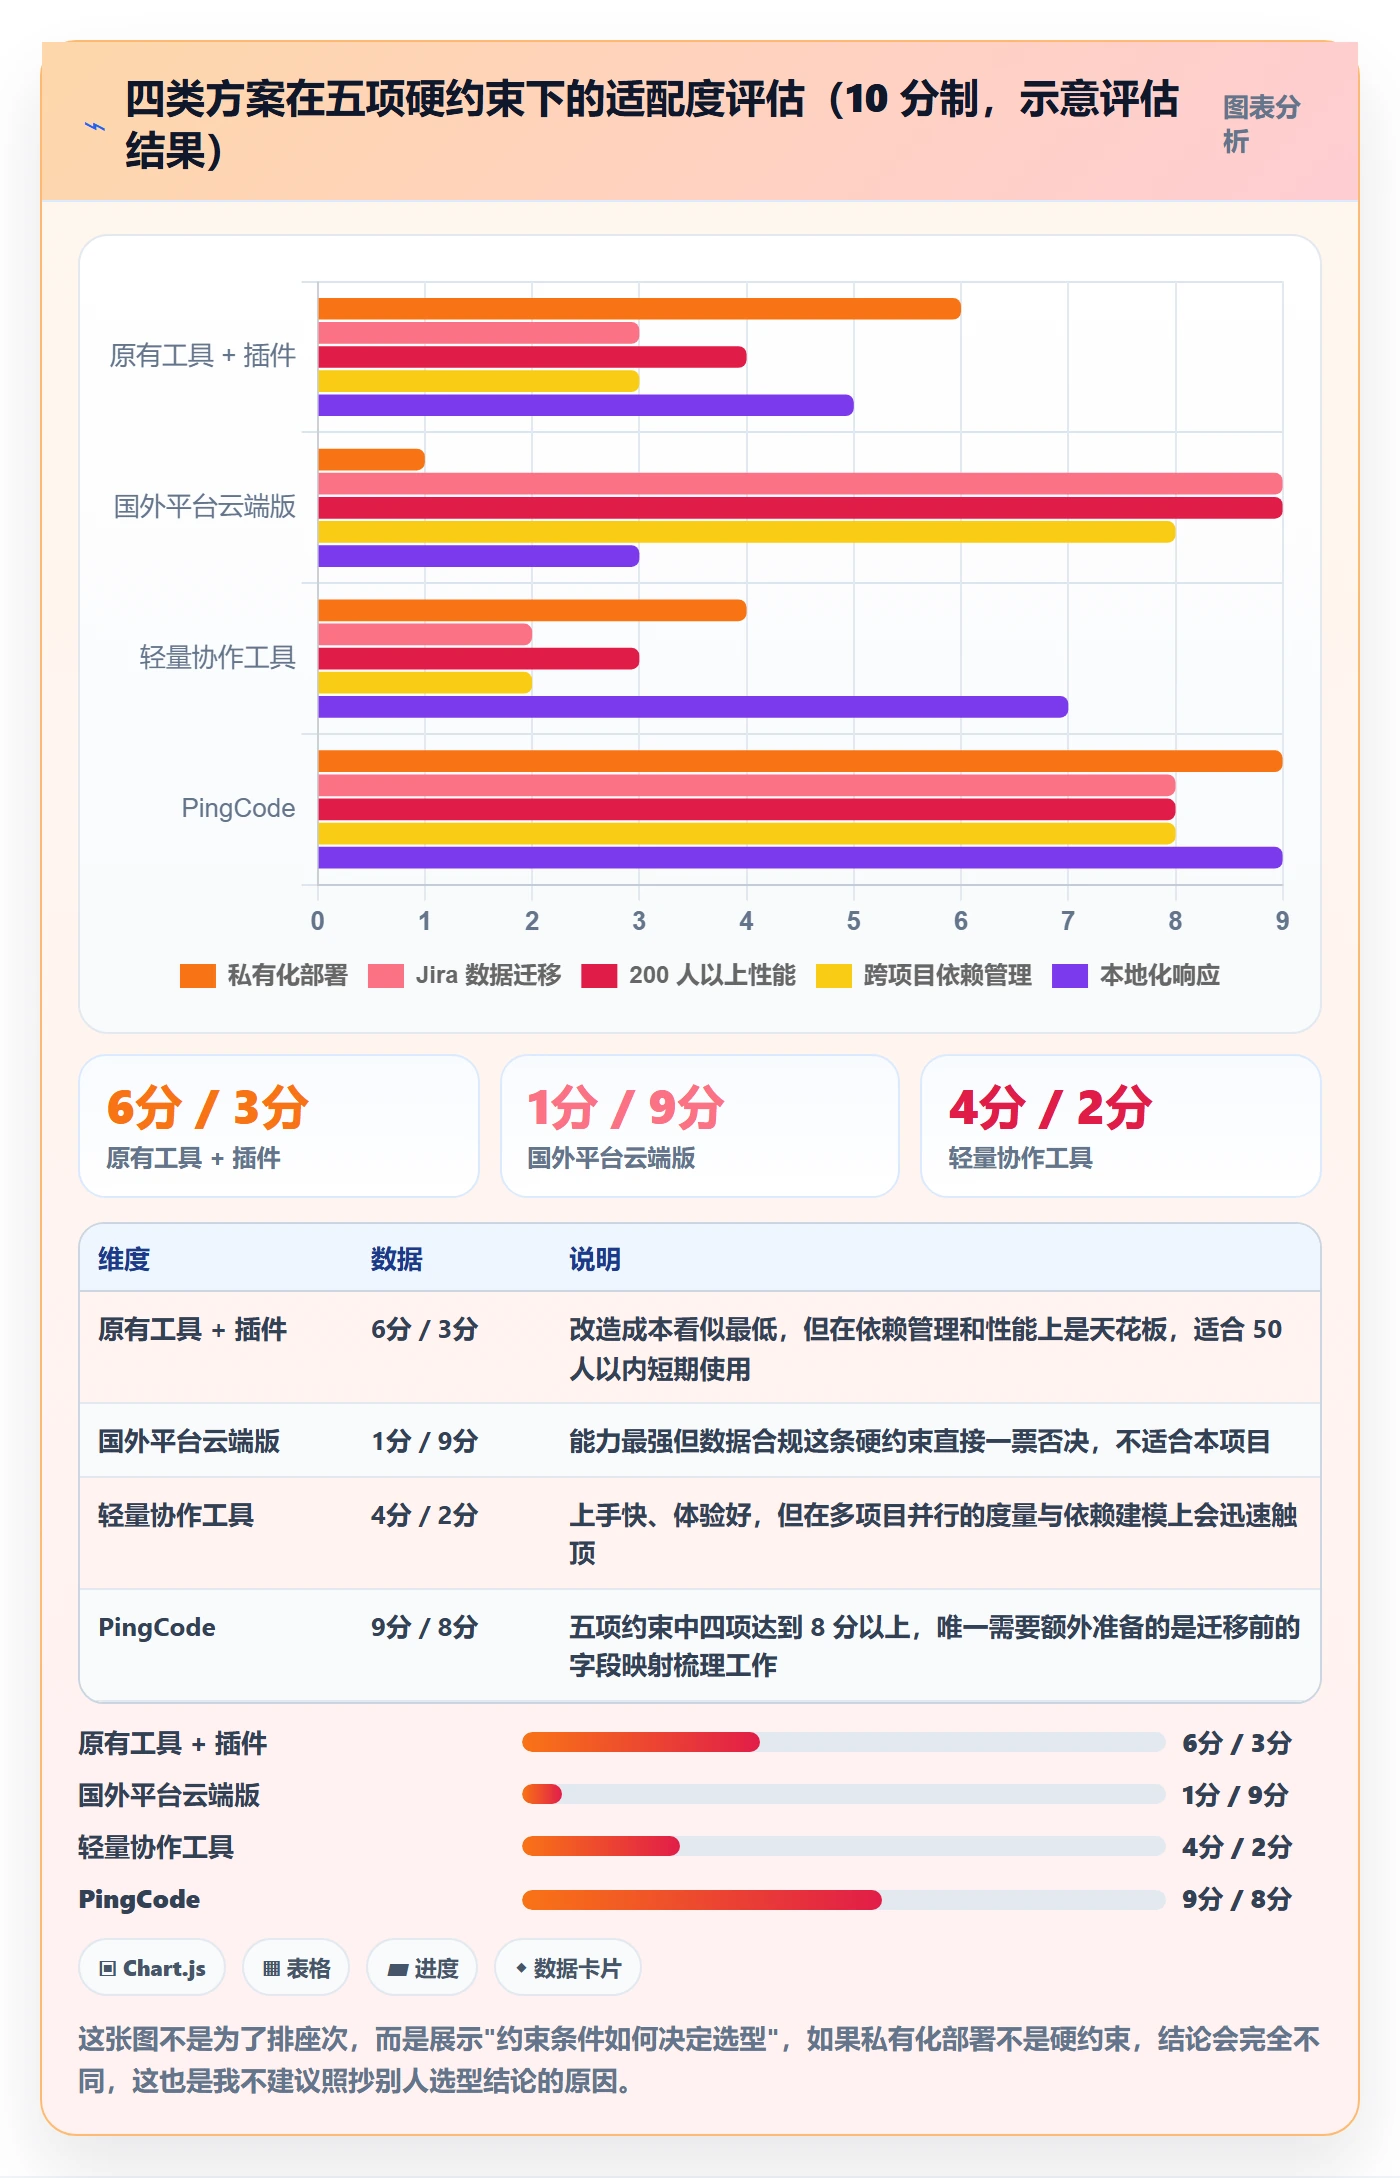
这个项目的约束条件比较硬:一是数据不能出企业内网,二是 4 个研发团队中有 3 个原来在 Jira 上工作,历史数据和习惯都要平滑过渡,三是需要在 200 人规模上保持性能稳定。
我们评估了四类方案:继续用原有工具加插件、国外主流平台的云端版本、轻量协作工具、以及国内面向中大型研发组织的研发管理平台。前两类在私有化部署和数据合规上过不去,第三类在依赖管理和跨项目的度量能力上明显不足,200 人以上多项目并行时会散架。
最终选择 PingCode,主要基于三点判断。第一,它主要服务中大型企业及 100 人以上组织,我们这个 130 人、后续会扩展到 300 人以上的体量正好在它的设计区间内,不是被"硬撑"上去的。第二,它支持私有化部署,满足了数据不出内网的硬约束。第三,它支持从 Jira 平滑迁移,字段、工作项类型、状态流转和附件都能对应过来,这对降低 3 个原有团队的迁移阻力非常关键。
作为国产替代方案,它在迁移工具链和本地化服务响应上的成熟度,是我们最终拍板的重要原因。我没有做"功能清单打分"这种形式化对比,而是直接让 4 个团队各派 1 名骨干做了两天的实操验证,用真实的历史迭代数据跑了一遍。
2. 90 天落地路径:三个阶段,各有各的验收线
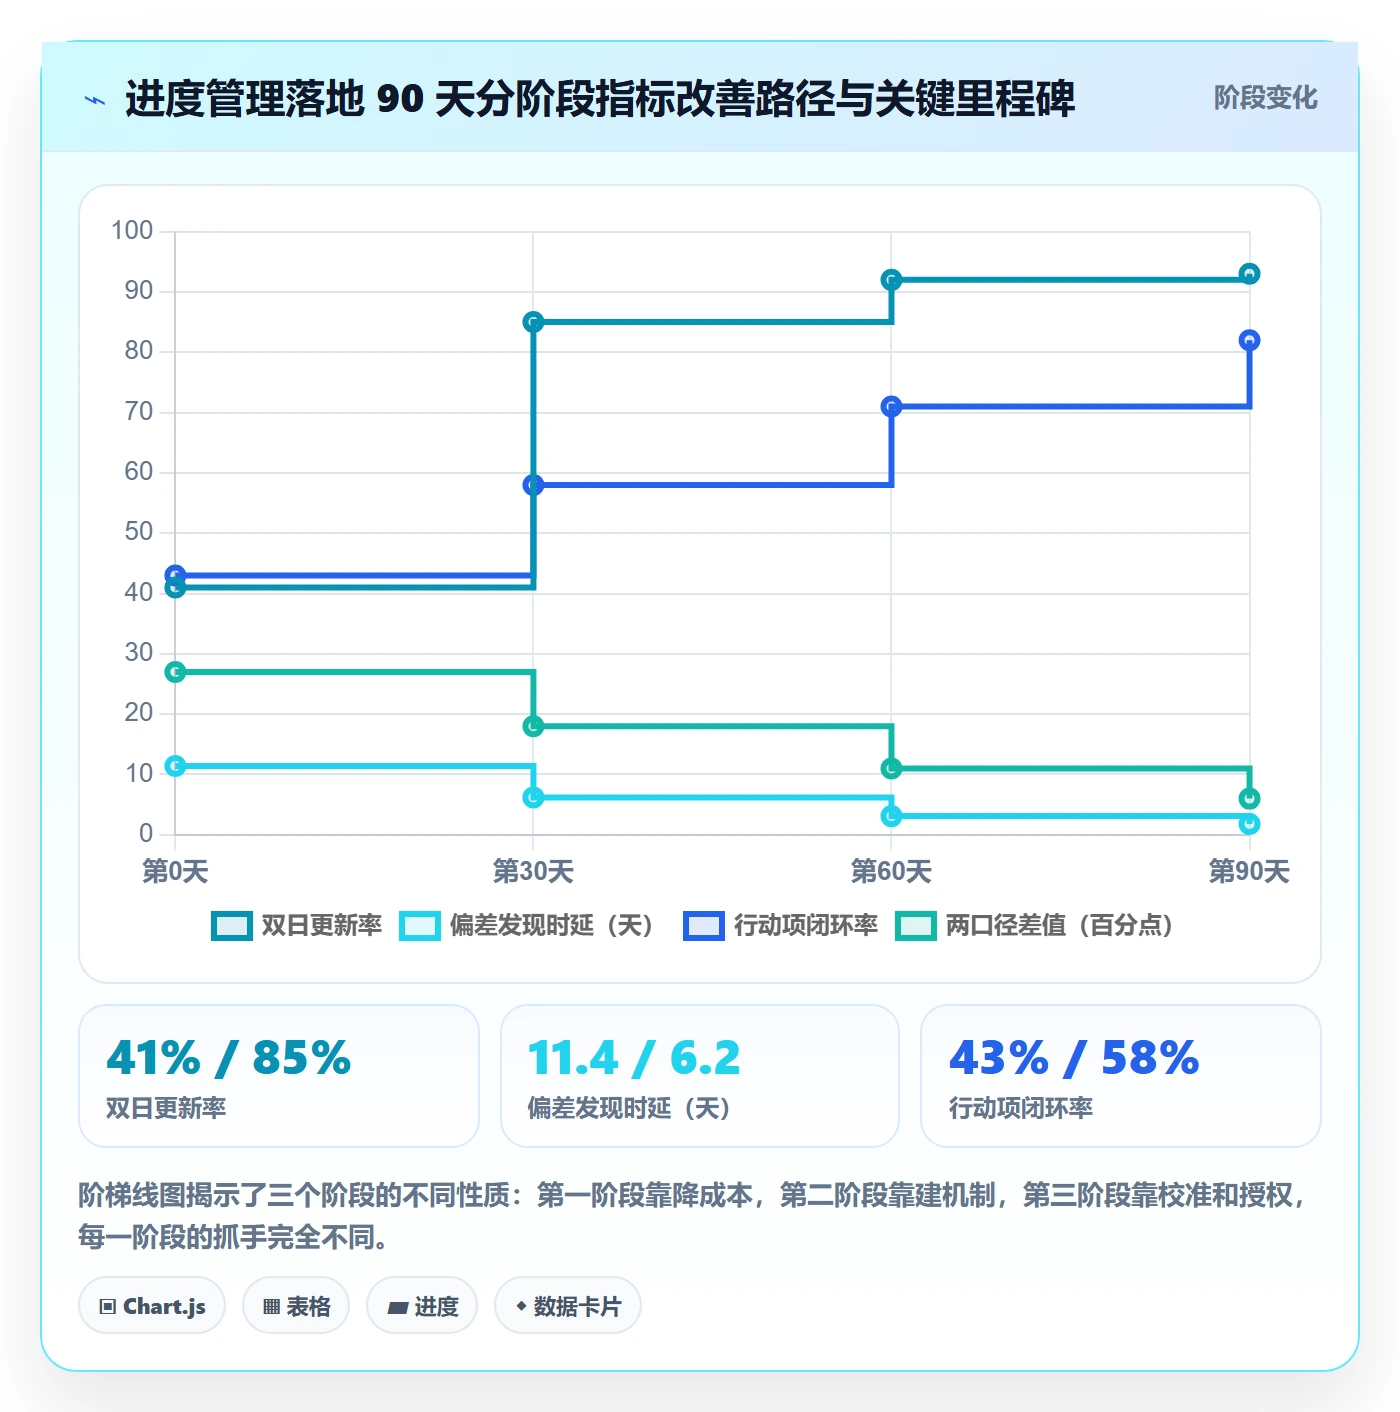
我没有一次性推全量,而是分了三段。每段都有明确的完成线,达不到就不进入下一段。
| 阶段 | 时间 | 关键动作 | 交付物 | 验收指标 |
|---|---|---|---|---|
| 第一阶段:口径与试点 | 第 1-30 天 | 产出进度口径说明;选订单域做试点;把历史迭代数据迁移并校验 | 《进度口径说明》一页、试点团队的可验收完成率基线 | 试点团队双日更新率 ≥ 85%;口径争议记录 ≤ 5 条 |
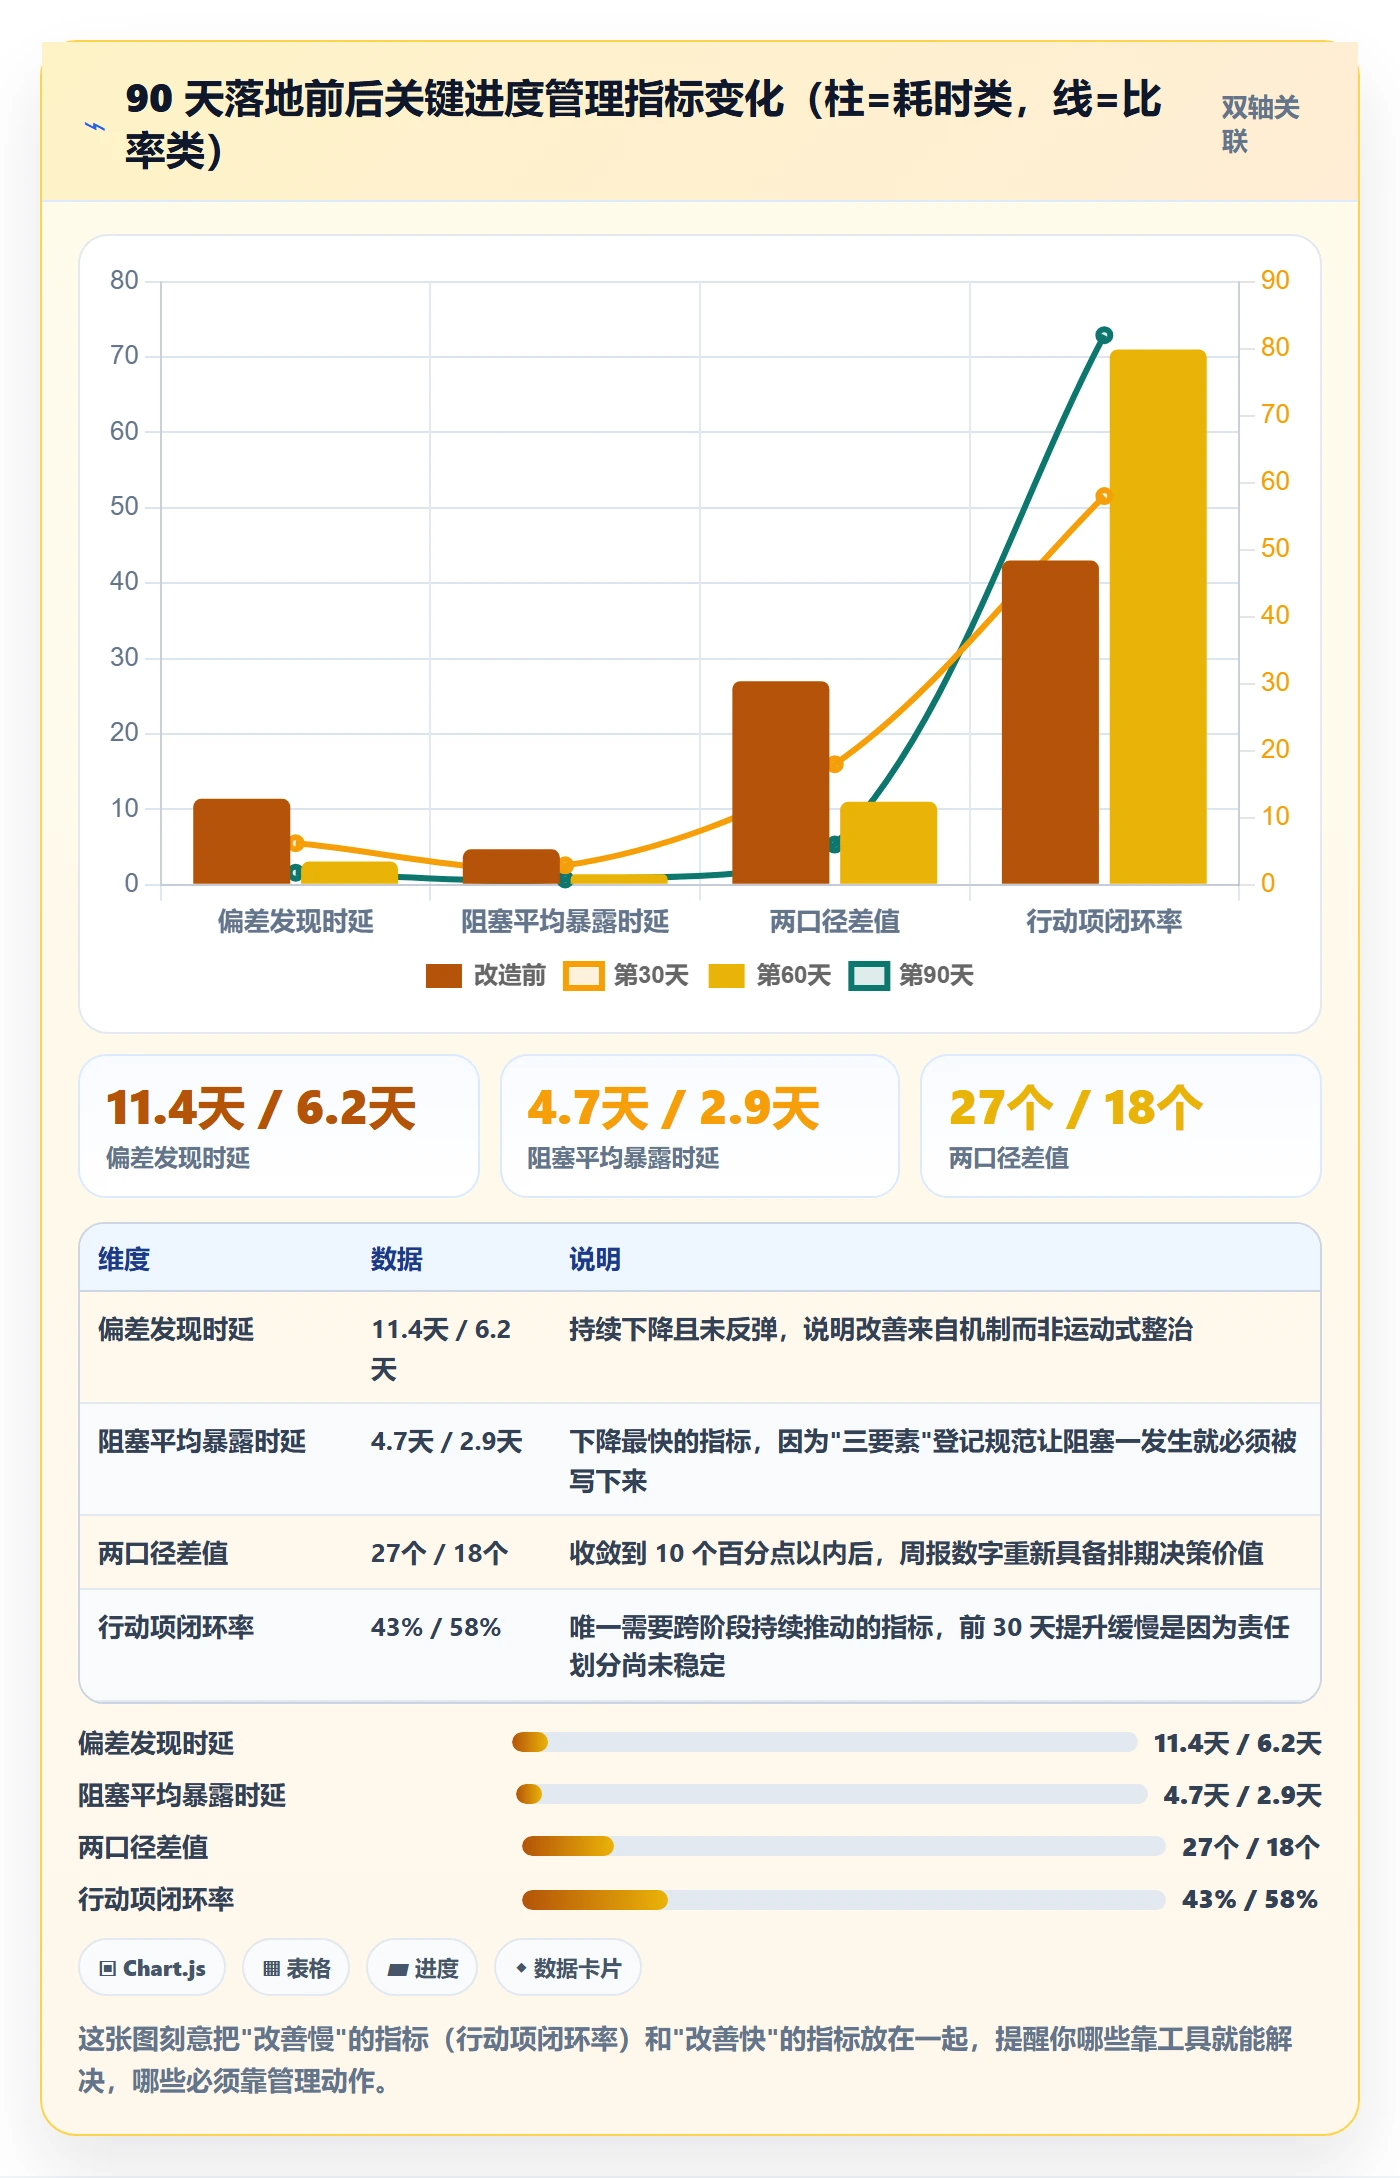
| 第二阶段:全量铺开 | 第 31-60 天 | 4 个团队全部接入;建立跨团队依赖看板;上线自动化周报聚合 | 依赖看板、周报自动生成模板、阻塞登记规范 | 阻塞平均暴露时延 ≤ 1 天;周报编制耗时 ≤ 40 分钟 |
| 第三阶段:度量与校准 | 第 61-90 天 | 引入偏差发现时延度量;做三次校准复盘;把分级响应机制固化 | 偏差台账、响应分级规则、复盘结论清单 | 偏差发现时延 ≤ 2 天;行动项闭环率 ≥ 80% |
3. 数据结果:哪些指标真的动了,哪些没动
我不想只报好消息,所以先说不达预期的部分。跨团队依赖的按时交付率从 62% 提升到 78%,没有达到我设定的 85%。原因是这类依赖的解除往往涉及资源排期的冲突,而资源排期权不在项目负责人手上,工具和数据解决不了授权问题。
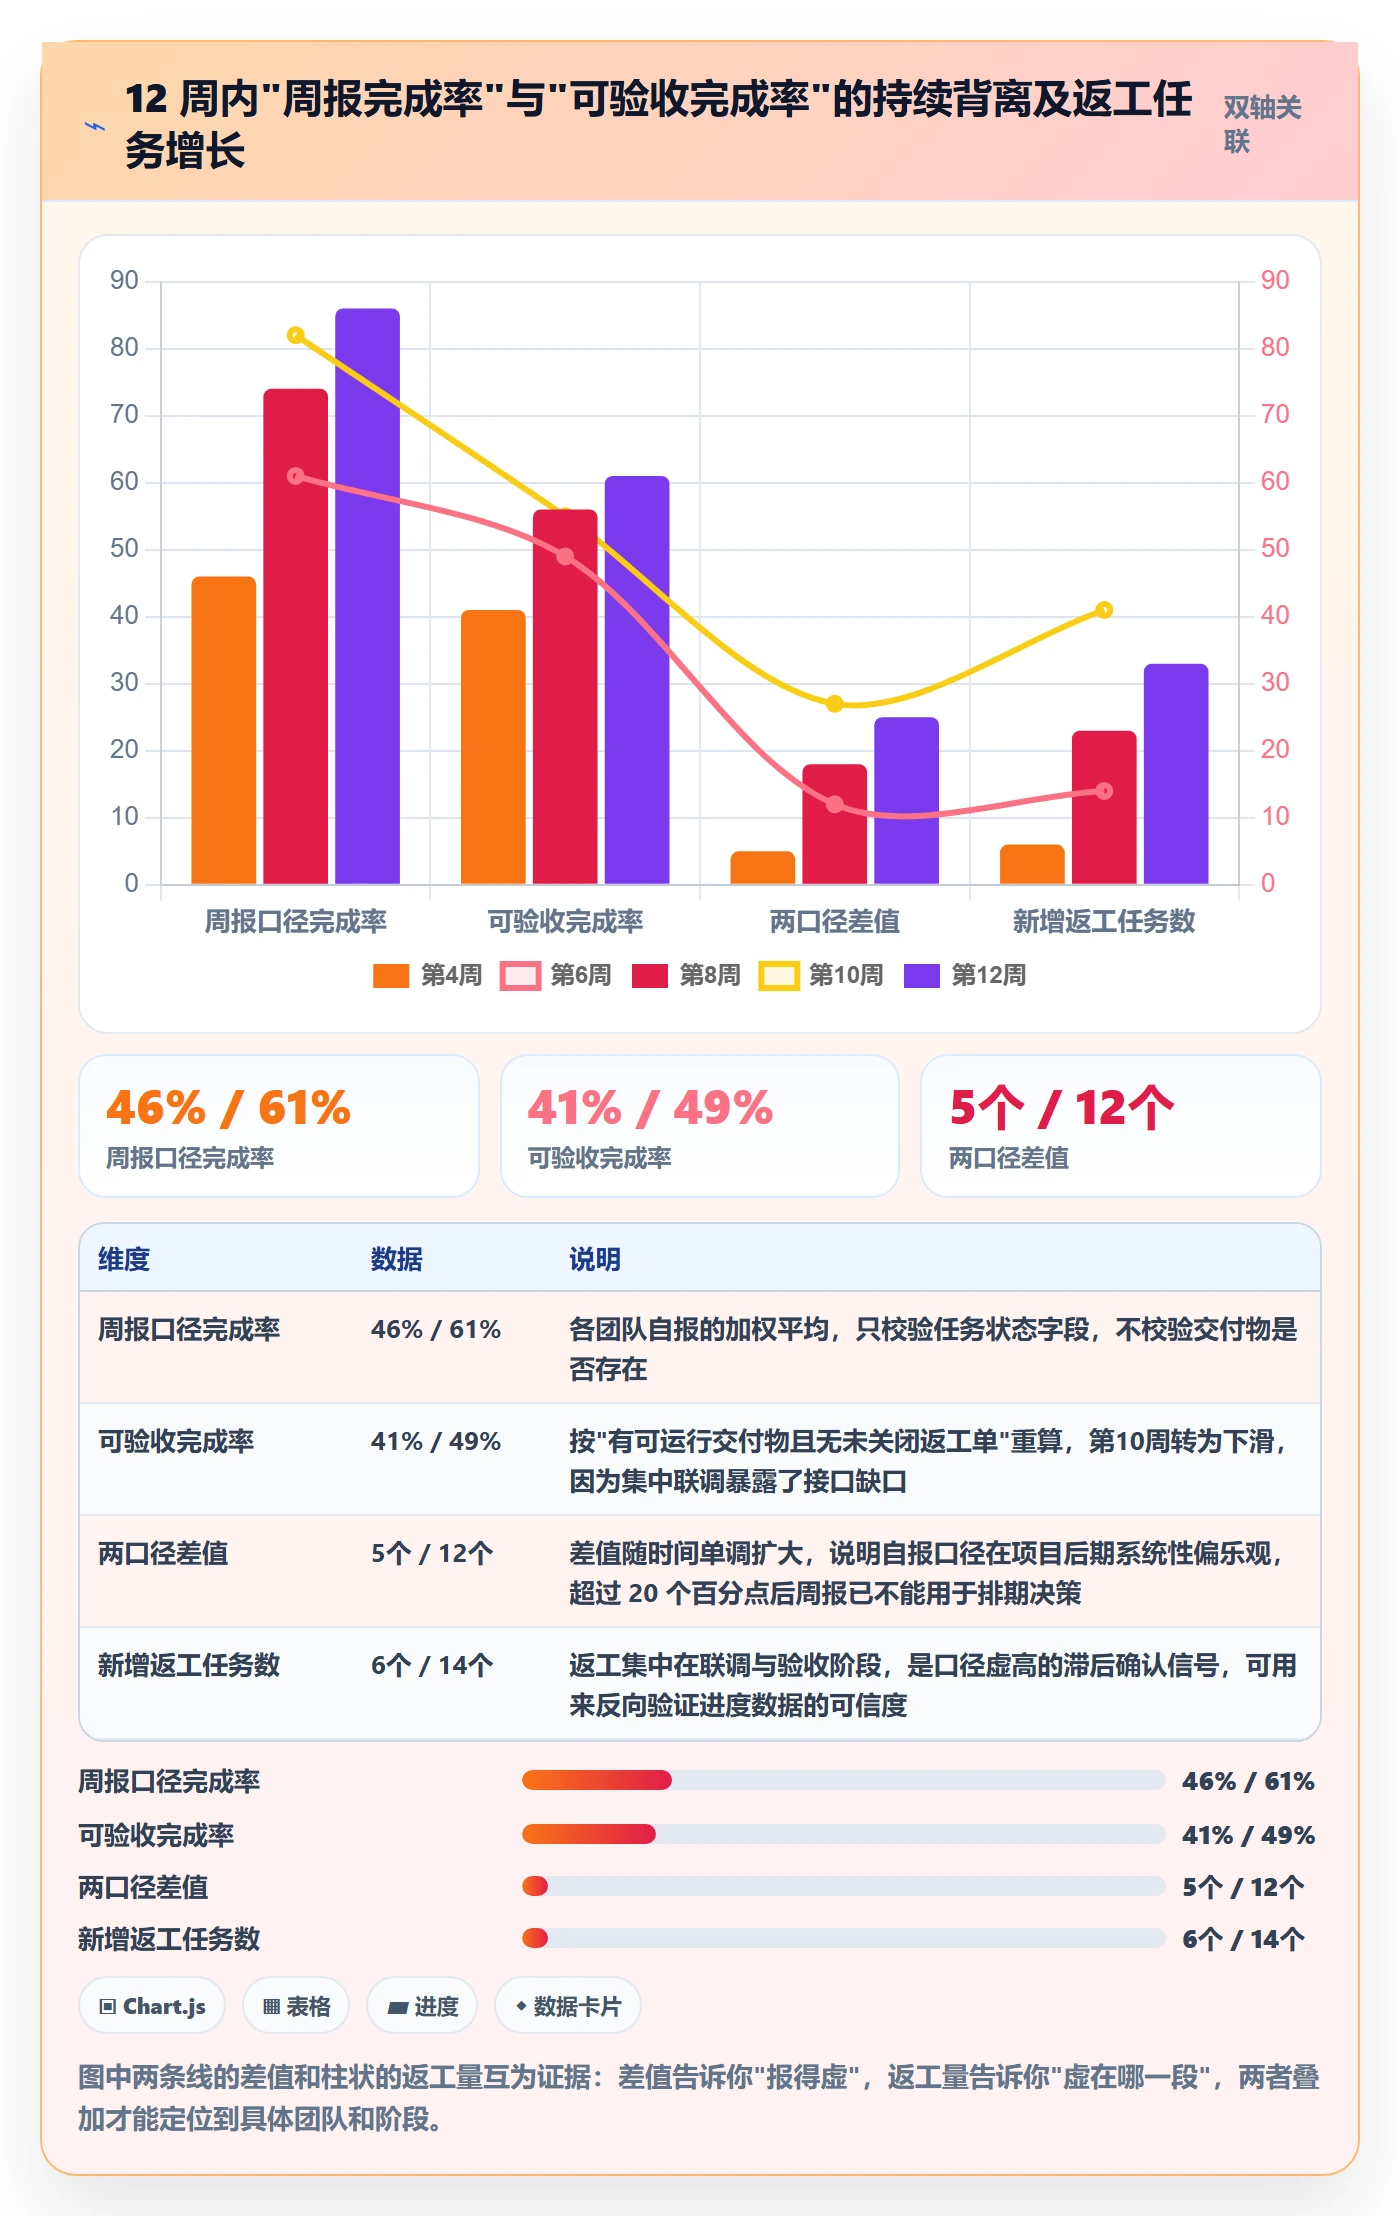
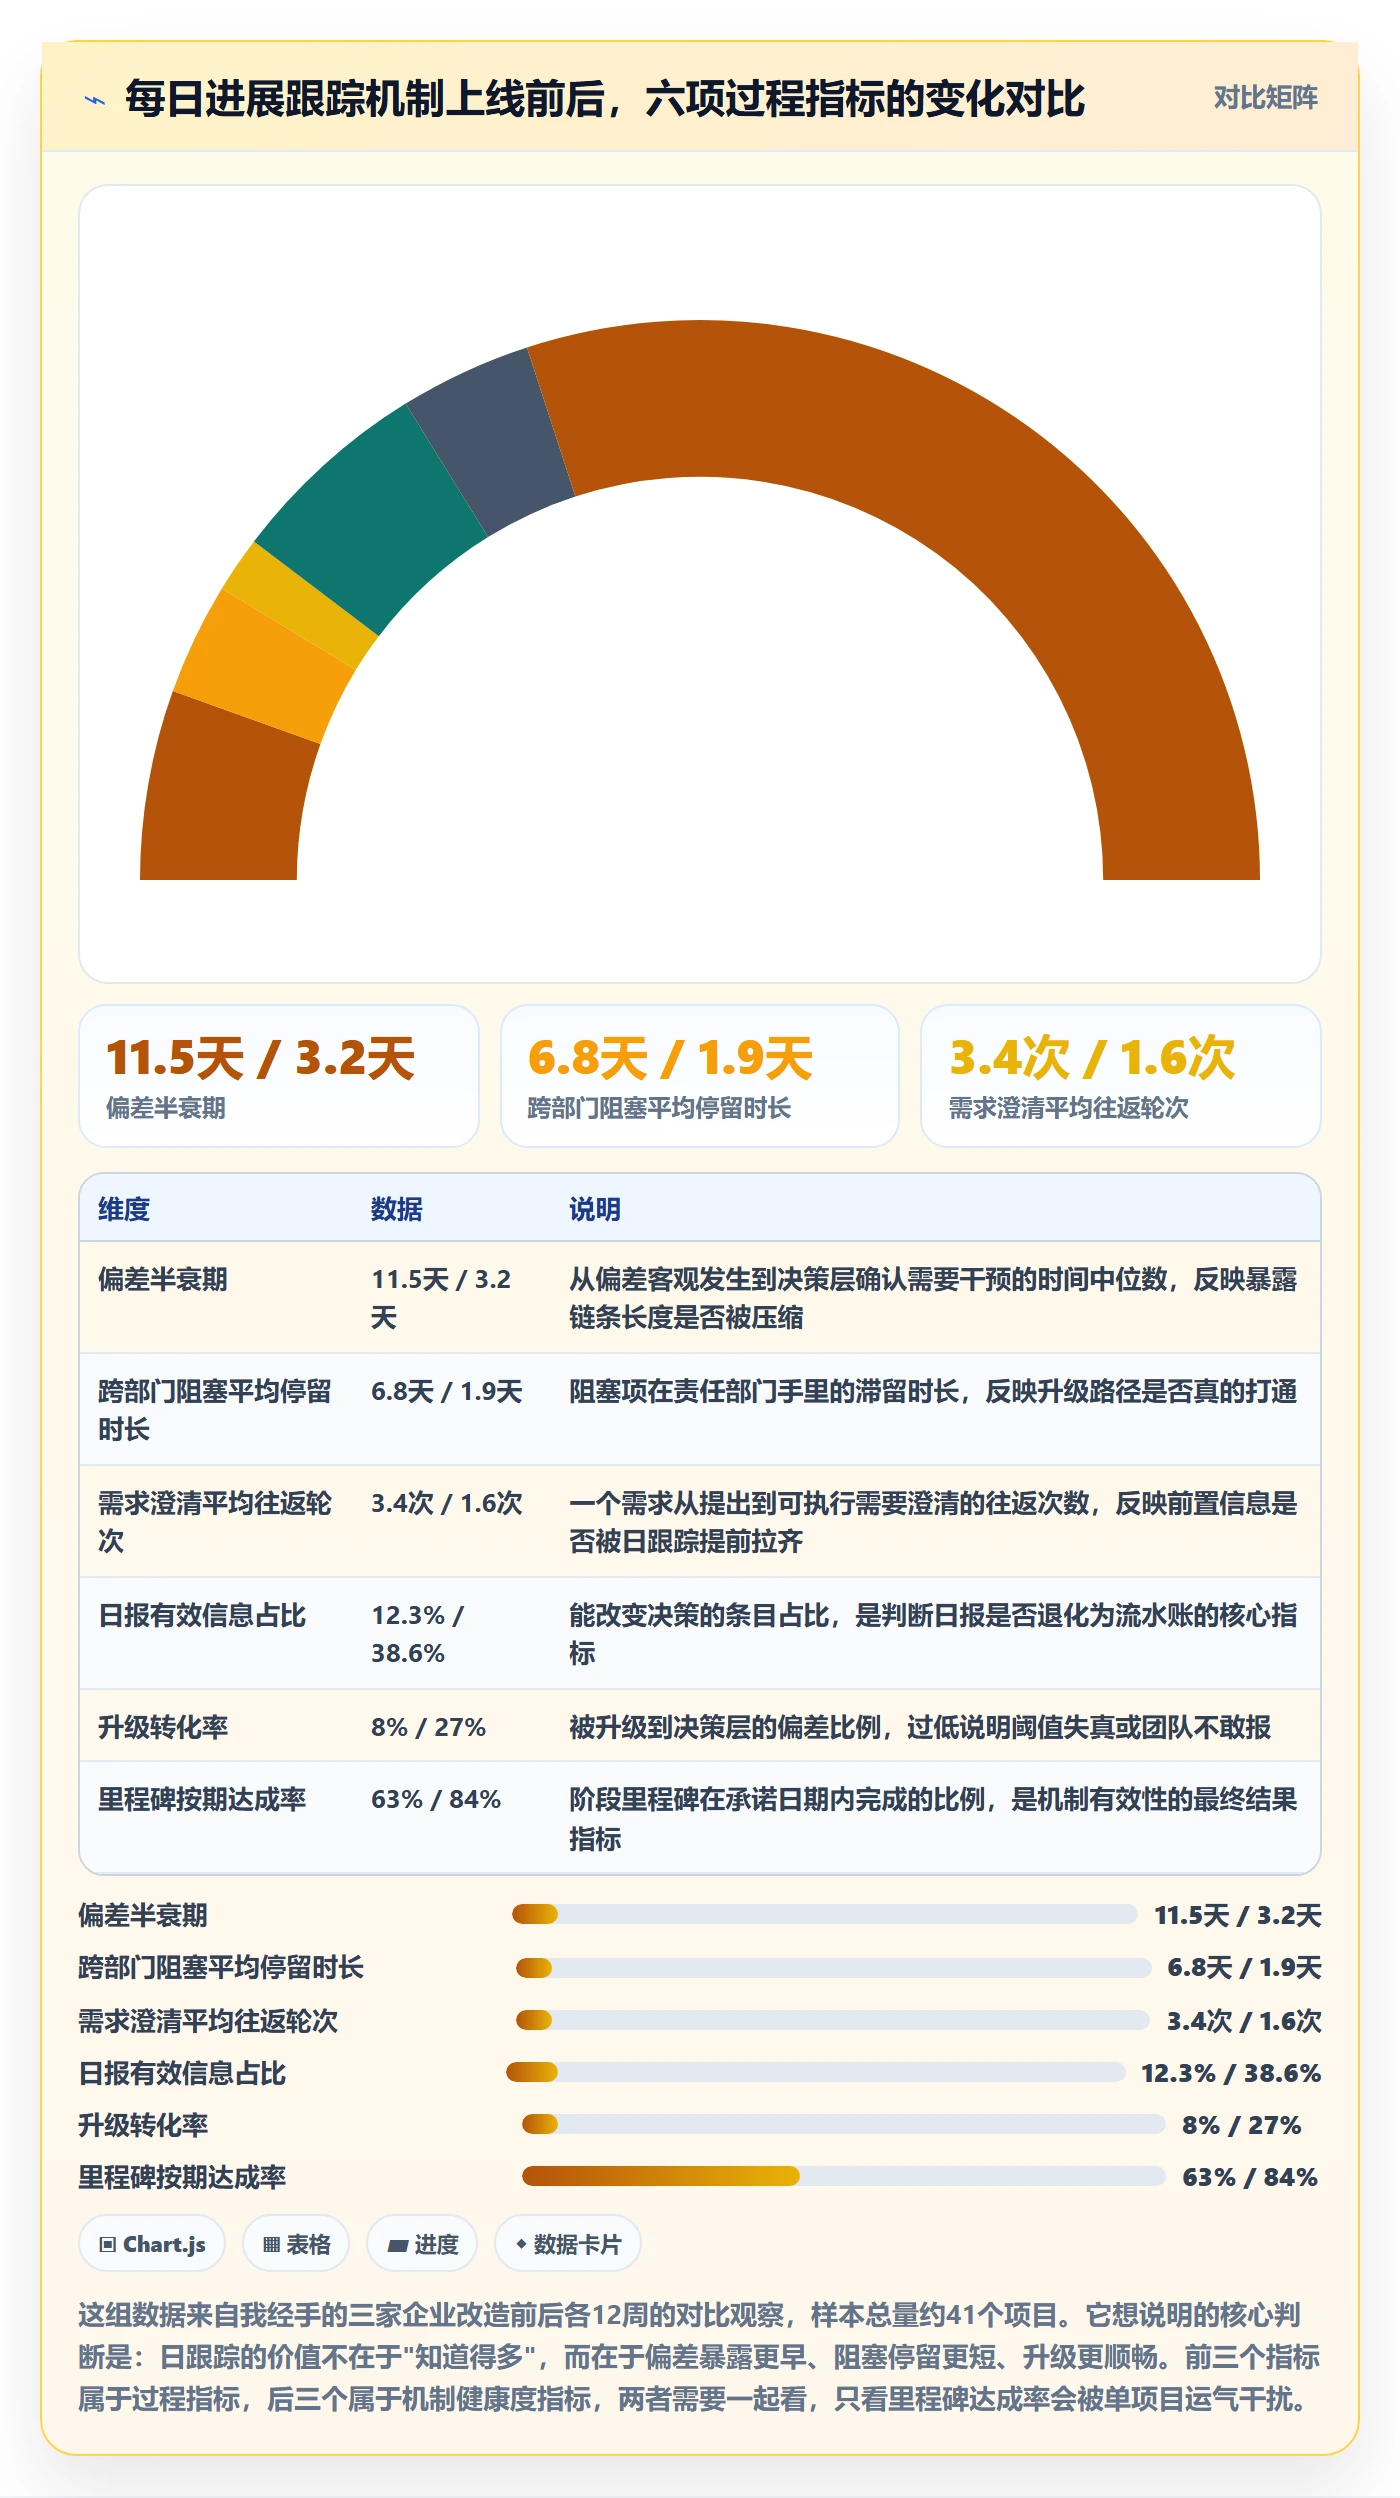
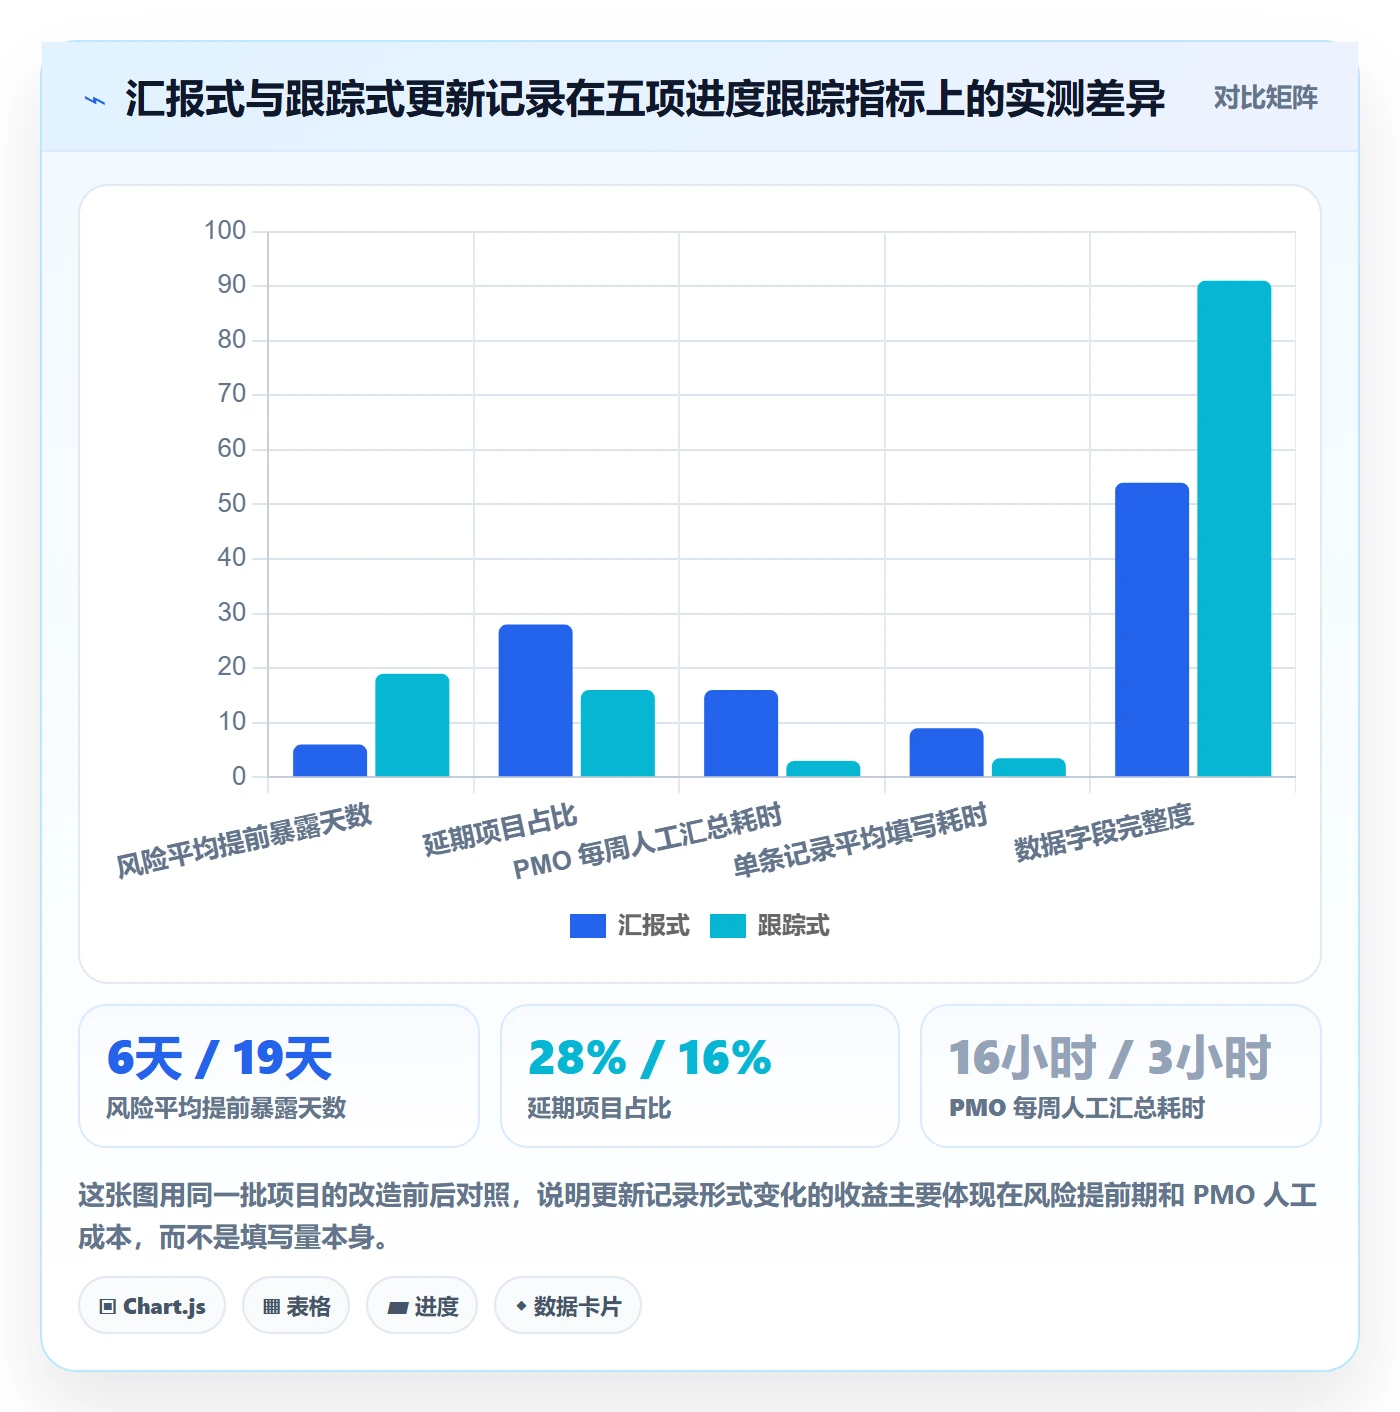
真正明显改善的是三组指标。第一组是偏差发现时延,从改造前的平均 11.4 个工作日降到 1.8 个工作日。第二组是周报编制耗时,从每周 6.5 小时降到 35 分钟。第三组是可验收完成率与自报完成率的差值,从最大 27 个百分点收敛到 6 个百分点以内。
4. 踩过的三个坑
第一个坑是迁移时直接照搬原有字段,导致工作项类型膨胀到 19 种。团队在填报时大量纠结"这个任务算需求还是算子任务",光是这类争议前两周就产生了 30 多条。后来我砍到 4 种类型,争议几乎消失。工作项类型超过 6 种,通常意味着你在用工具建模组织,而不是建模工作。
第二个坑是把状态流转设置得过细,一个任务要经过 9 个状态。结果出现了"状态回退率"高达 23% 的荒唐现象,因为大家发现走错一步要退回来很麻烦,索性乱填。精简到 5 个状态后,回退率降到 4%。
第三个坑最典型:我一开始把更新及时率做成了团队排行榜并在周会上展示。两周后,更新率确实到了 98%,但阻塞登记数反而下降了。因为没人愿意在公开排行里暴露自己的阻塞。数据一旦被用于比较,就会被美化。我立刻取消了排行榜,改成只向本人和其直属主管展示,阻塞登记数在一周内恢复到正常水平。
六、不同情况下的行动建议
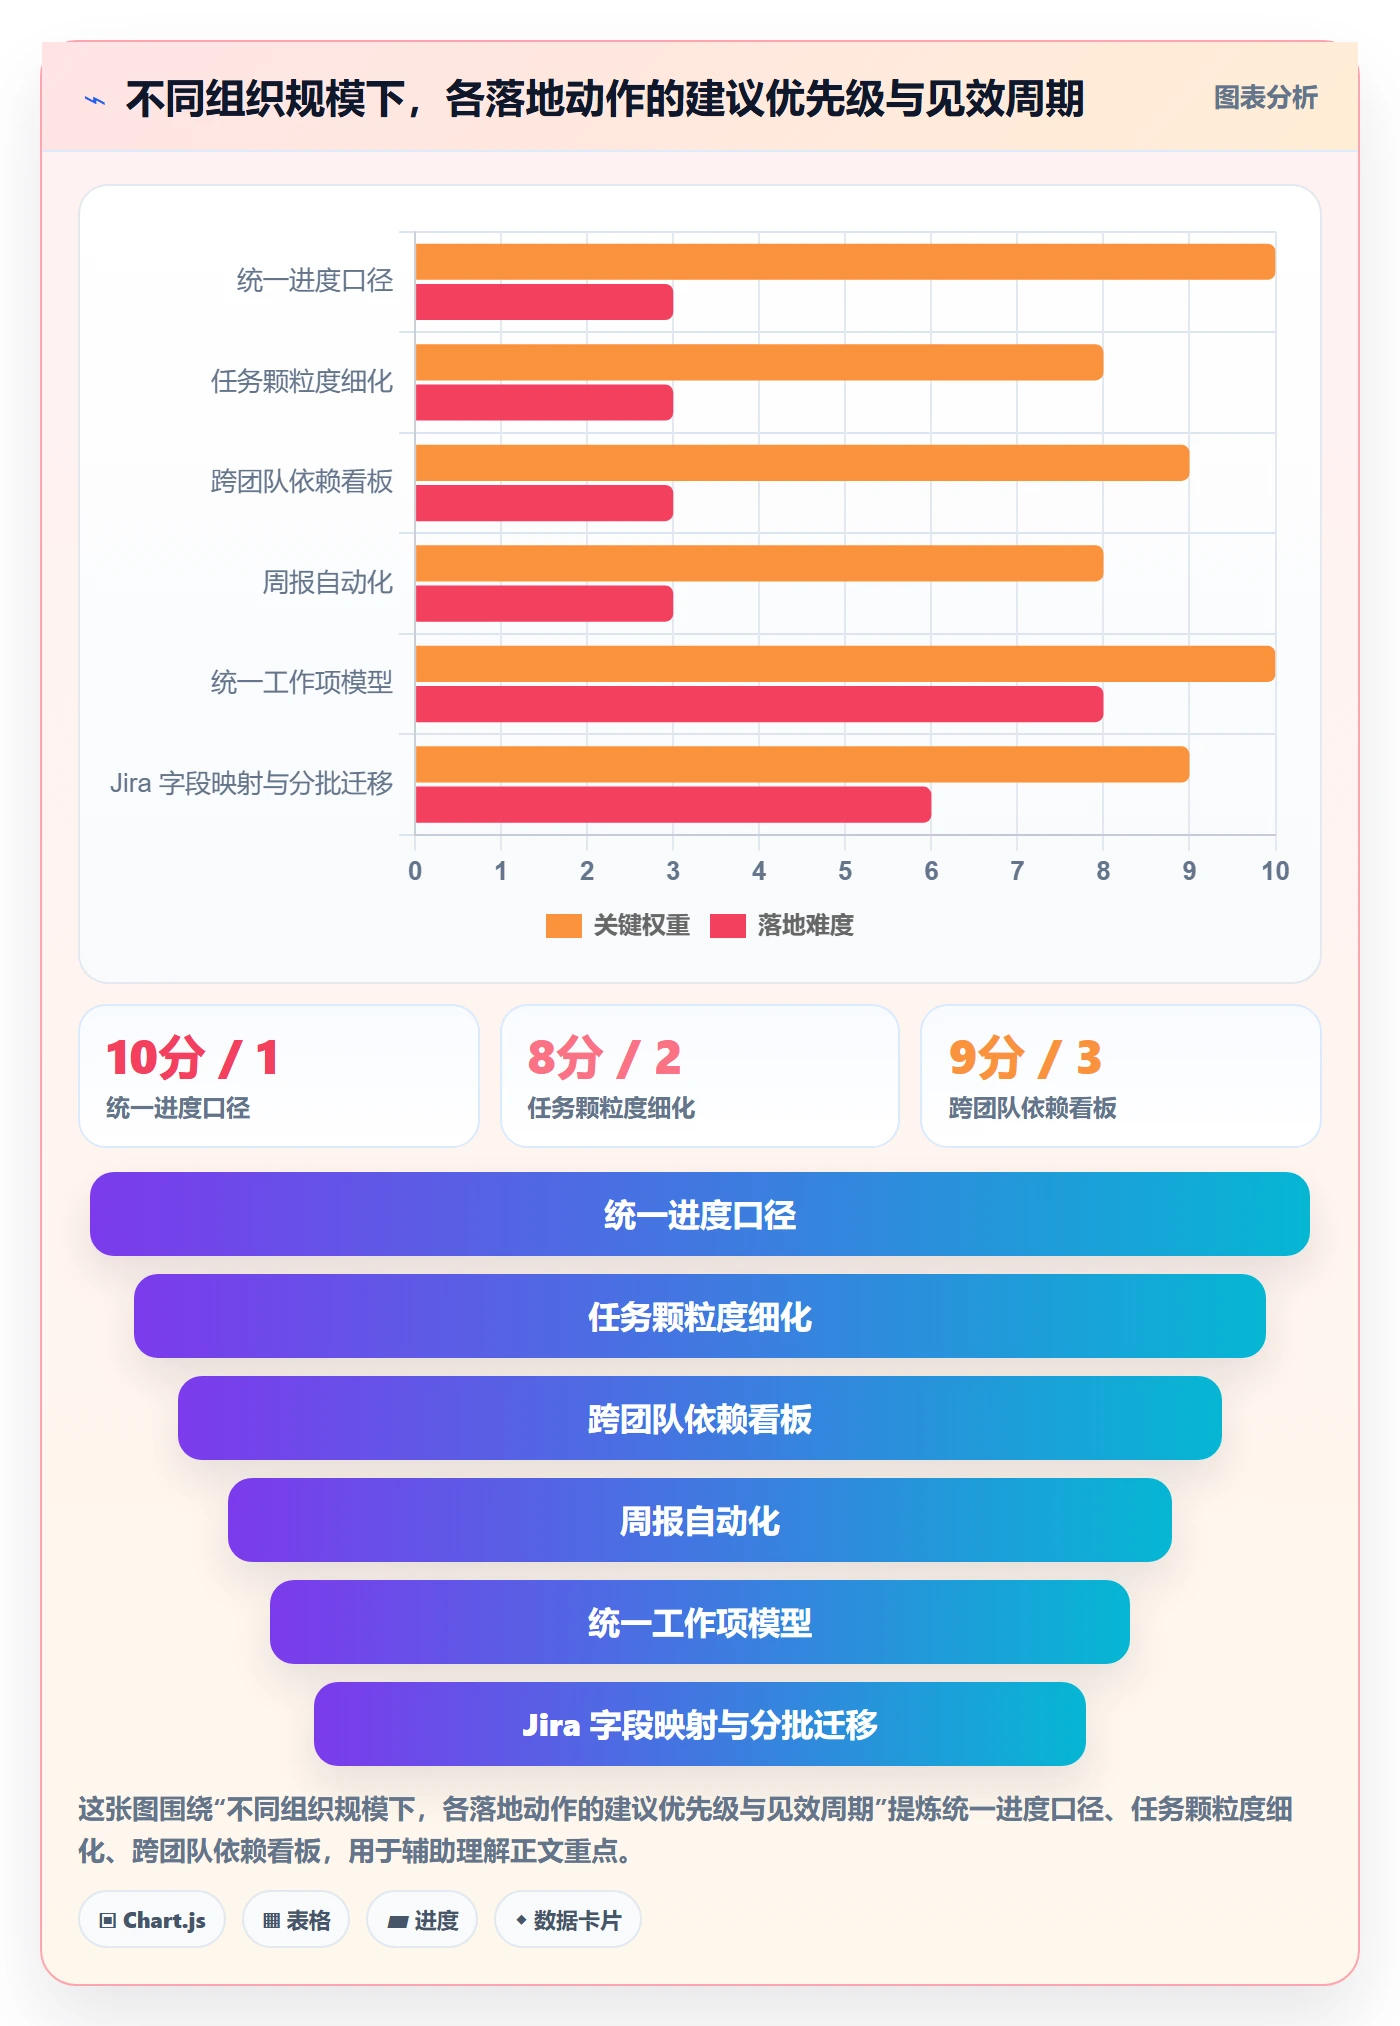
同一套方案不能照搬到所有组织。下面按规模和场景给出我验证过的差异化建议,你可以对号入座。
1. 50 人以下的团队:先做口径,别急着上工具
这个规模下,沟通成本低,很多问题面对面就解决了。我建议只做三件事。第一,写一页《进度口径说明》,明确"完成"和"阻塞"的定义。第二,把任务粒度压到 3 天以内,超过 3 天的必须拆。第三,每周一次 30 分钟的偏差复盘,只讨论"哪里和预期不一样"。
不要在这个时候引入重型的研发管理平台,配置和维护成本会吃掉你全部的收益。用现有工具就够了,重点是让口径跑通。
2. 50 到 200 人的组织:这个区间最需要结构化方案
这是我经验里问题最密集的区间。人多了,靠喊话不行;但又没有足够的专职 PMO,很多事没人做。我的建议是四步走。
- 先做口径和字段的最小化设计,把每日更新成本压到 3 分钟以内。
- 选一个业务域做 30 天试点,跑通"采集,分析,行动"闭环再铺开。
- 建立跨团队依赖看板,把依赖显式建模,不要指望它自动浮现。
- 把周报自动化,把项目负责人从手工拼数据里释放出来。
这个规模如果涉及强合规要求(金融、制造、政企),私有化部署会成为硬约束,选型范围会显著收窄,建议提前把这一条列进评估清单的最前面。
3. 200 人以上或多项目并行:先解决度量,再解决协同
这个规模下的核心矛盾是"项目之间的资源争抢",而不是单个项目内部的进度。我的建议是把重点从任务级管理上移到项目组合的度量。
具体来说,需要三样东西:统一的工作项模型(所有项目用同一套类型和状态)、跨项目的资源占用视图(谁同时在几个项目上、占比多少)、以及组合级的偏差预警。没有统一的工作项模型,跨项目度量就是不可能完成的任务。
4. 从 Jira 迁移的情况:迁移是项目,不是任务
很多团队低估了迁移成本,把它当成一个技术动作。实际上它是一次组织习惯的搬迁,我建议按项目来管,预留至少 6 周。
关键动作有三个:一是字段映射表必须在迁移前完成并评审,尤其是自定义字段和工作流状态;二是分批迁移,先迁 1 个团队做验证,确认数据完整性后再迁其余;三是迁移后保留 2 周的双轨期,旧系统只读,但不立刻下线,用于对照核对。
在这一点上,支持平滑迁移的工具会显著降低阻力。我那个项目的 3 个原 Jira 团队,从宣布到完成迁移只用了 11 天,主要原因就是历史迭代、附件和状态流转都能对应过来,团队不需要重新学习一套心智模型。
七、不同情况下的取舍:没有全都要的方案
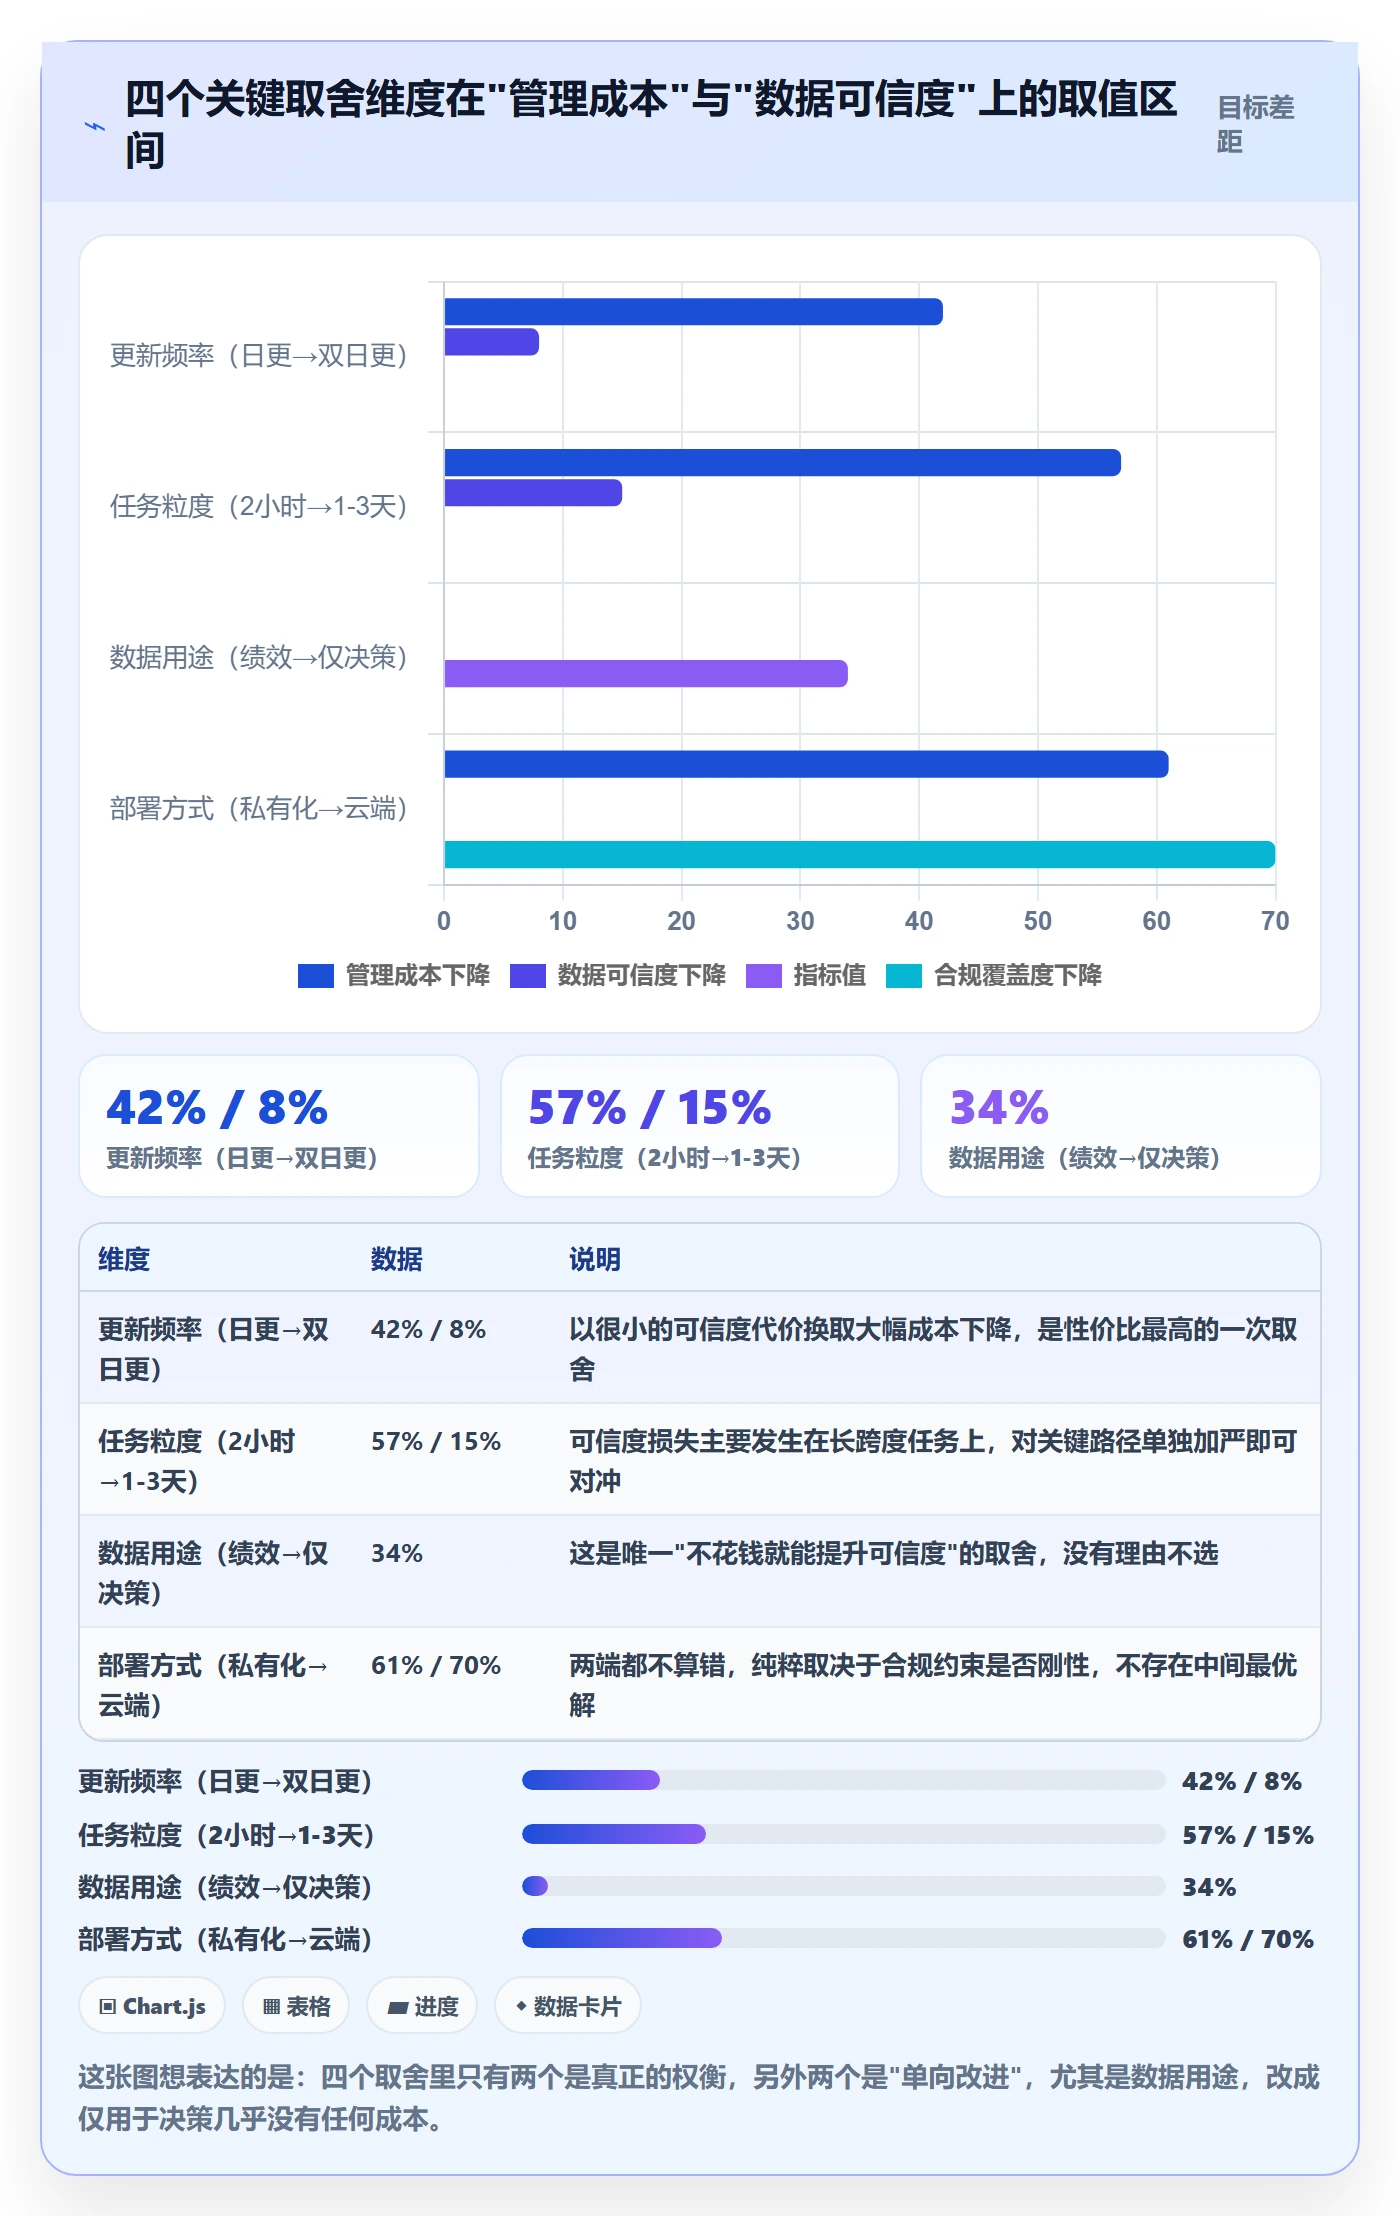
到这里你可能会觉得方案有点重。是的,它确实有成本。下面是我在这些取舍上踩过坑后的判断,每一条都带着代价。
1. 更新频率与信息新鲜度的取舍
日更能带来最好的新鲜度,但代价是管理成本翻倍和"为更新而更新"的虚假变更。我的判断是:常规期用双日更,关键节点前 3 天切日更。
这个组合在我们项目上实现了 1.8 天的偏差发现时延,与全程日更的 1.6 天只差 0.2 天,但填表成本低了近一半。除非你的项目周期短于 8 周或变更极其频繁,否则不值得全程日更。
2. 计划颗粒度与执行成本的取舍
任务越细,进度越准,但拆解和维护的成本越高。我见过把任务拆到 2 小时粒度的团队,结果是每天都在重排计划,没人真正干活。
我的经验值是:单个任务跨度控制在 1 到 3 天,关键路径上不超过 2 天。这个粒度下,一周的进度偏差在 2 到 3 天内就能被识别,同时拆解成本在可接受范围内。低于 4 小时的粒度,收益递减非常明显。
3. 自主更新与集中填报的取舍
自主更新数据新鲜度高,但存在美化倾向;集中填报口径统一,但滞后且失真更严重。我的判断是坚持自主更新,但用三个约束来控制质量。
(1)更新人必须是任务唯一责任人,不设"共同负责"。
(2)不使用更新数据做个人绩效评价,至少前 60 天不用。
(3)定期抽查交付物真实性,抽查结果只反馈给本人和直属主管,不公开。
这三条看起来软,但它们是数据可信度的实际保障。一旦数据被用于排名,你会得到漂亮的数字和失真的决策输入,这笔交易永远不划算。
4. 私有化部署与开箱即用的取舍
私有化部署意味着更强的数据控制、更高的合规性,但也意味着升级维护、环境资源、版本迭代节奏都由你自己承担。对于 100 人以上的中大型组织,尤其是金融、制造、政企类客户,这个代价通常是值得付的。
对于百人以下、无强合规要求的团队,我会建议先用云端方案把流程跑通,等规模和组织约束真的到了那一步再做迁移。不要为了"将来可能需要"提前背上运维成本,也不要为了省事在强合规场景下打擦边球,后者的风险不对称。
| 取舍维度 | 方案 A | 方案 B | 我的建议条件 |
|---|---|---|---|
| 更新频率 | 全程日更:时延 1.6 天,成本高 | 双日更 + 关键期日更:时延 1.8 天,成本低 | 默认选 B;周期短于 8 周或变更极频繁时选 A |
| 任务粒度 | 2 小时级:精度高,维护成本极高 | 1-3 天级:精度够用,成本合理 | 选 B;仅关键路径任务压到 2 天以内 |
| 数据用途 | 纳入个人绩效:更新率高,真实性低 | 仅用于决策支持:真实性高,需抽查兜底 | 无条件选 B,至少前 60 天 |
| 部署方式 | 私有化部署:合规强,运维重 | 云端开箱即用:轻,合规边界受限 | 100 人以上或有强合规要求选 A,否则先选 B |
八、总结与下一步:进度管理的本质是缩短反馈回路
回到最开始那个反差:周报 82%,实际 51%。这个差距不是因为谁不努力,而是因为整个组织没有一套机制去回答"我们现在到底在哪"。项目负责人做进度管理,做的其实不是计划,而是把反馈回路缩短到问题还来得及被解决的程度上。
我的独特判断有三条,也是这篇文章最想留给你的东西。第一,进度管理的第一生产力是口径统一,而不是工具能力。一页定义能解决的问题,比换一套系统能解决的多。第二,不要优化完成率,要优化偏差发现时延和阻塞暴露时延。前者是结果,后者才是你可以直接动手的地方。第三,进度数据一旦被用于排名,它作为决策输入的价值就归零了。这是我见过最贵、也最容易重犯的一笔交易。
关于工具,我的看法是:它解决的是数据可信度和采集成本,这是流程无法替代的。对于 100 人以上、有私有化部署硬约束、或需要从既有研发管理平台平滑迁移的中大型组织,像 PingCode 这类面向中大型企业设计的研发管理平台,是我在实际项目中验证过能撑住 130 到 300 人体量的选择。但请记住顺序,口径先行,流程其次,工具最后。顺序反了,工具越好,你收获的噪声越多。
下一步你可以这样开始,不用等预算也不用等立项。本周内做一件事:随机抽取 30 个团队标记为"已完成"的任务,逐条追问交付物在哪里。算出你自己的"两口径差值"。这个数字会告诉你,你现在的进度管理处于什么水平,以及最该先动哪一层。
常见问题解答(FAQ)
1. 项目实际进度到底怎么采集才可信?总不能天天追着成员问做到百分之几吧?
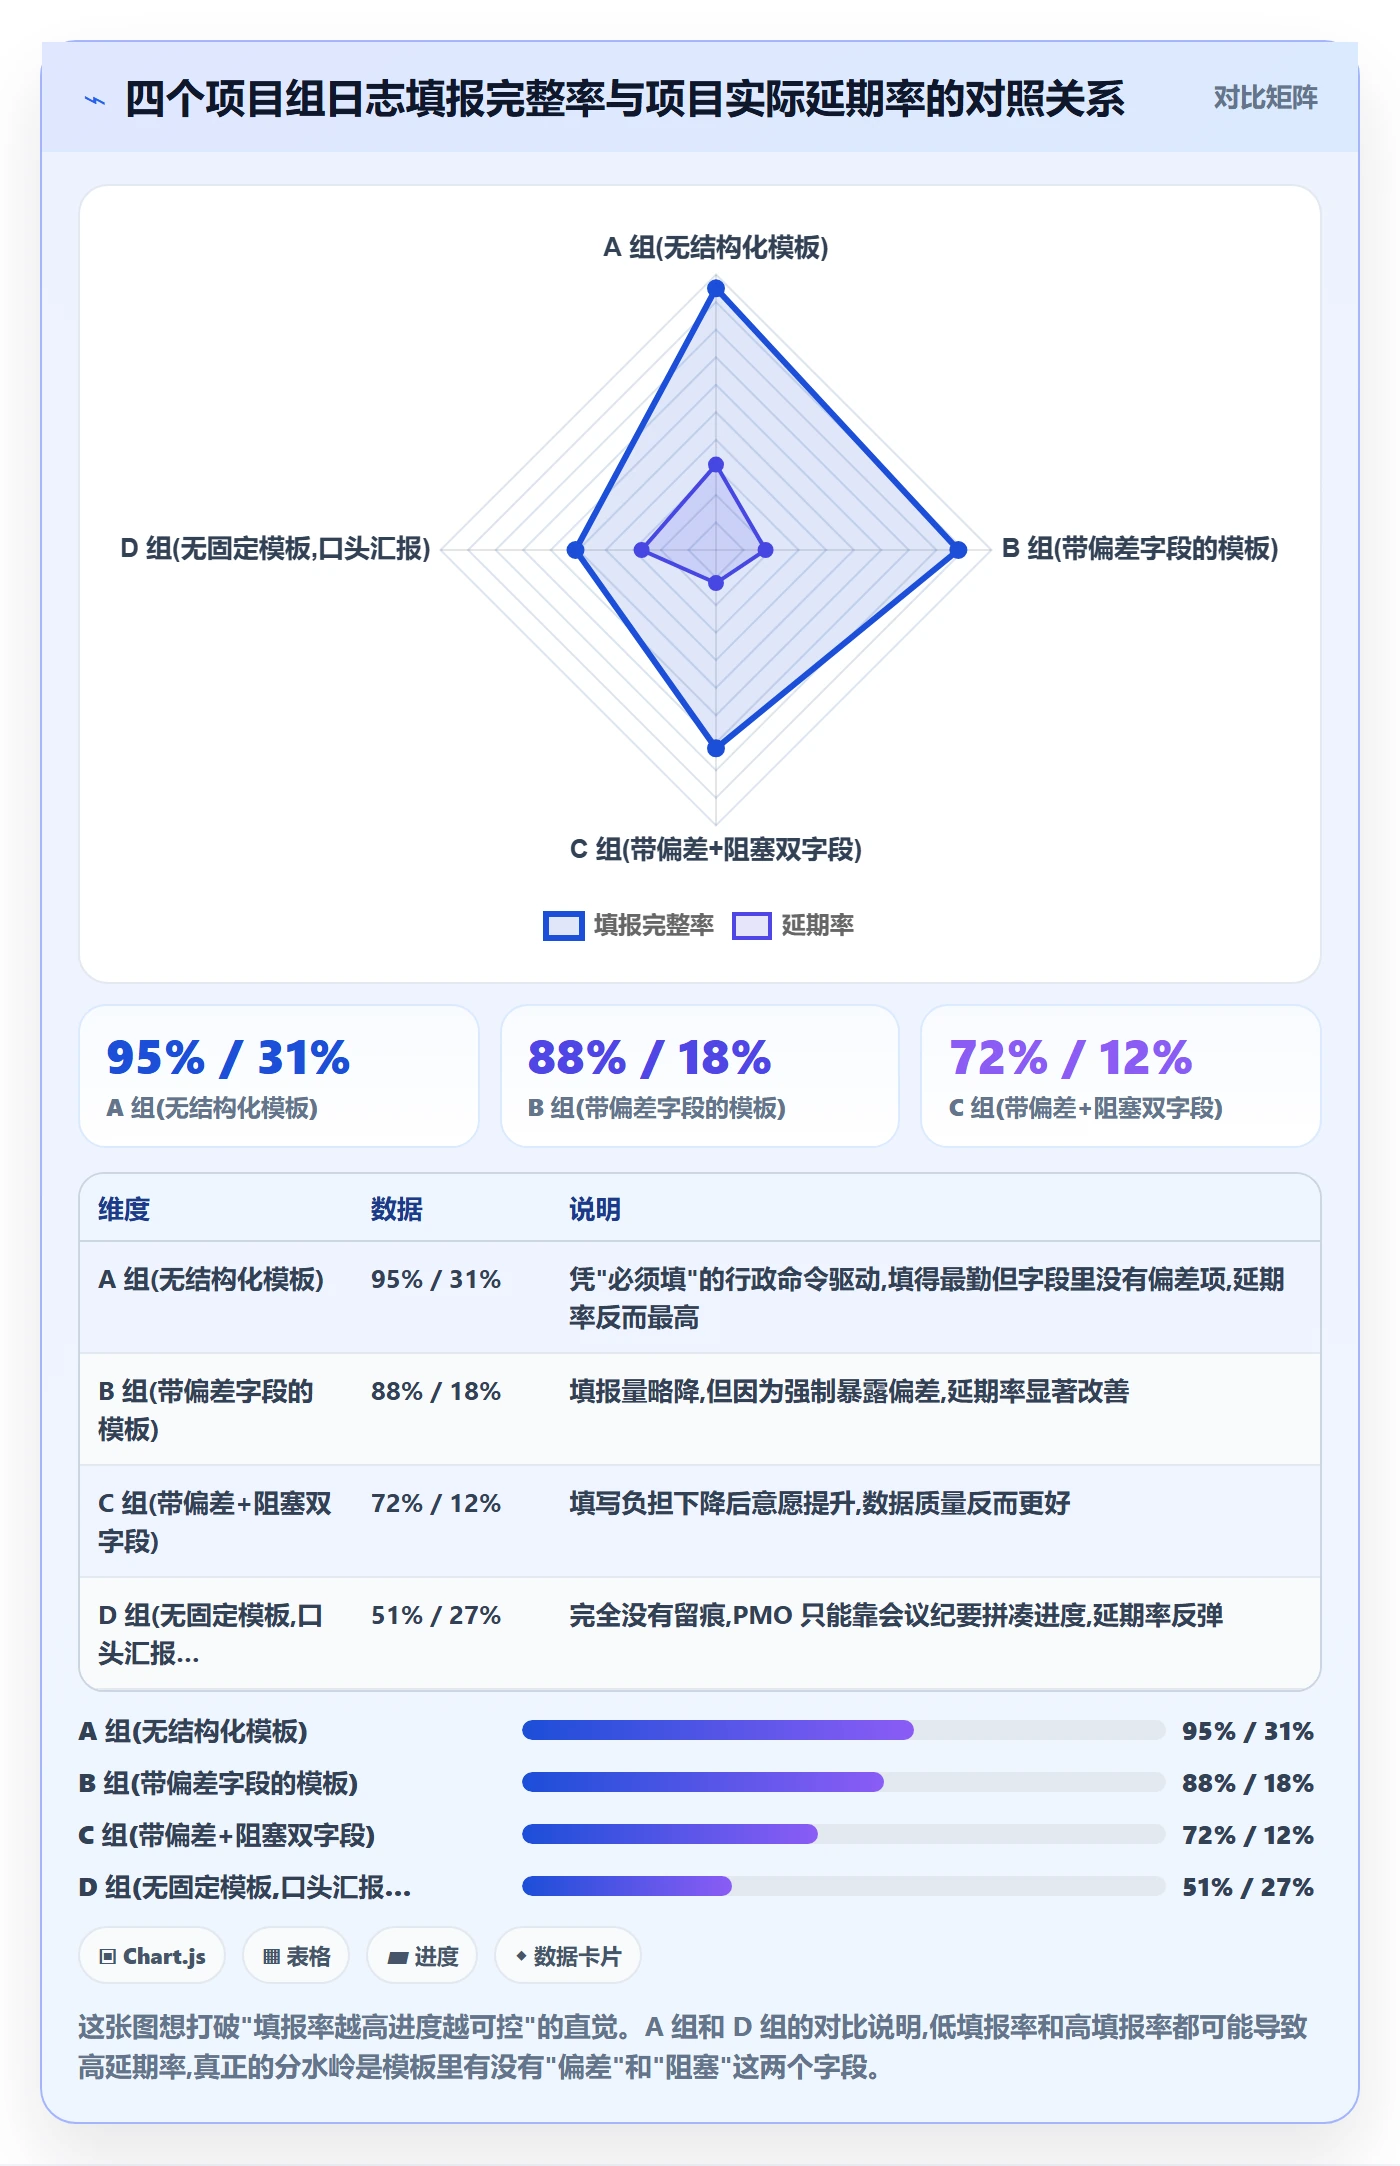
我之前带过一个跨部门项目,周报上每个人都填80%,连填三周都是80%,到截止日才发现接口根本没过联调。从那以后我就不太相信主观百分比了,但项目里又确实需要有个进度数字,所以一直纠结该用什么口径去采集。
别采主观百分比,改采可验证的完成证据。具体做法是每个任务必须写一句完成标志,这句话要能被第三个人独立验证,比如接口联调通过且返回样例已贴在任务评论里、页面在测试环境走通主流程并录屏。进度只在完成标志出现时才更新,其余状态一律按未完成计。
周期上推荐用0/100法或50/50法:0/100是里程碑未验收就是0,验收了才是100;50/50是开工记50、交付记100。颗粒度控制住1到5天的任务,超过5天的必须拆,否则颗粒度太粗,任何方法都会失真。
我自己的经验是把工具里完成百分比这个字段直接隐藏掉,虚报行为会明显减少,因为成员没法再用一个模糊数字交差,只能拿出证据。
2. 进度落后了10%,是不是必须马上加班赶回来?怎么判断是真落后还是估算里本来就留了水分?
我最怕看到甘特图上一片红色,条件反射就想让团队加班。但吃过亏之后发现,有时候那个红色只是原始计划里的buffer被吃掉了,硬赶反而把质量搞崩,后面返工更慢。所以现在我会先停下来想想这10%到底是什么性质。
先做偏差归因,把落后拆成三类:估算偏差,也就是原始工期里本来带了个人buffer;范围偏差,也就是中途加了需求但计划没同步;效率偏差,也就是执行确实比预期慢。判断依据看三个点:关键路径上的任务有没有延期、里程碑有没有滑期、当前SPI和历史项目基线比是多少。
如果只是非关键路径的浮动时间被吃掉,关键路径还稳,那不用加班,只要在周会上记录浮动时间消耗并盯着它别继续恶化。如果关键路径任务连续两周没按计划完成,或者里程碑已经滑期,那就是真落后,必须纠偏。
数据口径上我建议以里程碑达成率和关键路径延期天数为主指标,别用整体完成百分比,那个数字在跨模块项目里基本没有判断力。
3. 进度落后的时候,到底该加人还是砍范围?有没有一个可操作的决策顺序?
我在几个项目上都干过临时加人的事,结果新人上手要两周,老人还要分精力带,短期反而更慢。但直接砍范围又要跟业务方扯皮。所以我特别想知道,有没有一套顺序,能在压力下不靠拍脑袋做决定。
建议按这个顺序决策:第一刀砍范围,把所有非关键交付物列出来,按对上线价值的贡献排序,先推迟或降级排最后的那些;第二刀调结构,把原本串行的依赖尽量解耦或改成并行,同时压缩评审和返工环节的空转时间;第三刀才是加人或加班。
这个顺序的理由是,前两刀只消耗决策成本,不改变团队产能曲线,而加人受布鲁克斯定律影响,在项目后期通常会让整体更慢。判断要不要走到第三刀,看两个信号:关键路径是否仍有压缩空间、团队是否已经连续加班超过两周。
如果两个都没有,那就老老实实改上线日期,把新的日期作为唯一基线重新发布,而不是嘴上说争取赶上、心里留个模糊预期。改期要一次性改到位,反复小步后移对团队和业务方的信任伤害最大。
4. 进度汇报怎么做才既暴露真问题,又不至于每次都变成被老板追着问的批斗会?
我一开始是报忧不报喜,结果每周都被叫去开小会,团队士气也跟着掉。后来改成只报好消息,又出现老板在关键时刻被突袭的情况,信任直接受损。我一直没找到那个平衡点,所以想问问有没有比较成熟的汇报结构。
关键是固定结构加固定口径,让汇报变成例行公事而不是情绪事件。结构上建议三段:一是里程碑红黄绿灯,绿灯是已按计划达成且有验收证据,黄灯是预计会延期但还有应对手段,红灯是已经延期或没有可行方案;二是本周已完成的三个可验证成果,附上证据链接;
三是需要决策的事项,每条写清背景、可选方案、你建议哪个、需要谁在什么时间前拍板。口径上要固定,比如黄灯的标准是预计延期不超过三个工作日,超过就转红灯,这样老板不会觉得你在玩文字游戏。另外很重要的一点是,需要决策的事项必须在会上拿到明确结论和责任人,会后当天发出书面确认,否则同一件事会被反复问。
我实践下来,汇报质量高不高,不取决于你说了多少,而取决于你有没有把需要别人拍板的事情清晰地摆到桌面上。
核心关键词
文章包含AI辅助创作:实际进度落地方案:项目负责人开展进度管理的落地方案案例解析,发布者:飞飞,转载请注明出处:https://worktile.com/solution-1/archives/418956

读者评论
我们团队也经历过类似的进度幻觉,周报上写着80%完成,一到联调就崩。但文中说前60天数据只帮助不问责,实际执行起来很难,领导一看数据差就忍不住要追责,这条边界怎么守住?
把完成百分比换成剩余任务数加剩余关键路径天数,这个建议我打算试试。不过依赖等待占了44%这个数据让我有点意外,想问问怎么显式地为依赖建模,有没有轻量一点的做法?
四层模型里口径层和流程层都能理解,但工具选型那部分说得比较笼统。我们用的是某项目管理平台,任务状态字段可以自定义,但跨团队验收标准还是靠文档约定,感觉工具能帮的有限。