发布管理最常见的失控,并不是某个版本突然出了大故障,而是团队直到上线前两天才发现:需求已经变了,测试范围没跟着变,依赖团队也没有确认窗口,最后只能靠加班把“计划发布”勉强变成“按时上线”。要从0到1建立发布管理,PMO真正要做的不是多加几张审批表,而是让组织看清发布的输入、风险、决策和结果,并能用数据判断下一次是否做得更好。
一、先讲核心结论:发布管理不是排日历,而是经营一条交付链
1. 发布管理要管的是“可交付性”,不只是发布日期
我判断一套发布管理是否有效,不先看日历上有没有版本日期,而是看三个问题能不能被清楚回答:这次到底交付什么,当前有哪些条件尚未满足,谁有权在什么证据下决定继续、延期或缩小范围。
如果日期有了,但范围还在变、质量状态不可见、上线回退方案无人确认,那么日历只是承诺,不是管理。发布管理的核心对象应当是一个可被验证的交付单元:包含明确范围、责任人、依赖关系、质量证据、上线窗口、回退路径和结果复盘。
我的核心判断是:发布管理的成熟度,不取决于流程有多复杂,而取决于风险能否在承诺之前被发现、在上线之前被处置、在上线之后被追溯。流程越重不一定越安全,能让团队更早暴露问题、减少临时协调成本的流程才有价值。
2. 从0到1,先建最小闭环,再逐步加控制
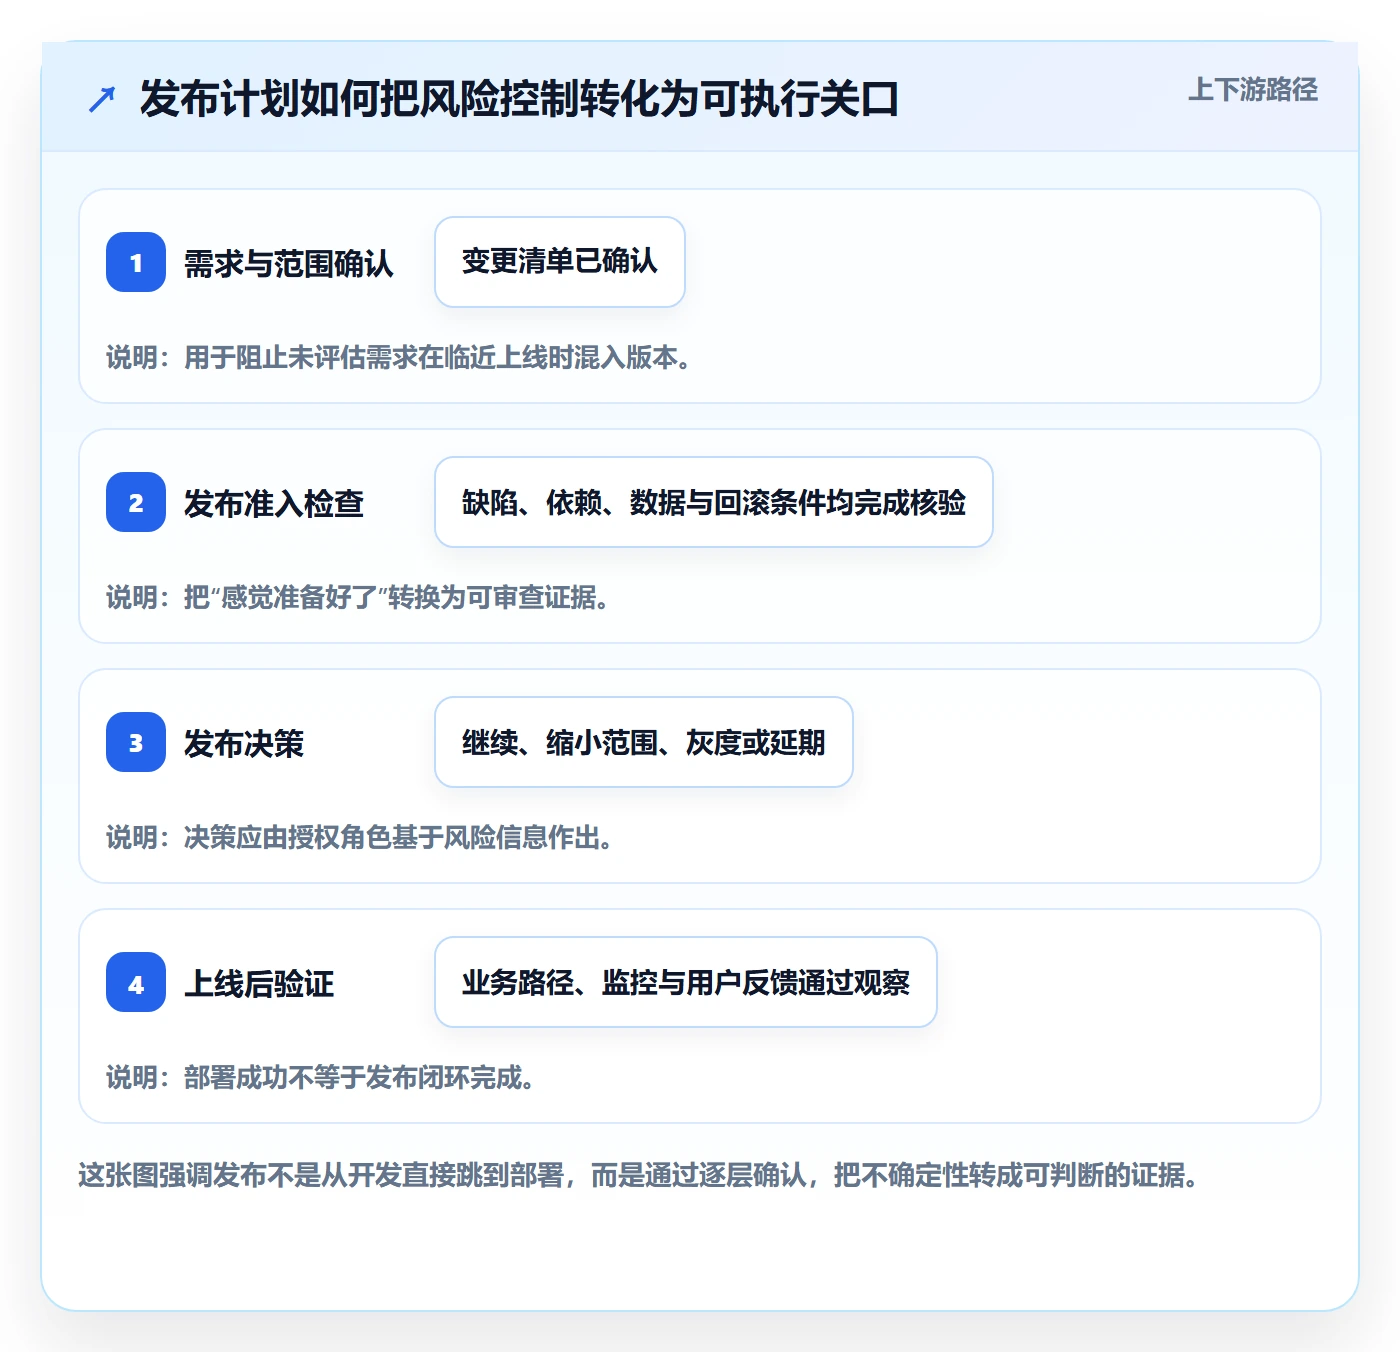
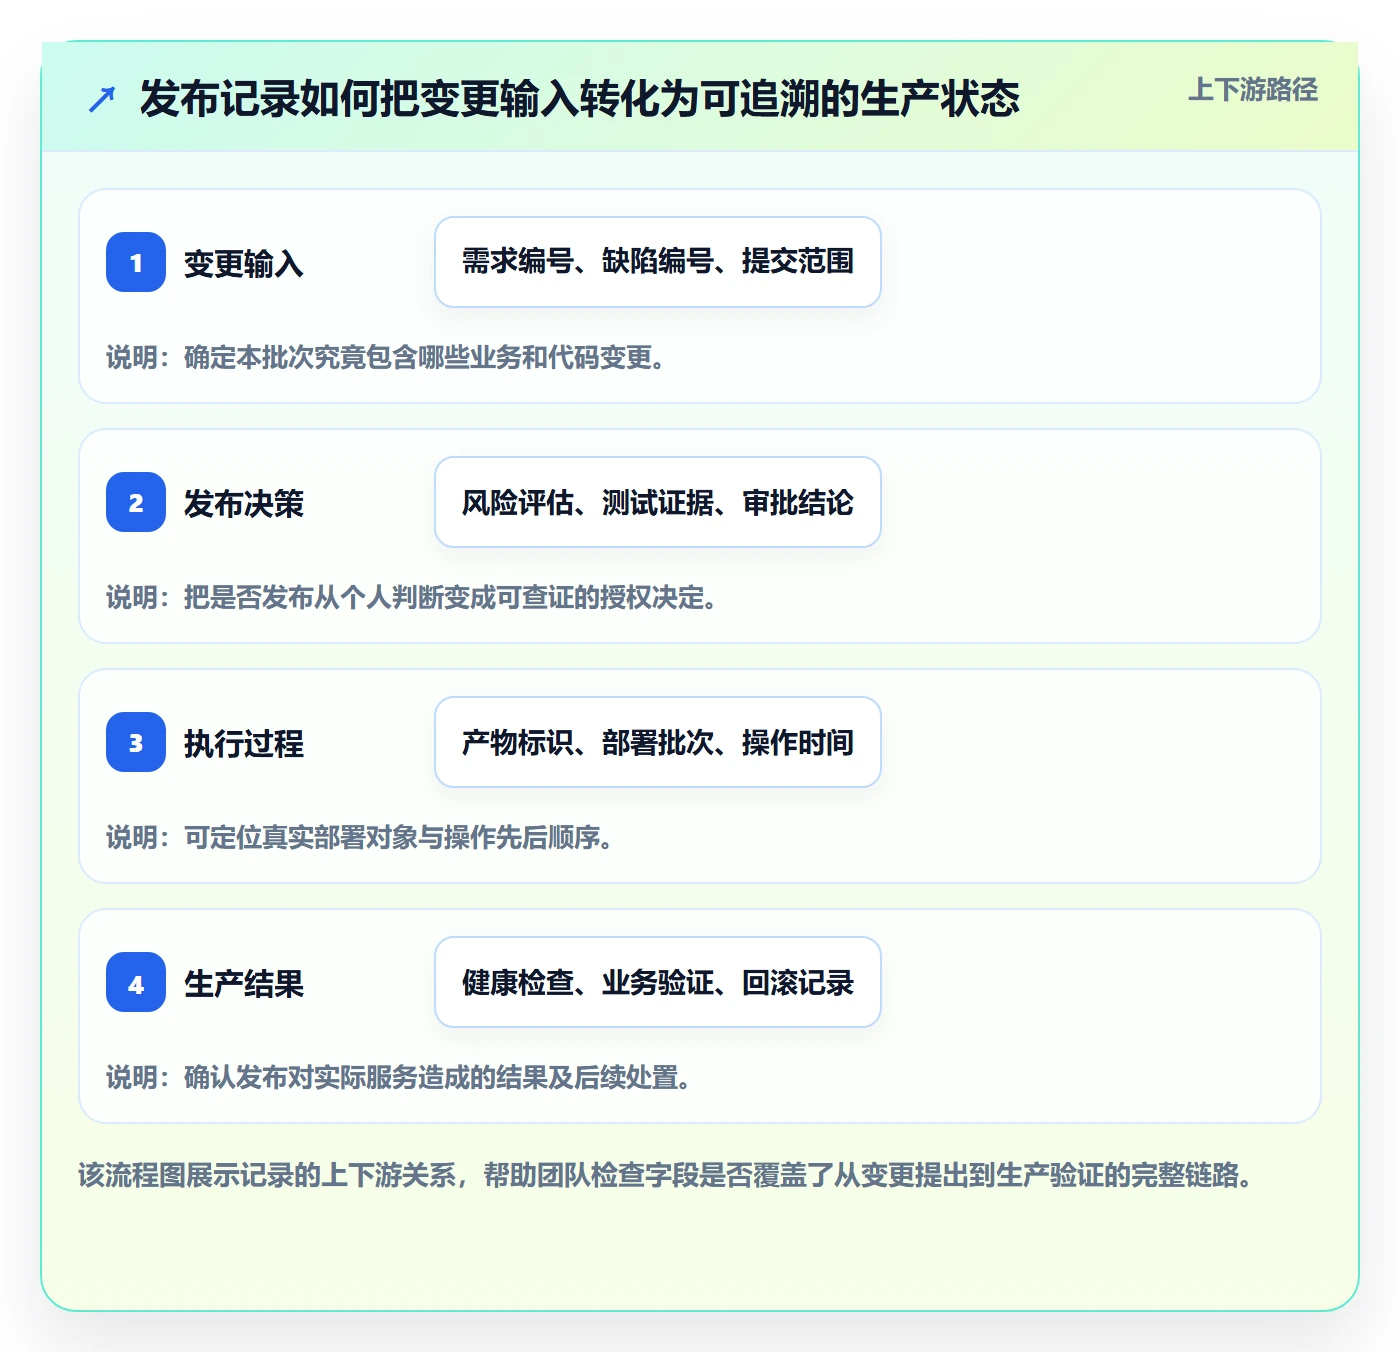
刚开始做发布管理时,常见冲动是先把审批、会议、模板、通知、看板全部建齐。我的建议相反:先跑通一个最小闭环,再决定哪些控制值得固化。最小闭环只有五步:形成发布计划、持续更新范围与风险、发布前做准入判断、执行上线与观察、对结果进行复盘。
每一步都要留下可核验的信息,但不必一开始就追求复杂系统。小团队可以用结构化表格起步;当版本、团队、依赖、发布窗口明显增加,再把数据沉淀到某项目管理平台,减少重复录入和状态对账。
- 计划:明确发布编号、目标日期、范围、负责人和关键依赖。
- 跟踪:记录范围变化、未完成工作、风险等级和处理责任人。
- 准入:依据质量门槛、运维准备和业务确认决定是否具备发布条件。
- 执行:按窗口完成部署、验证、监控和必要的回退。
- 复盘:比较承诺与实际,解释偏差,形成下一轮行动项。
从组织效率角度看,PMO不应成为每个版本的人工调度中心。PMO应该定义数据口径、维护决策机制、识别跨团队风险,并把例外情况升级给有权决策的人。团队对交付负责,PMO对管理系统是否有效负责。
3. 发布管理的目标,是提高决策质量而非制造“零延期”
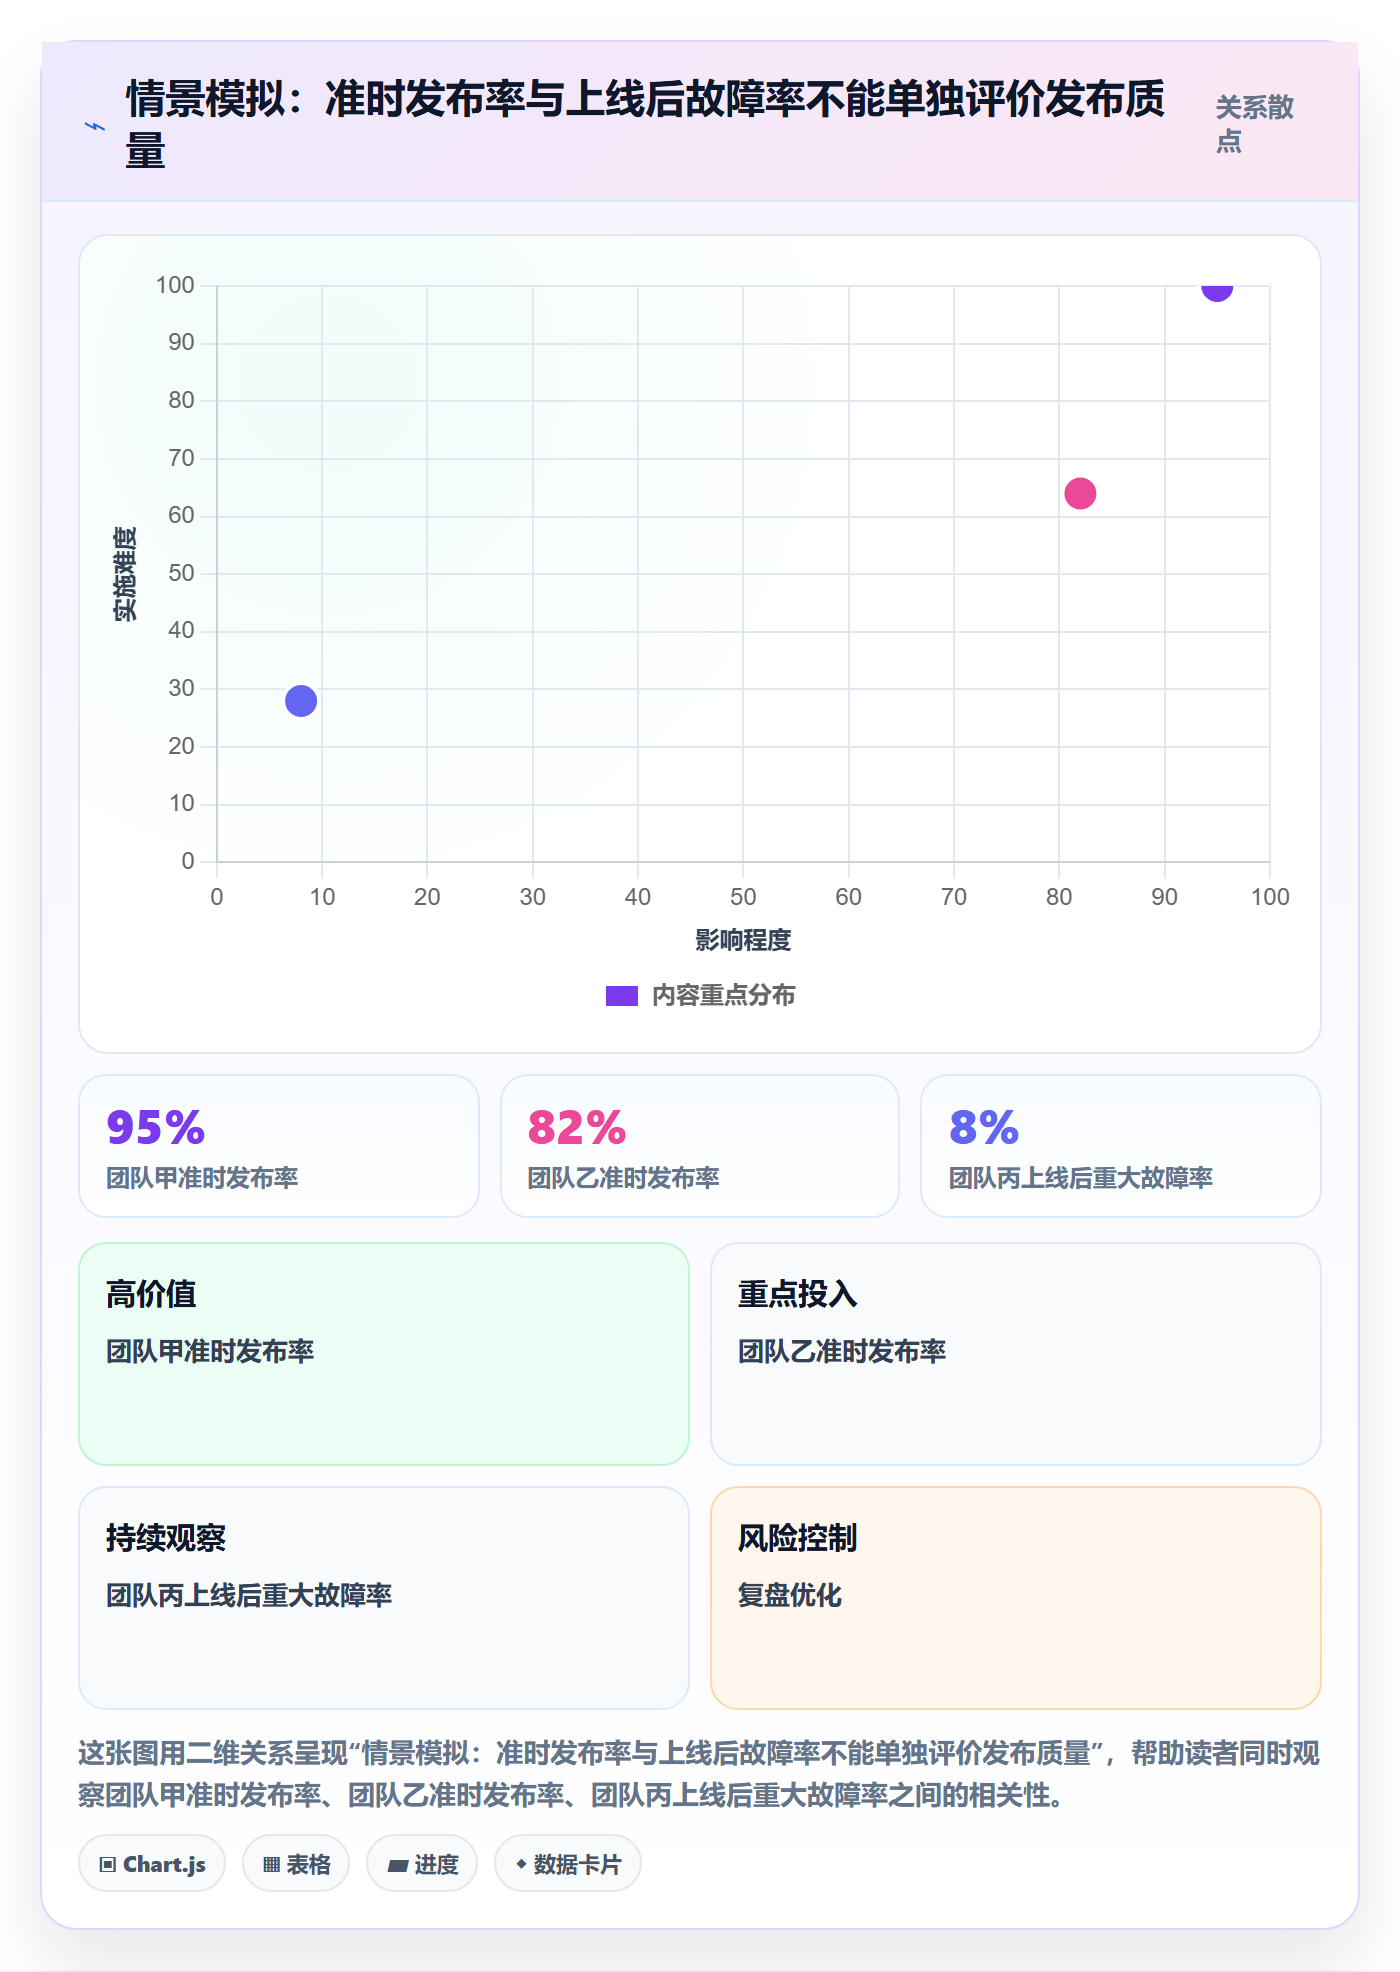
把“准时发布率”设成唯一目标,容易诱导团队通过拆分版本、调整日期、弱化质量门槛来美化数字。一个负责任的发布机制,既要关注承诺兑现,也要关注质量、变更和业务结果。延期有时是正确决策,尤其当核心验证未完成、数据迁移存在不可逆风险,或关键依赖尚未就绪时。
PMO要区分“可控延期”和“管理失灵”。在充分证据下主动延期,说明决策机制在发挥作用;上线前才暴露长期已知风险、临时删改范围又没有记录,则说明风险管理没有及时发生。
二、背景和真实场景:为什么发布问题总在最后几天集中爆发
1. 版本不是在上线周才开始形成的
发布的结果,往往由更早的决策共同决定。需求进入开发时是否明确,团队是否识别外部依赖,测试是否拿到稳定环境,业务是否预留验收时间,都会影响最终上线。若PMO只在发布日期前开一次发布会,看到的通常已经是问题的末端,而不是问题的来源。
在一个跨研发、测试、产品、运维和业务部门的项目中,延期经常被归因于“测试没做完”。进一步拆解才发现,测试开始晚并非唯一原因:测试环境被其他项目占用、验收样例未准备、接口变更没有同步、上线窗口与业务活动冲突,都可能把压力挤到最后一周。
因此,发布管理应覆盖“从承诺到结果”的全过程。PMO不需要替每个团队执行任务,但要建立一套让关键前置条件在早期可见的机制。越靠近上线才发现的问题,通常越贵;不是因为问题本身变复杂,而是可选的解决路径变少了。
2. 100人以上组织的难点,通常是依赖和口径,而非工具数量
在100人以上的组织里,一个版本可能横跨多个团队、多个系统和不同的交付节奏。每个团队都可能有自己的迭代计划、缺陷等级、测试状态和上线流程。PMO面对的挑战不是“有没有数据”,而是同一个词在不同团队是否代表同一件事。
例如,团队甲把“开发完成”定义为代码提交,团队乙把它定义为代码评审通过,团队丙则以部署到测试环境为准。若这些状态被直接汇总成一个“完成率”,管理层看到的数字虽然整齐,实际含义却不一致。
如果组织使用某项目管理平台,例如PingCode,适合先用它承载需求、任务、缺陷、版本和责任关系,再逐步把状态口径与发布流程对齐。工具只能让信息更容易沉淀,不能替组织回答“什么算完成”“什么风险必须升级”这类治理问题。
3. 发布现场最有价值的信息,往往是异常而非平均数
月度平均发布周期可能看起来平稳,但少数高风险版本会造成大量返工、紧急变更和业务影响。PMO不能只看平均值,还要看分布和异常:延期集中在哪类依赖,缺陷主要在哪个阶段被发现,范围变化是否挤压了验证时间,回退是否演练过。
我会优先检查每个发布的例外记录,而不是先追求一张漂亮的总览图。例外记录包括:计划范围变化、准入条件豁免、未关闭风险、上线窗口调整、回退触发和上线后问题。它们能解释汇总指标背后的原因,也能帮助判断下一步该改流程还是改资源安排。
三、常见误区:看起来管得更严,实际可能更难控
1. 误区一:把发布计划等同于一张日期表
日期表能回答“什么时候”,却回答不了“什么条件满足才可以发布”。如果计划只写版本名称和上线日期,团队很难在早期看出范围冲突、资源拥堵和外部依赖。发布日期也容易变成不可讨论的硬承诺,导致风险被压到最后才暴露。
可执行的发布计划至少要包括范围基线、计划窗口、责任角色、关键依赖、测试与验收安排、风险等级以及决策节点。计划不是一次性文件,而是随证据更新的管理对象。任何重要变化都应留下时间、原因、影响和批准者。
2. 误区二:把所有发布都套进同一套重流程
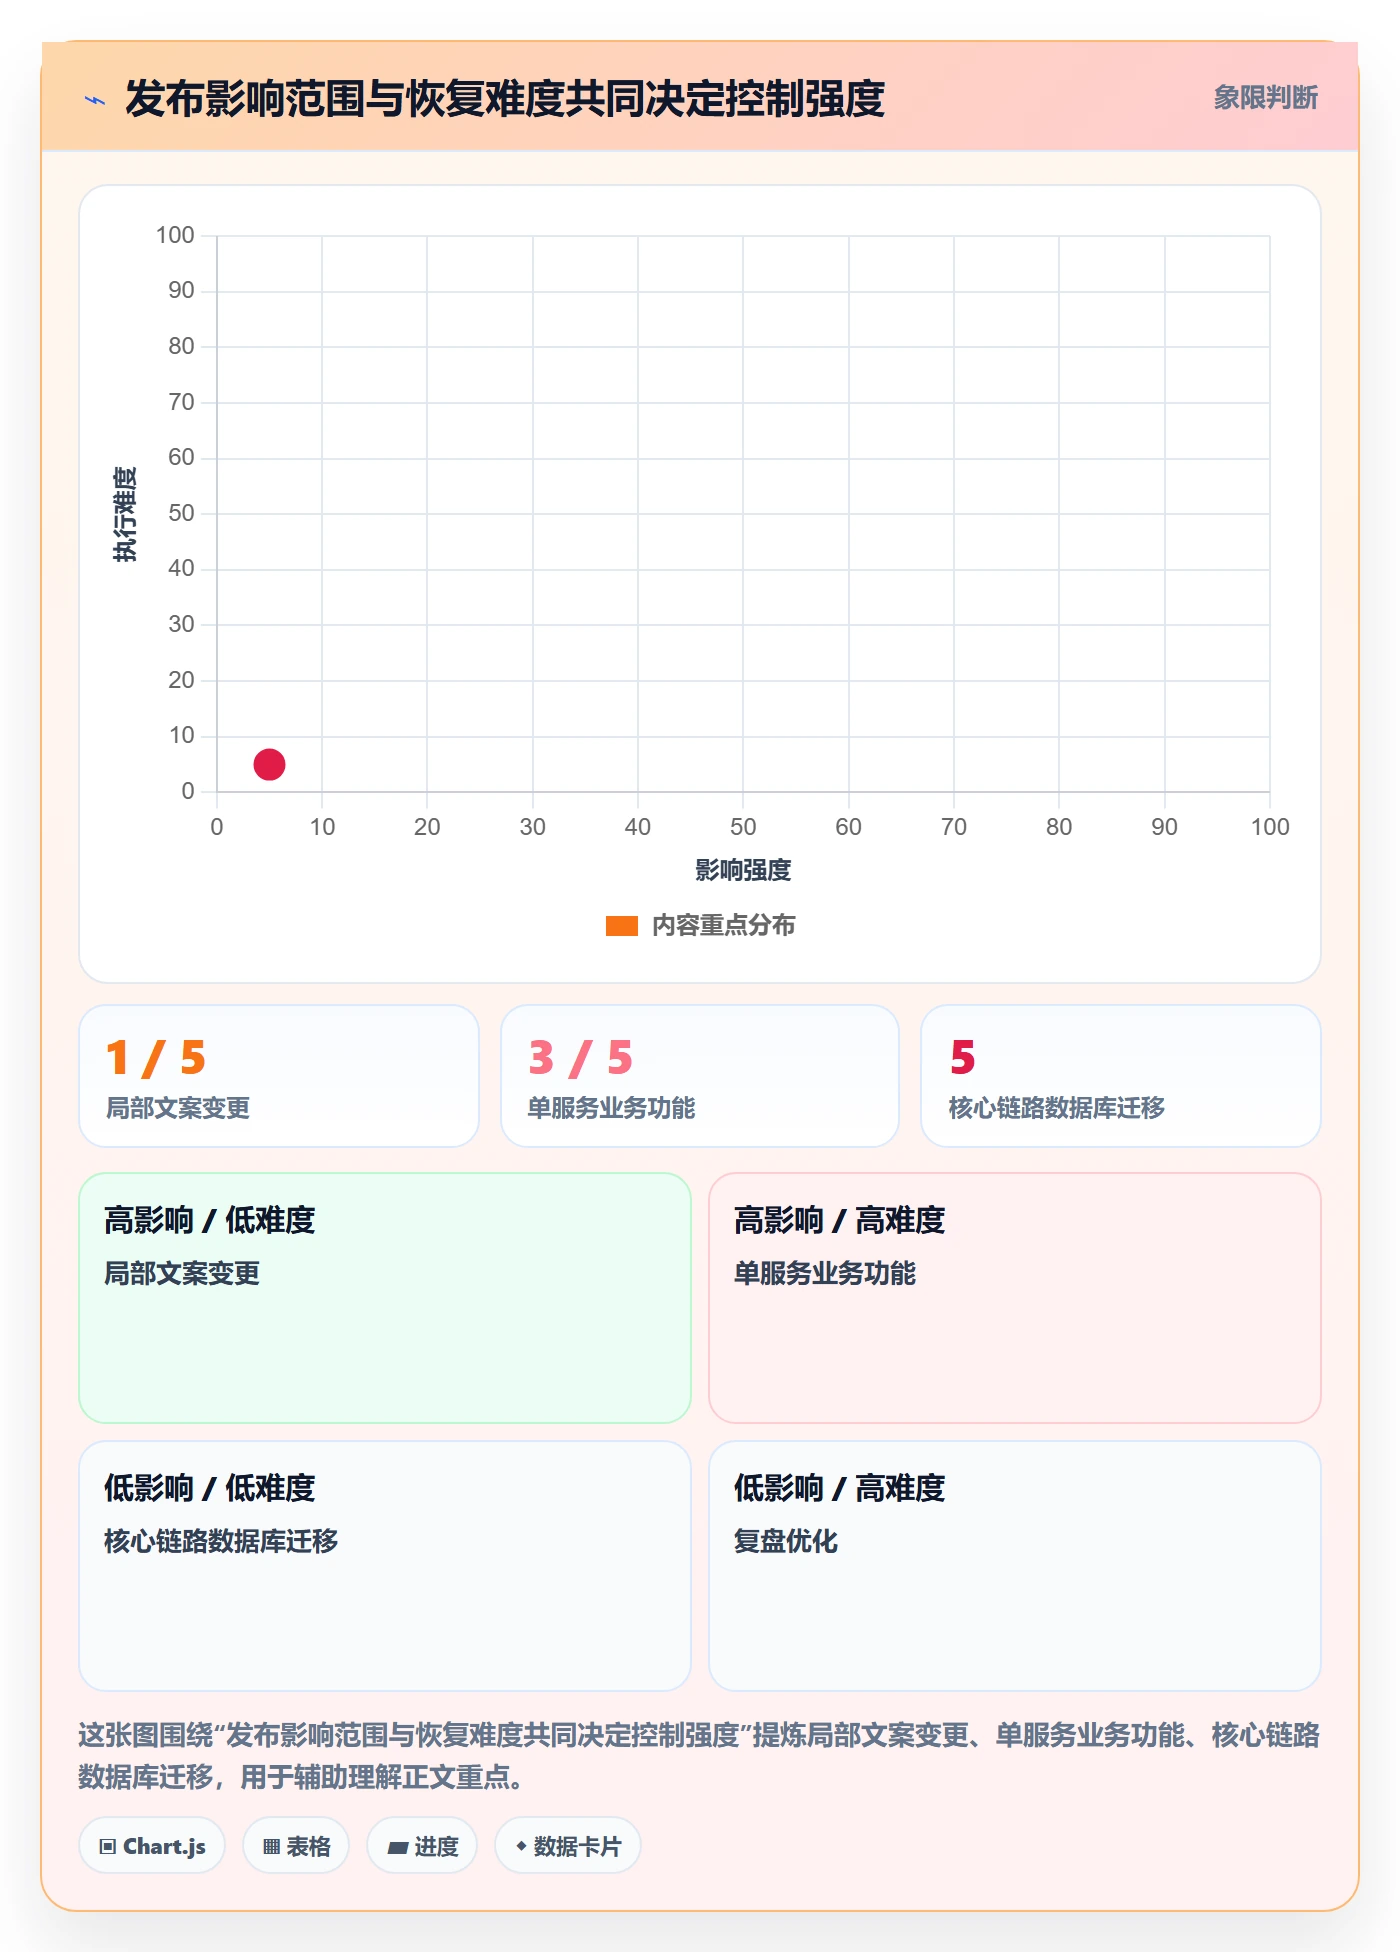
内部低风险修复、面向客户的核心交易功能、涉及数据迁移的重大升级,风险等级完全不同。如果都要求同样多的会议和签字,低风险团队会觉得流程是负担,高风险团队也未必因此得到更有效的控制。
我更倾向于分级治理:根据业务影响、变更范围、回退难度、数据敏感性和依赖复杂度,决定准入证据与审批层级。流程的严谨程度应与风险相称,不应与团队规模或管理者偏好简单绑定。
3. 误区三:用“完成率”掩盖范围变化和质量债务
如果版本原定100项工作,临近上线时删掉30项,再以“剩余工作全部完成”报告100%完成率,这个数字并没有说明承诺是否兑现。完成率必须绑定范围基线,范围变更也要单独计量。
同样,缺陷数量也不能脱离严重程度、发现阶段和重复发生情况解读。上线前发现很多低优先级缺陷,可能反映测试覆盖充分;上线后少量但高影响故障,反而可能造成严重业务损失。指标必须配有解释口径,不能只比较数字大小。
4. 误区四:把准时发布率当作团队绩效排名
准时率适合观察计划兑现能力,却不适合直接用于不同业务团队的横向排名。承担高不确定性项目的团队,与维护稳定产品的团队,工作环境不同;将两者放在一个榜单里,可能鼓励团队低估工作量、回避高风险任务,或把延期日期反复重设。
更稳妥的做法是看趋势、看偏差原因、看同类项目,并将指标用于改进系统而非惩罚个人。PMO应报告“哪些条件导致预测不准”,而不是只公布“哪个团队排名靠后”。
5. 误区五:上线成功就意味着发布管理成功
成功部署不等于业务目标达成。功能上线之后,还要看用户是否使用、关键业务流程是否改善、支持请求是否激增、监控是否出现异常。只记录“部署完成”,会把发布管理切断在技术动作上,无法判断交付是否产生预期价值。
对重要发布,我会把观察窗口纳入计划。例如上线后24小时检查核心技术信号,7天内复核业务采用或客户反馈,必要时在更长周期评估目标指标。观察窗口应根据功能风险和业务周期设定,而不是机械套用同一个期限。
四、专业判断逻辑:先定义数据,再定义门槛,最后定义决策权
1. 先统一“发布”与“完成”的数据口径
组织首先要说清楚一次发布从哪里开始、到哪里结束。对某些团队,发布从版本范围冻结开始;对另一些团队,发布可能从正式立项开始。若不定义事件边界,周期指标就无法比较。
我建议为发布建立统一标识,并确保需求、任务、缺陷、测试记录、变更单、部署记录和复盘事项都能关联到这个标识。数据不一定全部放在一个系统里,但必须能追溯到同一次交付。
还要区分计划日期、预测日期、批准日期和实际日期。预测日期反映当前判断,批准日期反映正式承诺,实际日期反映结果。把这几种日期混成一个字段,会让计划准确性和变更历史都失去分析价值。
| 字段 | 建议口径 | 主要用途 |
|---|---|---|
| 发布标识 | 组织内唯一,关联需求、缺陷、变更与部署记录 | 跨系统追溯同一交付单元 |
| 范围基线 | 在约定的基线日期冻结,变更需记录原因和影响 | 区分按承诺完成与范围调整后的完成 |
| 计划窗口 | 记录最初计划窗口,并保留每次调整历史 | 分析计划稳定性与预测偏差 |
| 准入状态 | 明确通过、附条件通过、延期或拒绝 | 还原上线决策及例外情况 |
| 实际完成时间 | 以部署和业务验证的约定事件为准 | 计算交付周期和上线后观察周期 |
2. 指标不求多,先覆盖时间、质量、范围和结果
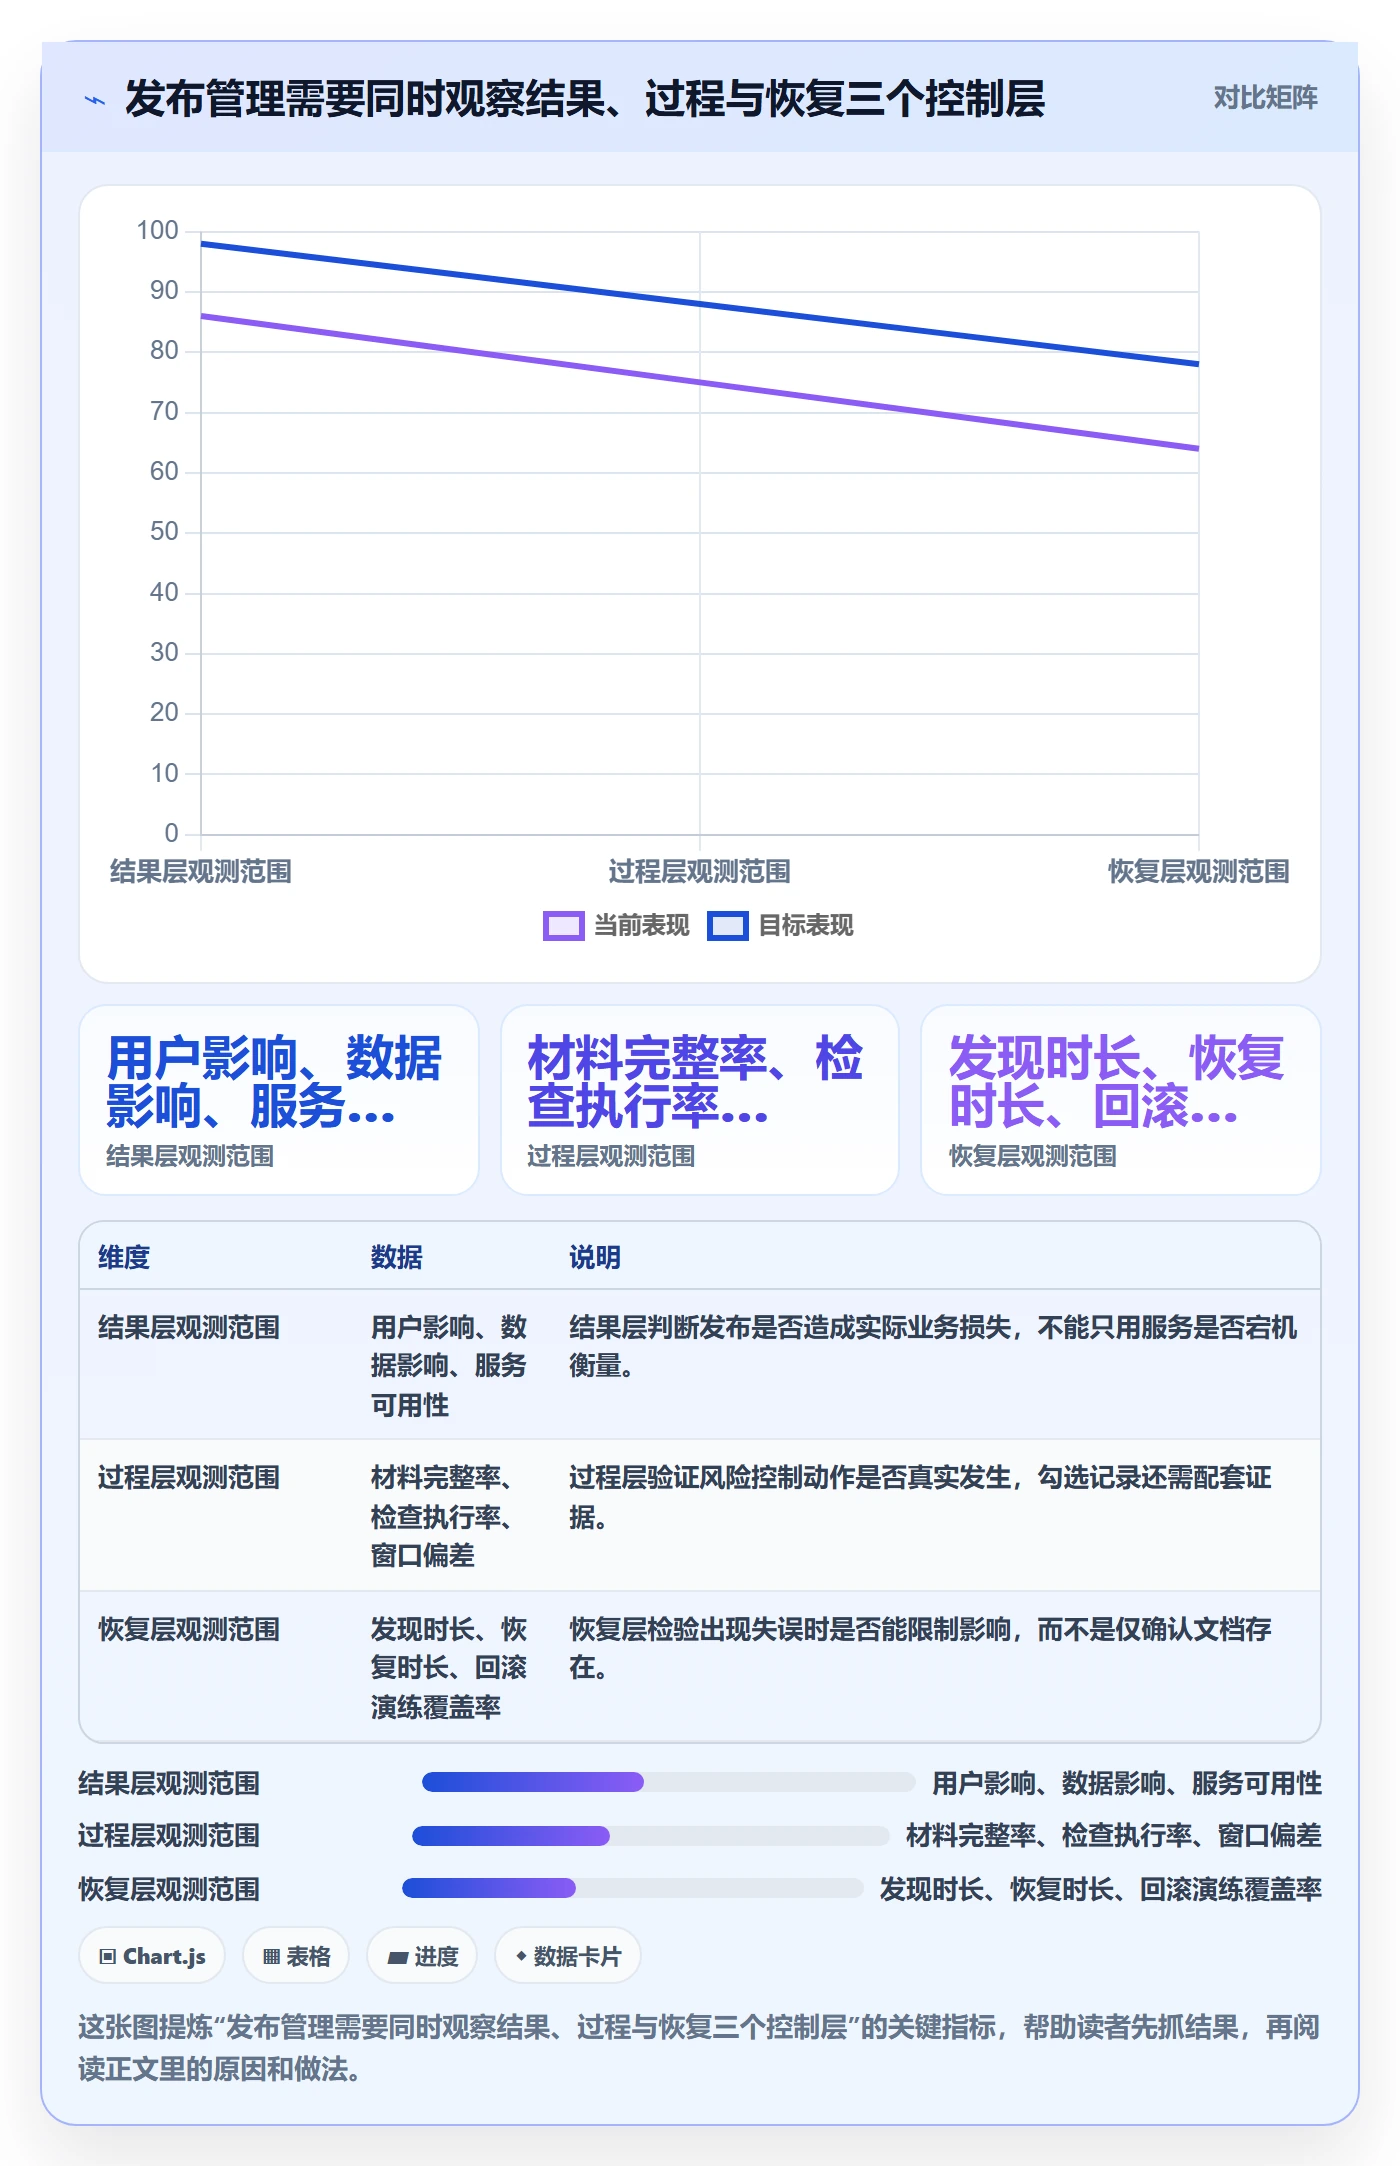
从0到1阶段,建议先建立一组能帮助行动的指标,而不是一次上几十个仪表盘。至少覆盖四类:时间是否可预测,质量问题何时暴露,范围是否稳定,发布后是否实现预期。
- 计划兑现率:按约定口径计算在批准窗口内完成的发布比例。需要同时报告延期原因和范围变化,避免数字被单独解读。
- 预测偏差:比较当前预测日期与实际完成日期的差值,可按版本类型或复杂度分组观察。
- 范围变更率:统计基线之后新增、删除或修改的交付项,建议同时按数量和工作量口径观察。
- 上线后缺陷率:按严重程度统计发布后一定观察窗口内暴露的问题,需定义问题与该发布的归属规则。
- 回退或紧急修复率:观察上线后需要回退、热修复或采取紧急缓解措施的发布比例。
- 业务目标达成度:选择与发布目的直接相关的业务指标,不应把所有发布都用同一个业务结果衡量。
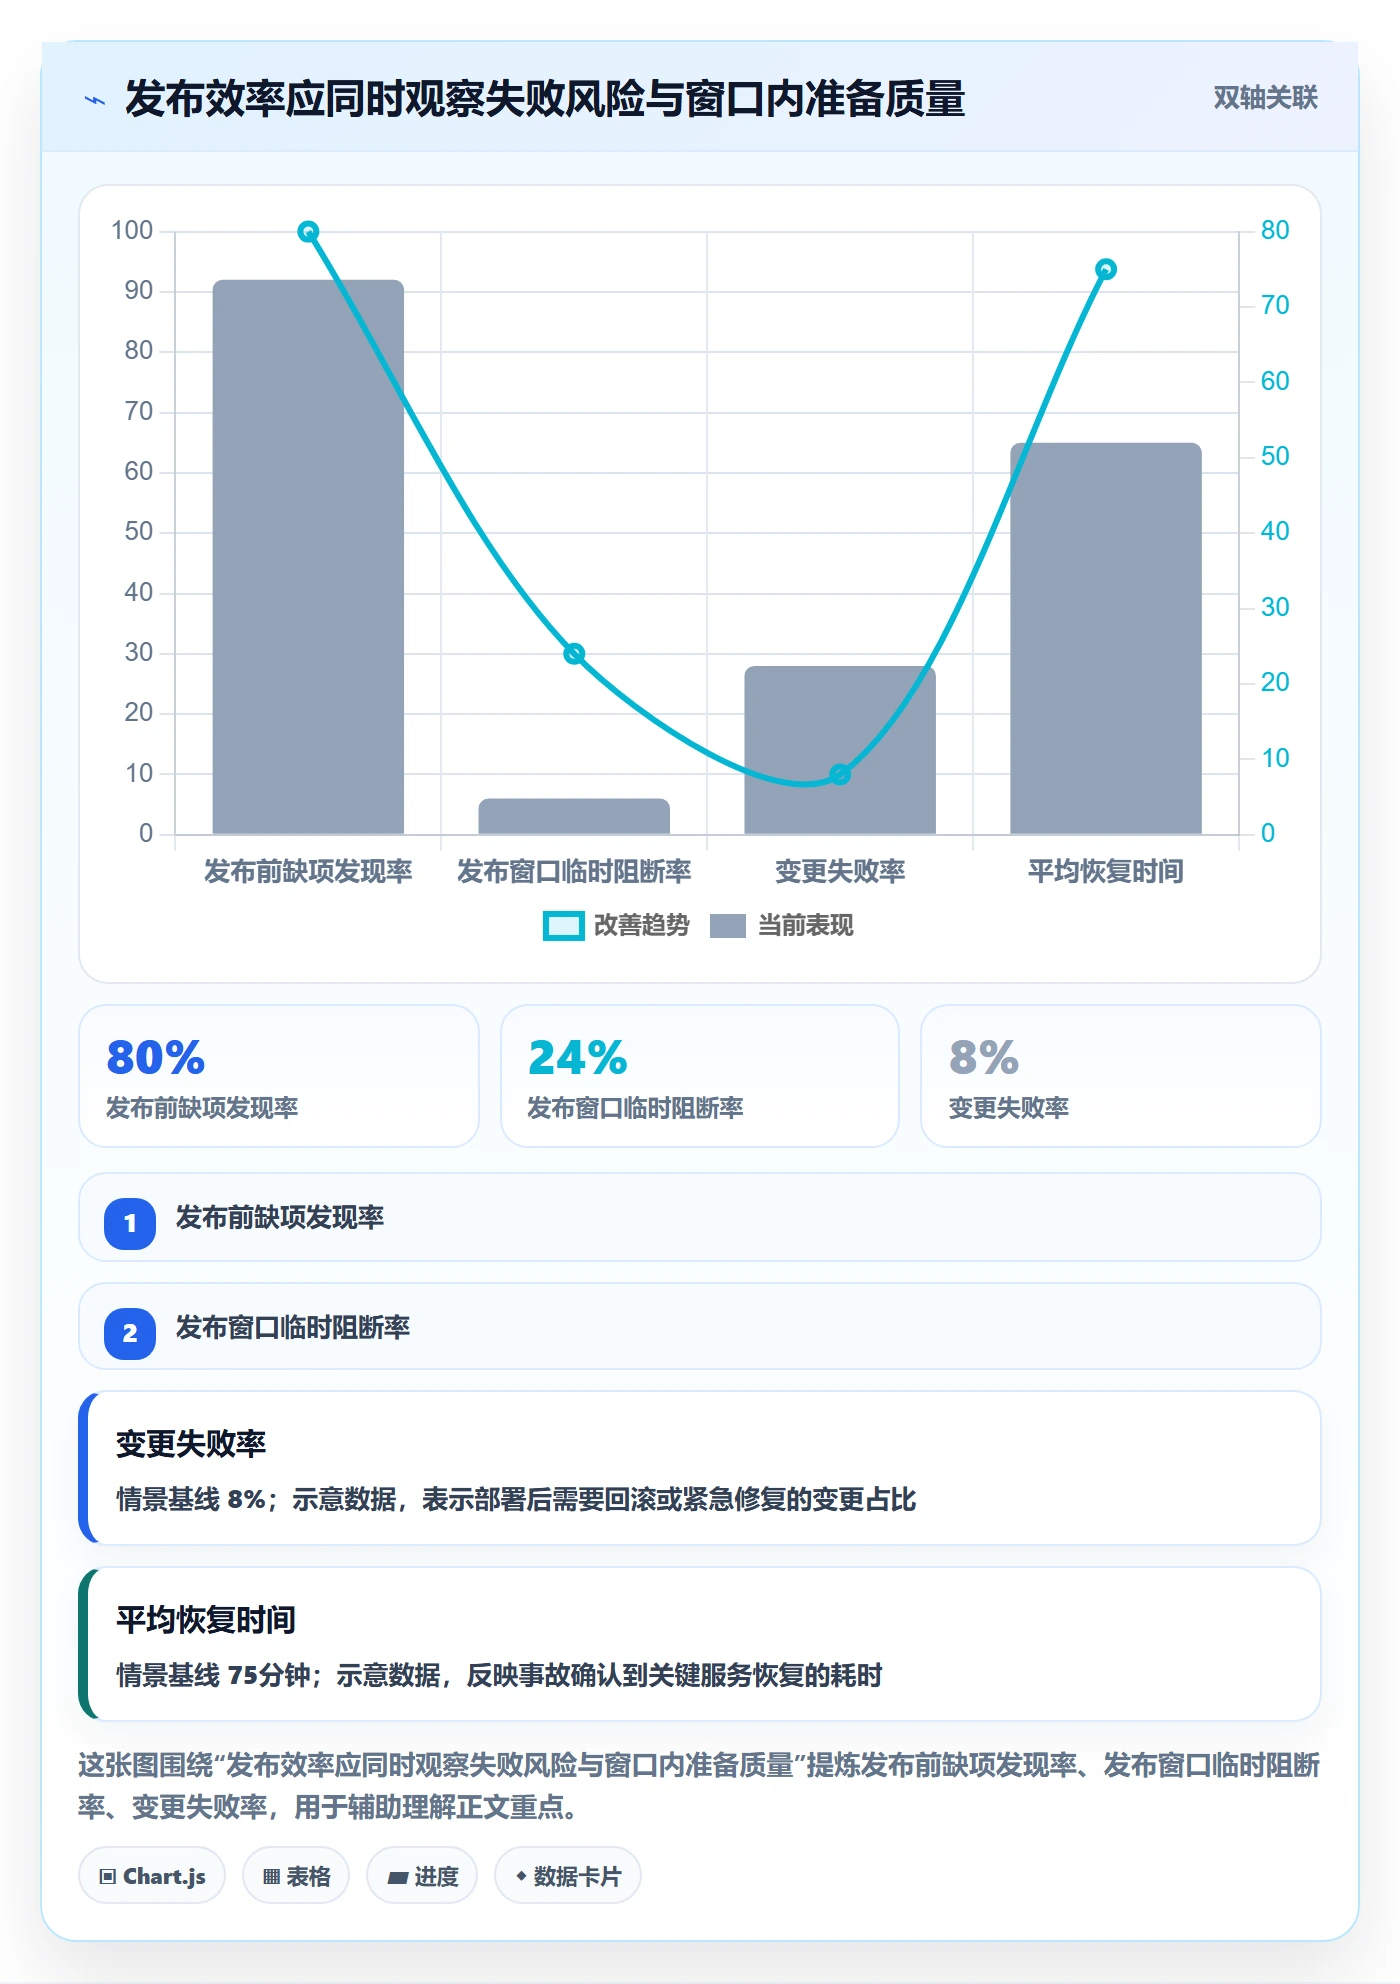
交付效能的常用指标体系可以参考DORA研究中关于交付吞吐与稳定性的思路,例如部署频率、变更前置时间、变更失败率和故障恢复时间。使用时要结合组织语境,并核对当前采用的指标定义;不要把外部报告的分组结果当成适合本组织的硬性目标,也不要为了提升指标而人为拆分或合并发布。
3. 设立风险分级,让不同发布接受不同强度的准入检查
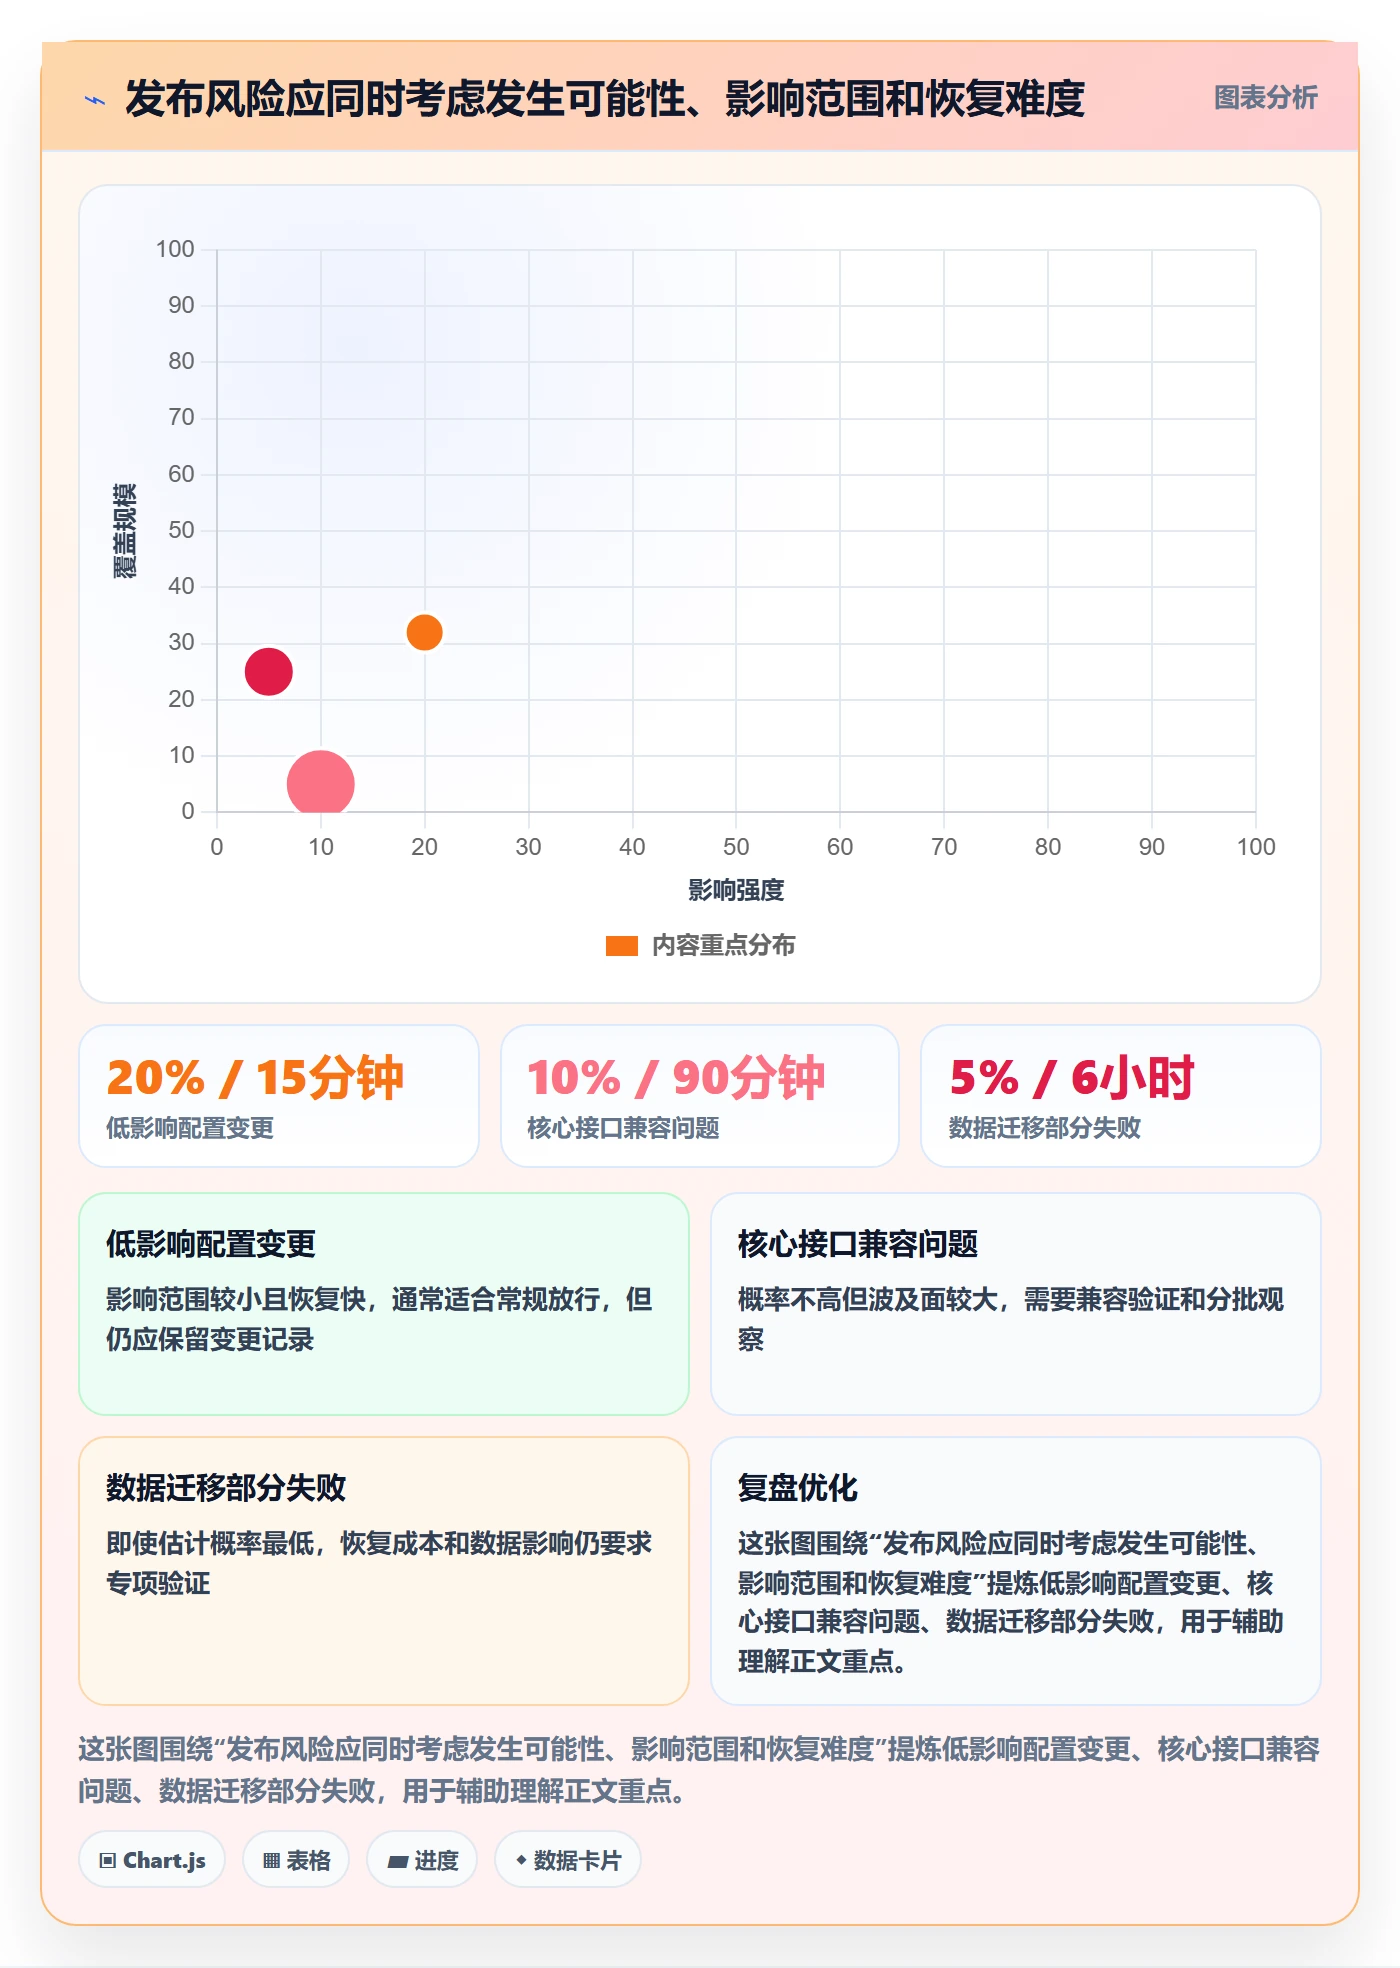
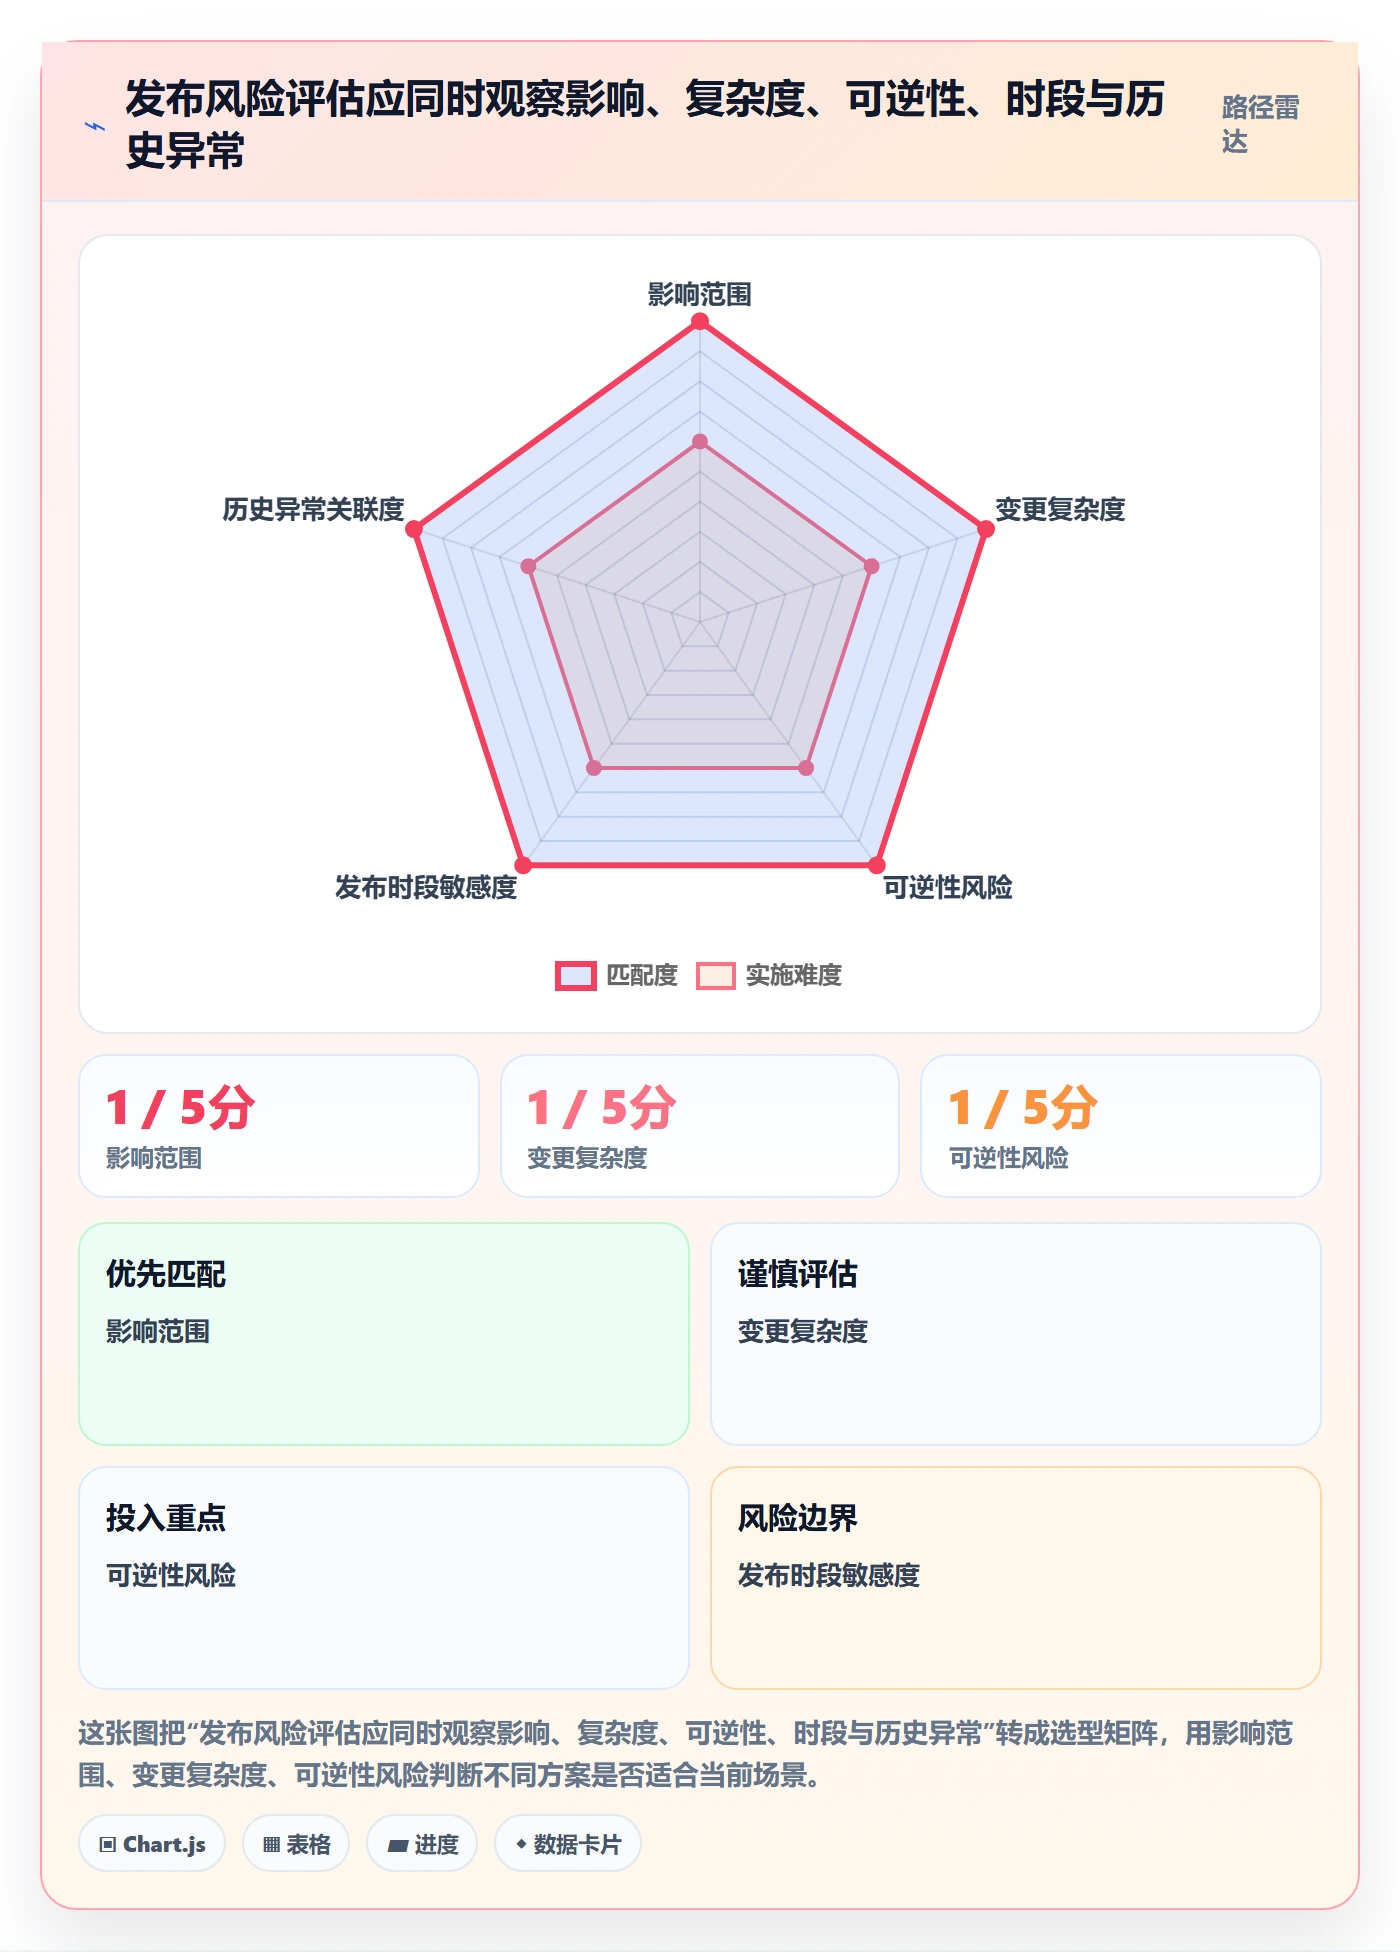
风险分级的目的不是给项目贴标签,而是决定需要什么证据、由谁作出决定。可先用业务影响、用户范围、变更复杂度、回退难度、数据风险和依赖数量六项做初步判断,再根据实际事故和豁免记录调整。
| 风险级别 | 典型特征 | 建议准入证据 |
|---|---|---|
| 低 | 小范围改动、回退简单、依赖较少 | 基本测试通过、负责人确认、监控与回退方式明确 |
| 中 | 涉及多个模块或团队,有明确业务影响 | 范围确认、测试证据、依赖确认、业务验收人与上线窗口明确 |
| 高 | 关键业务、复杂迁移、影响面广或回退困难 | 专项风险评估、演练记录、分批发布方案、应急联系人与决策人确认 |
高风险级别不一定意味着更长审批链。真正重要的是证据是否充分、异常是否有人负责、出现问题时是否能快速作出响应。对低风险发布,过多审批可能比风险本身消耗更多组织成本。
4. 把“继续、延期、缩范围”设计成明确的决策选项
发布会不是状态朗读会,而是决策会。会前材料应能让参与者判断:当前是否满足准入条件,未满足项的影响是什么,有没有替代方案,谁承担剩余风险。会议结论需要落成明确决策,而不是“大家再跟进一下”。
- 继续:核心准入条件满足,遗留项在批准范围内,有明确监控与响应安排。
- 附条件继续:少数低影响事项尚未完成,但有责任人、截止时间、验证方式和升级规则。
- 缩小范围:非核心功能可以移出本次发布,且移除后不会破坏关键流程或引入隐性依赖。
- 延期:关键质量证据不足、影响面不可接受、回退方案不可靠或核心依赖未确认。
每一次例外都应记录决策人、理由、有效期和复核条件。例外不是流程漏洞;没有记录、没有责任人、没有退出条件的例外,才会逐渐变成默认做法。
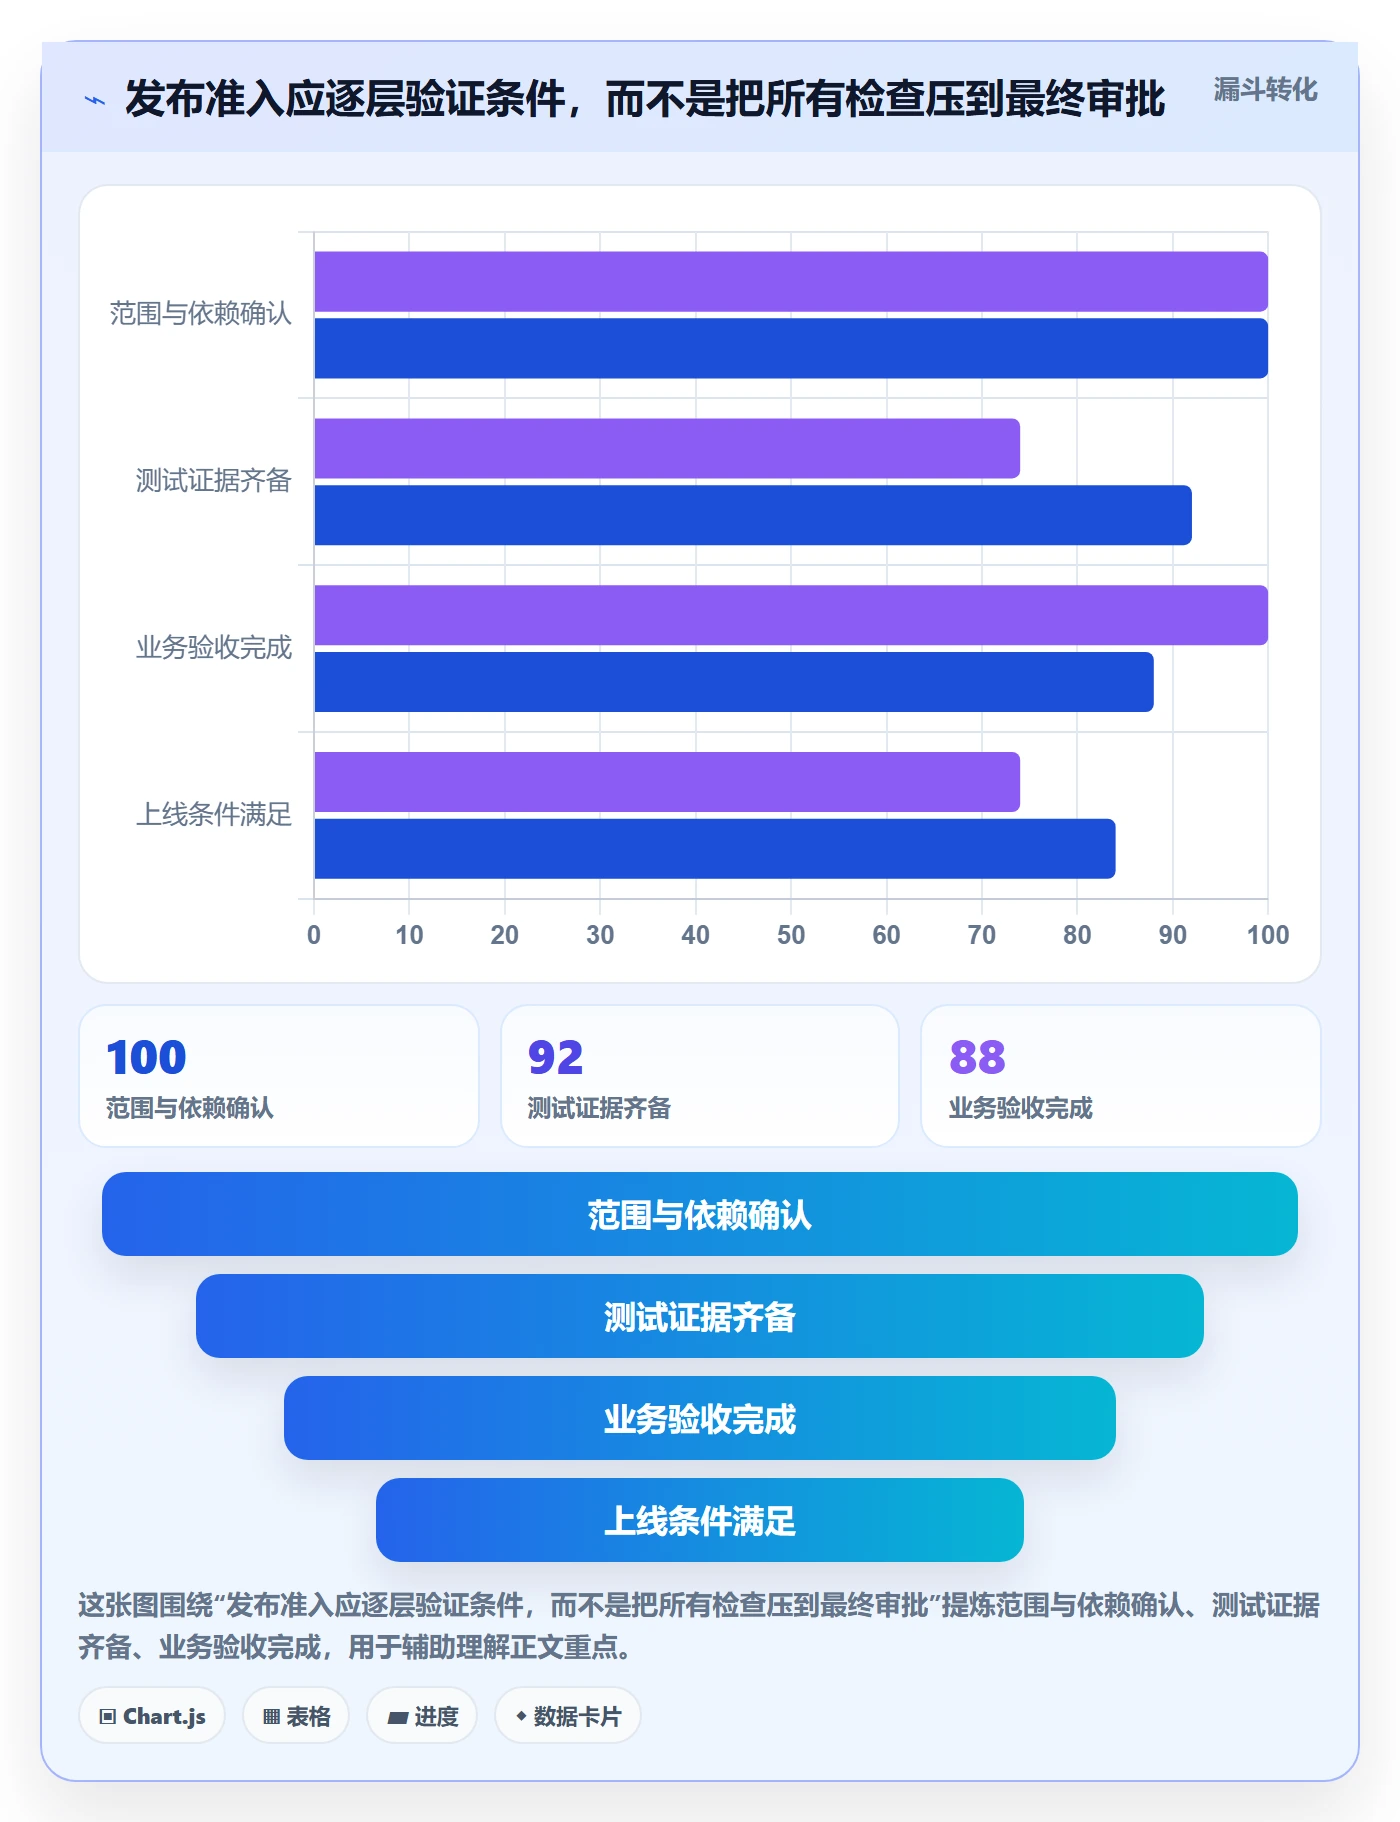
五、案例与数据观察:一个跨团队发布如何从“最后一周救火”转向提前识别
1. 情景设定:把模拟数据当作诊断工具,而不是行业结论
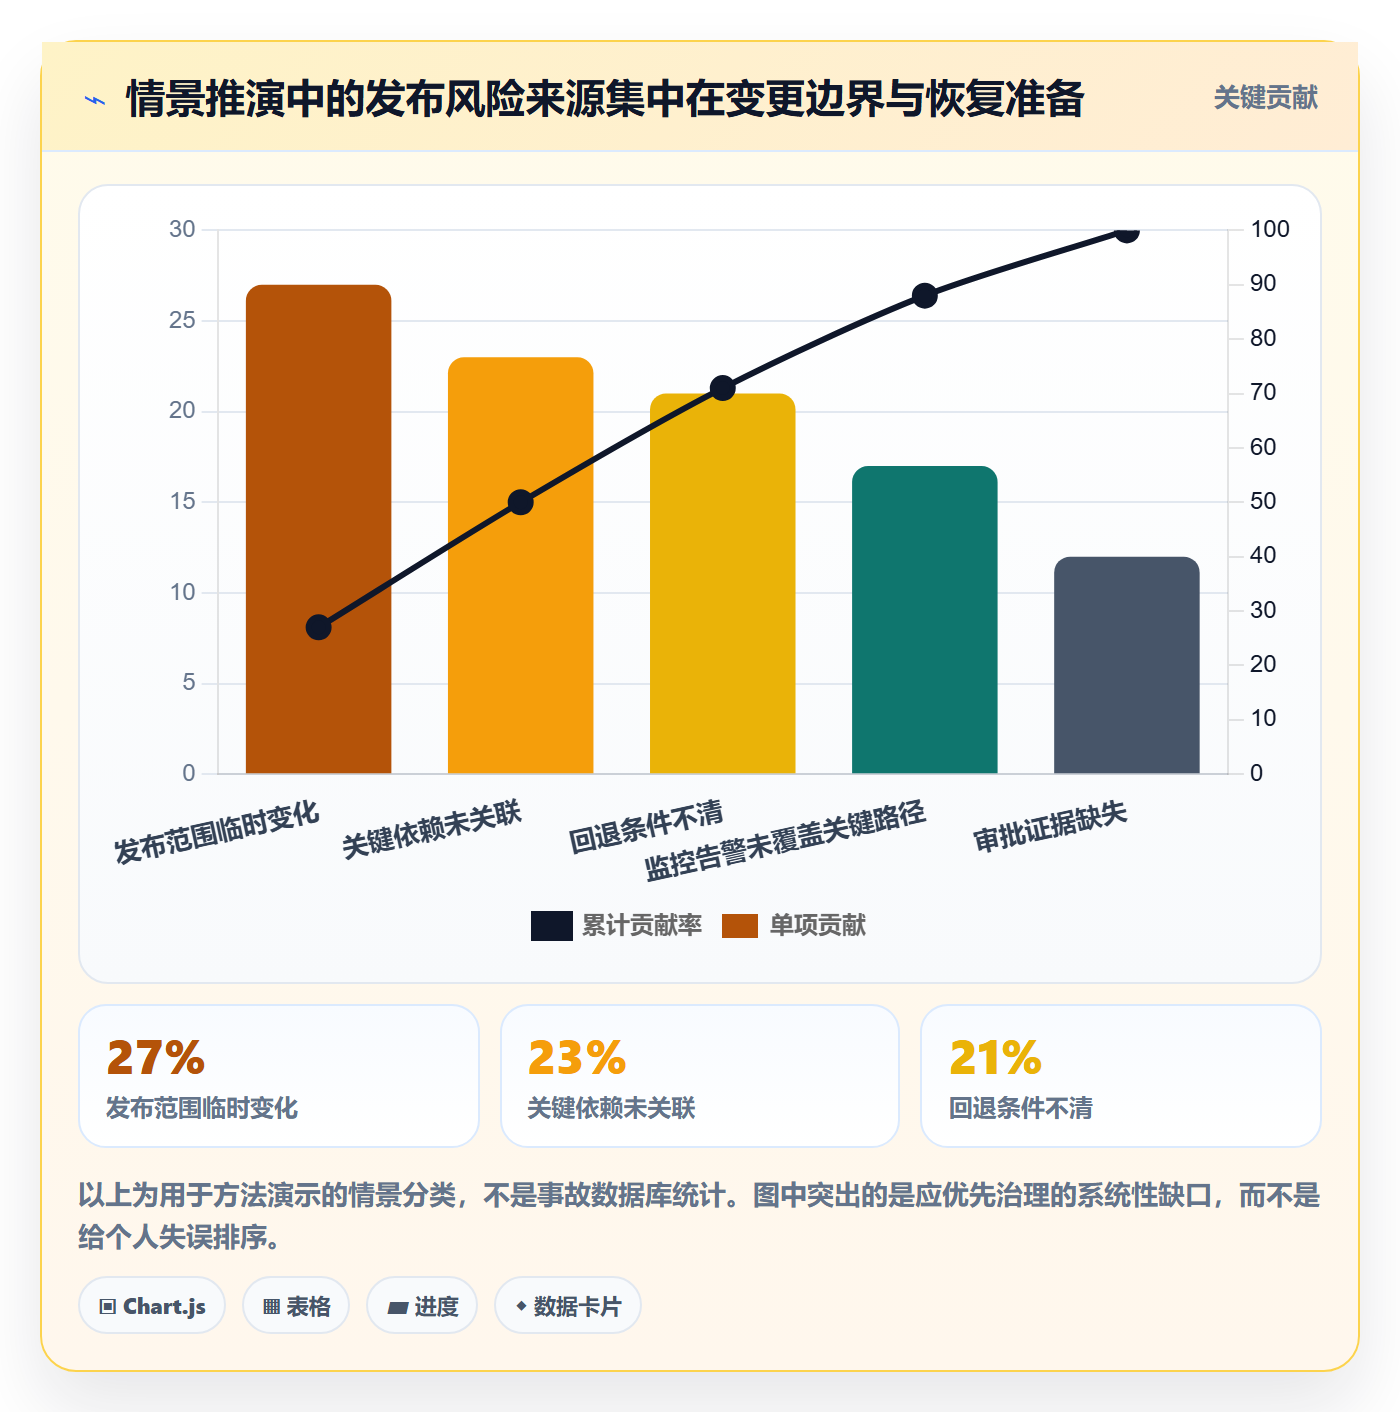
以下案例用于说明分析方法,属于情景模拟,不代表真实企业的统计结果。假设一家拥有多个研发团队的组织,过去三个月完成18次对外发布。管理层最初只看到准时发布率约为三分之二,于是提出“提高到九成”的目标。
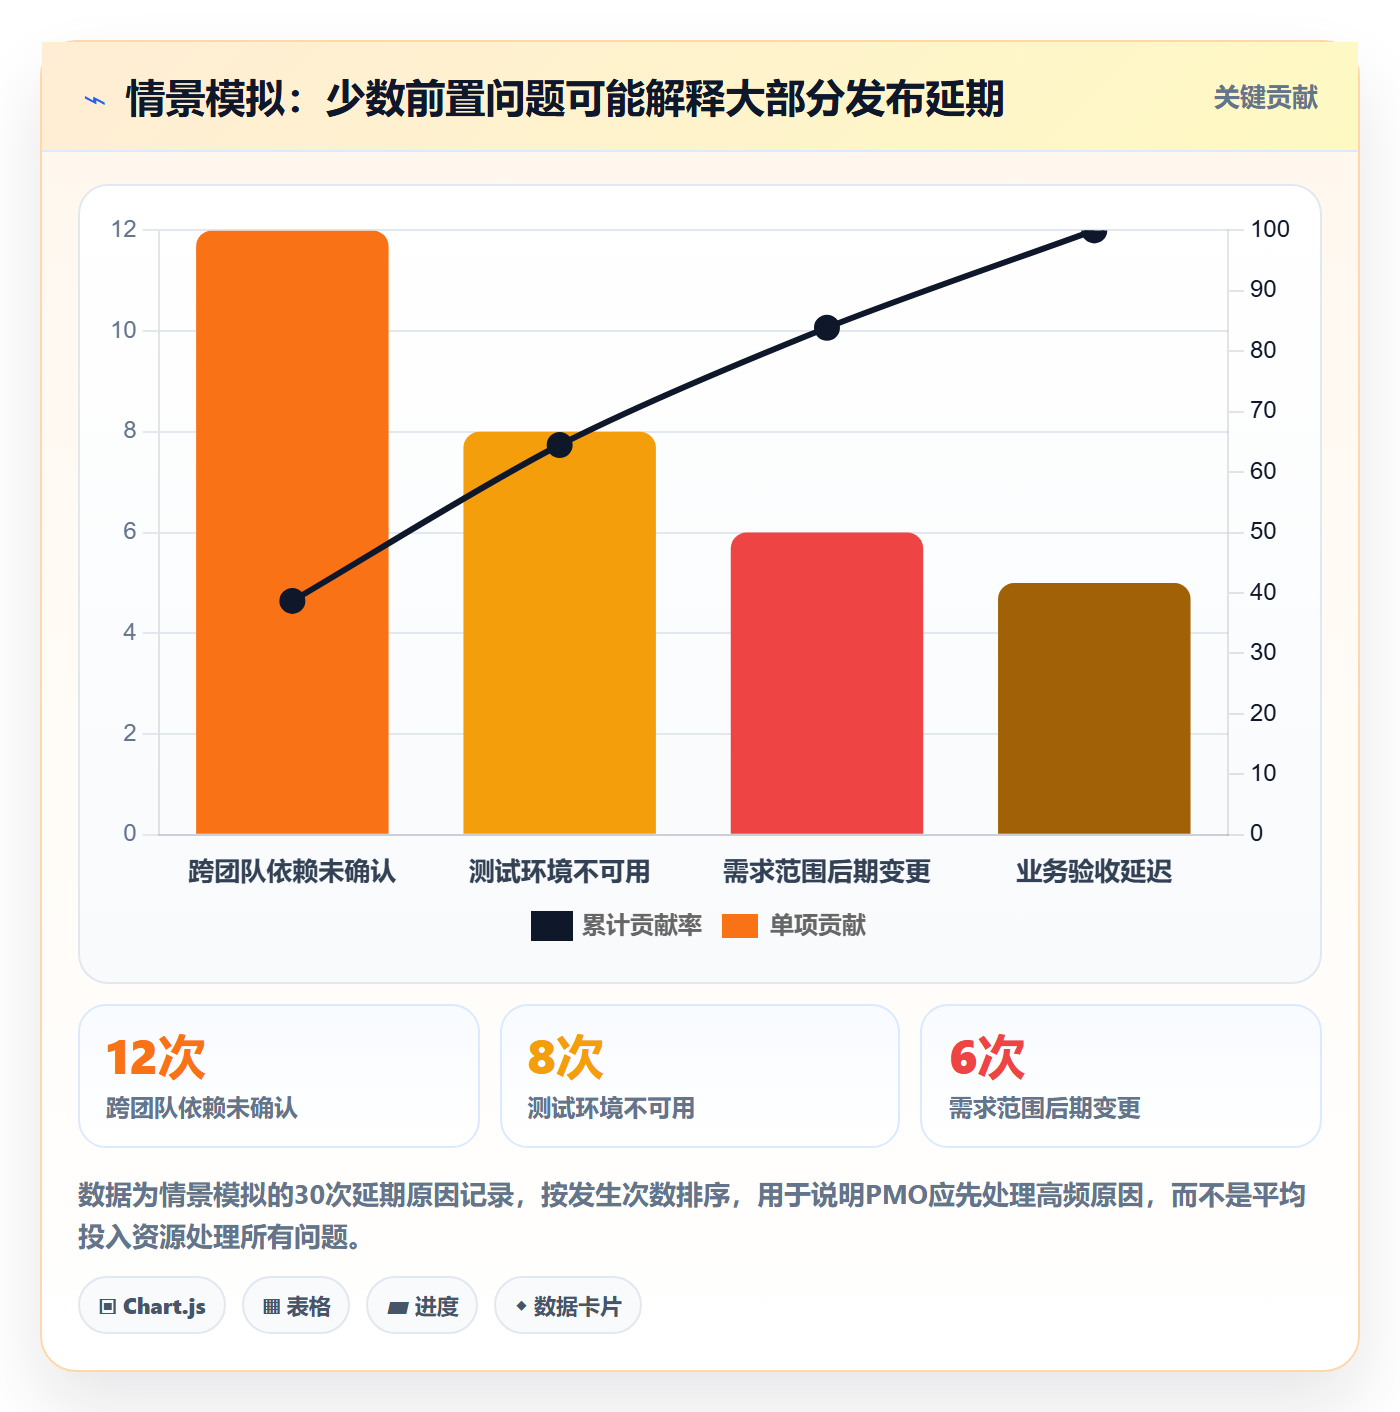
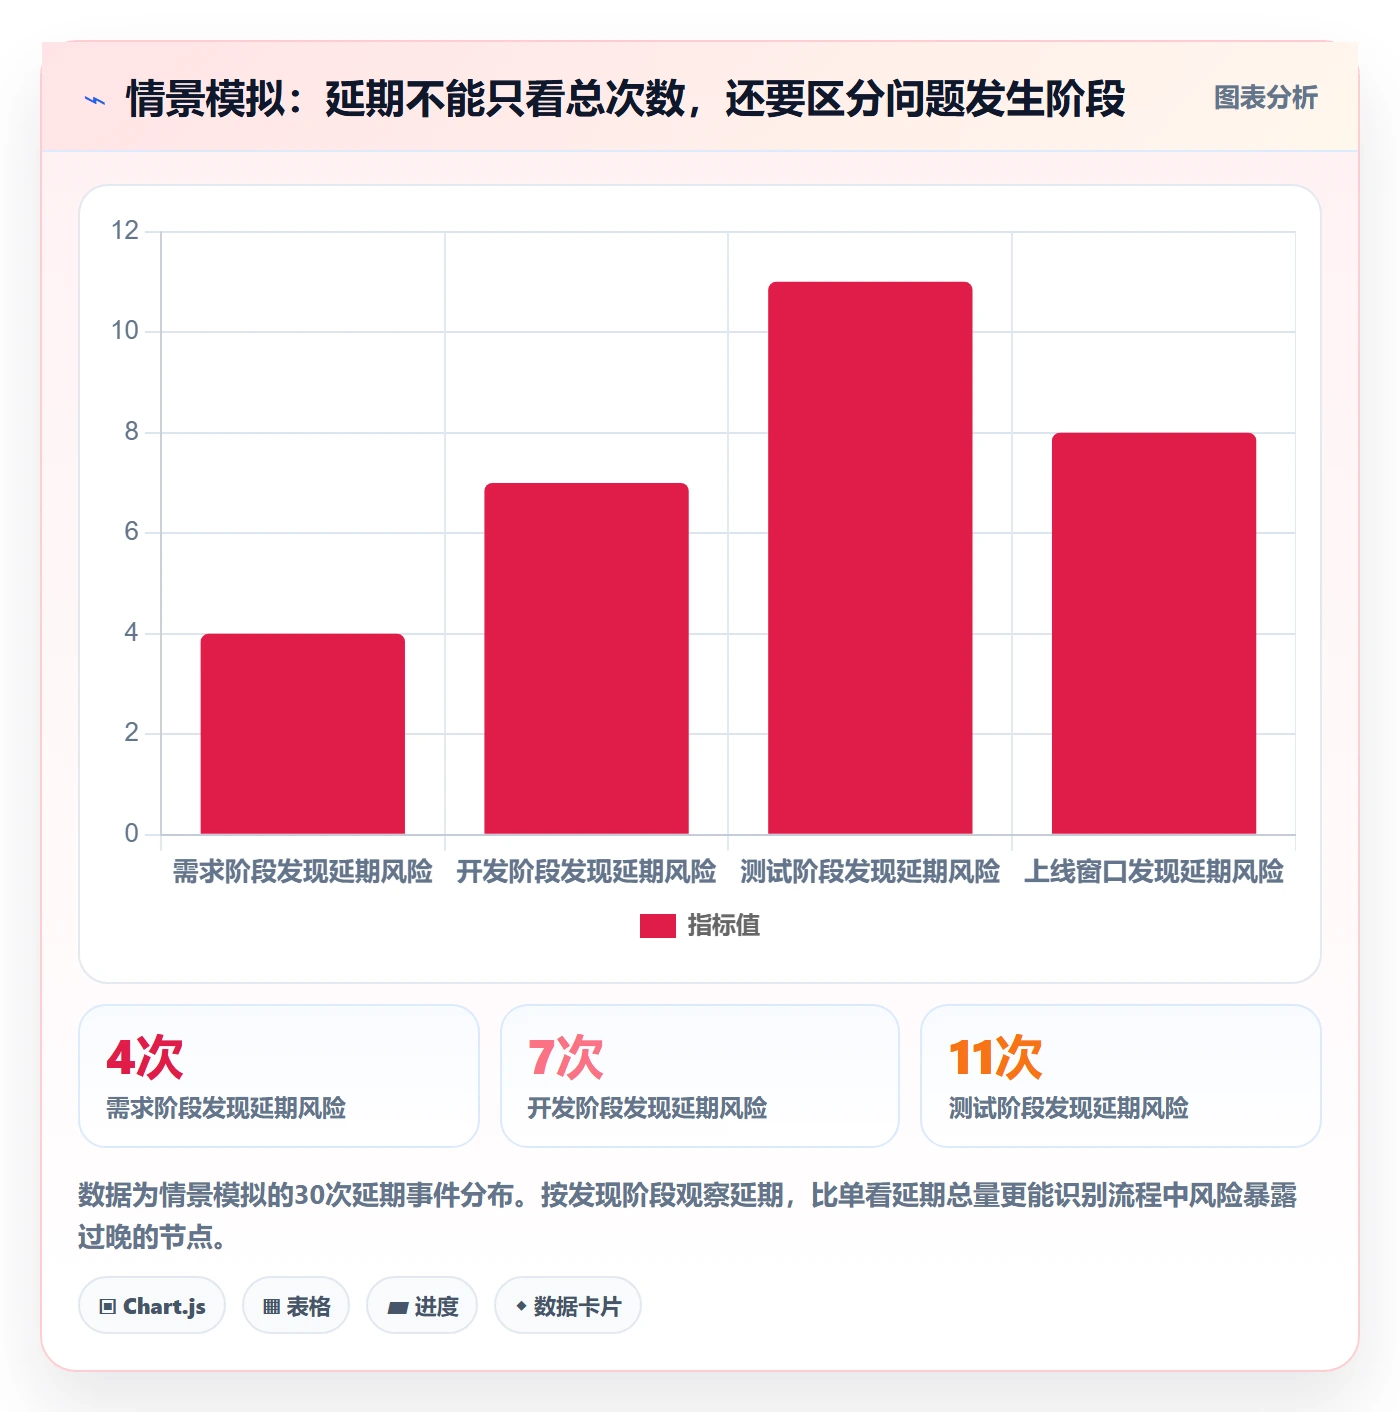
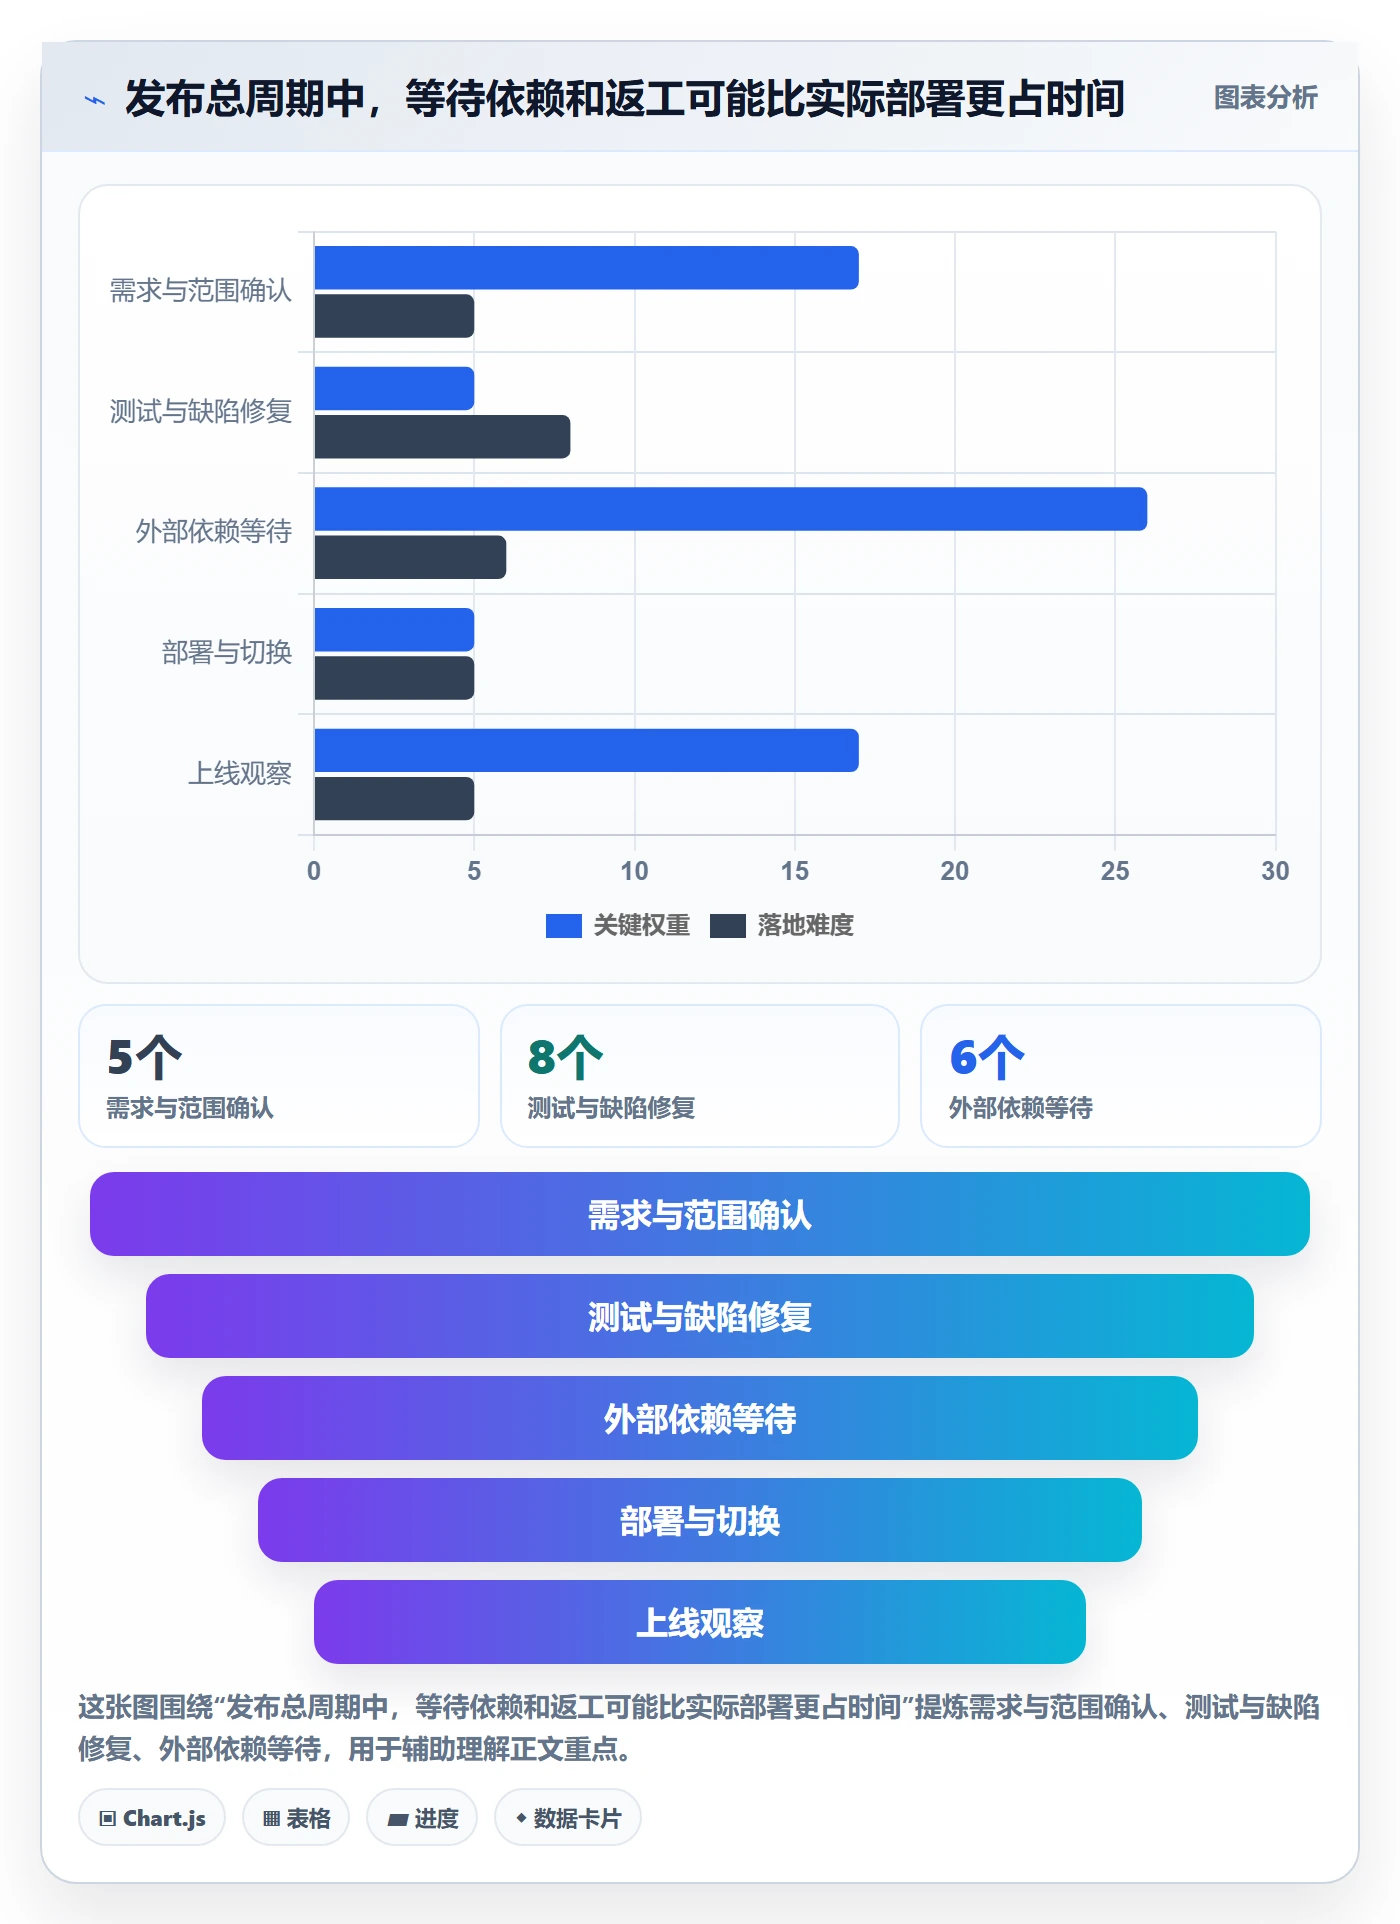
如果只看结果,团队容易直接压缩范围、减少验证或把日期往后重设。PMO进一步按延期原因、风险发现阶段和范围变化拆分后,发现模拟记录中的主要矛盾不是开发速度整体不足,而是跨团队依赖确认晚、测试环境冲突、业务验收安排靠后。
诊断步骤是先统一“延期”的计算口径,再把每次发布关联到承诺范围和变更历史;接着核对风险首次发现时间、实际决策时间以及处理结果。只有当事件链完整,才能判断问题出在估算、依赖协调、测试准备还是决策机制。
2. 从单一结果指标,转向能说明原因的过程指标
在模拟样本中,PMO把18次发布拆成三个观察维度:计划窗口变化、范围基线变化和上线后质量事件。这样一来,管理层不再只问“为什么没按时”,而能进一步问“延期是不是由后期范围变化造成”“是否有风险长期存在但未升级”“准入豁免是否与上线问题相关”。
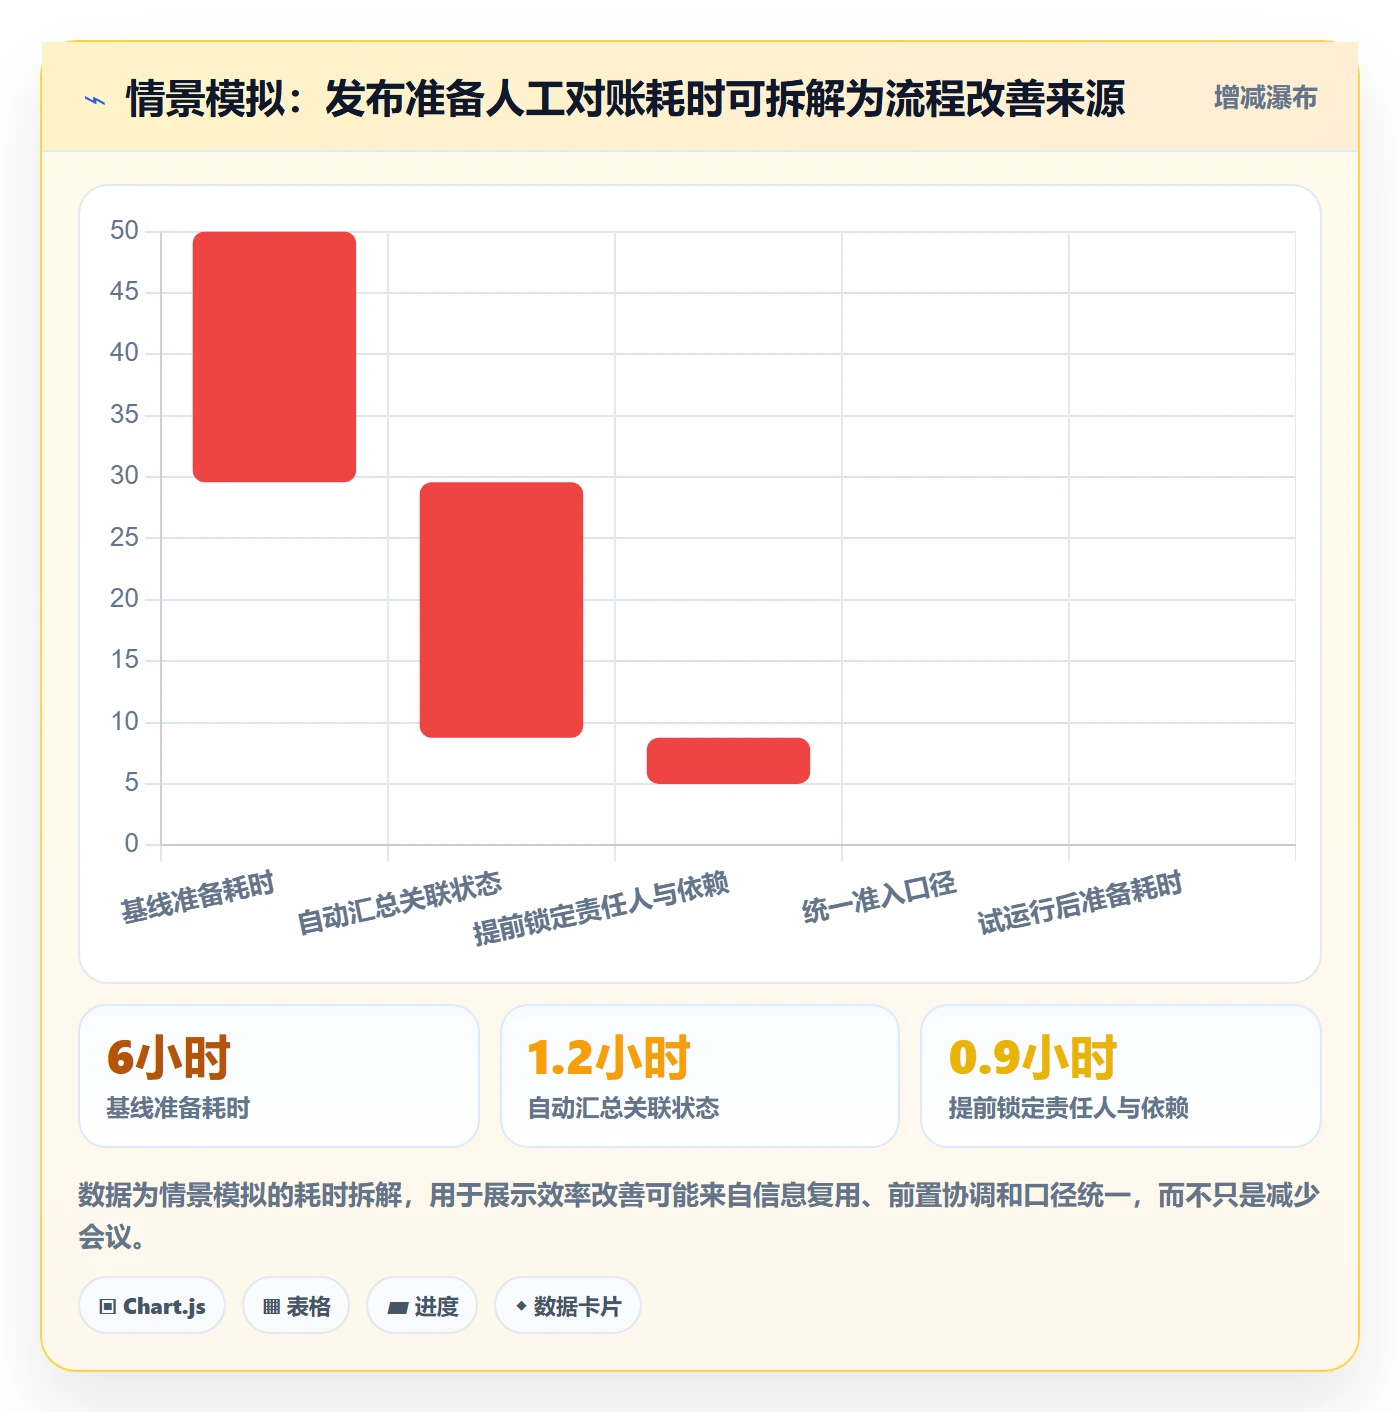
下表数据是便于演示分析方式的情景模拟。实际落地时,应由组织自己的发布记录计算,并明确每个指标的分母和统计窗口。
| 观察指标 | 初始模拟值 | 试运行后模拟值 | 解读方式 |
|---|---|---|---|
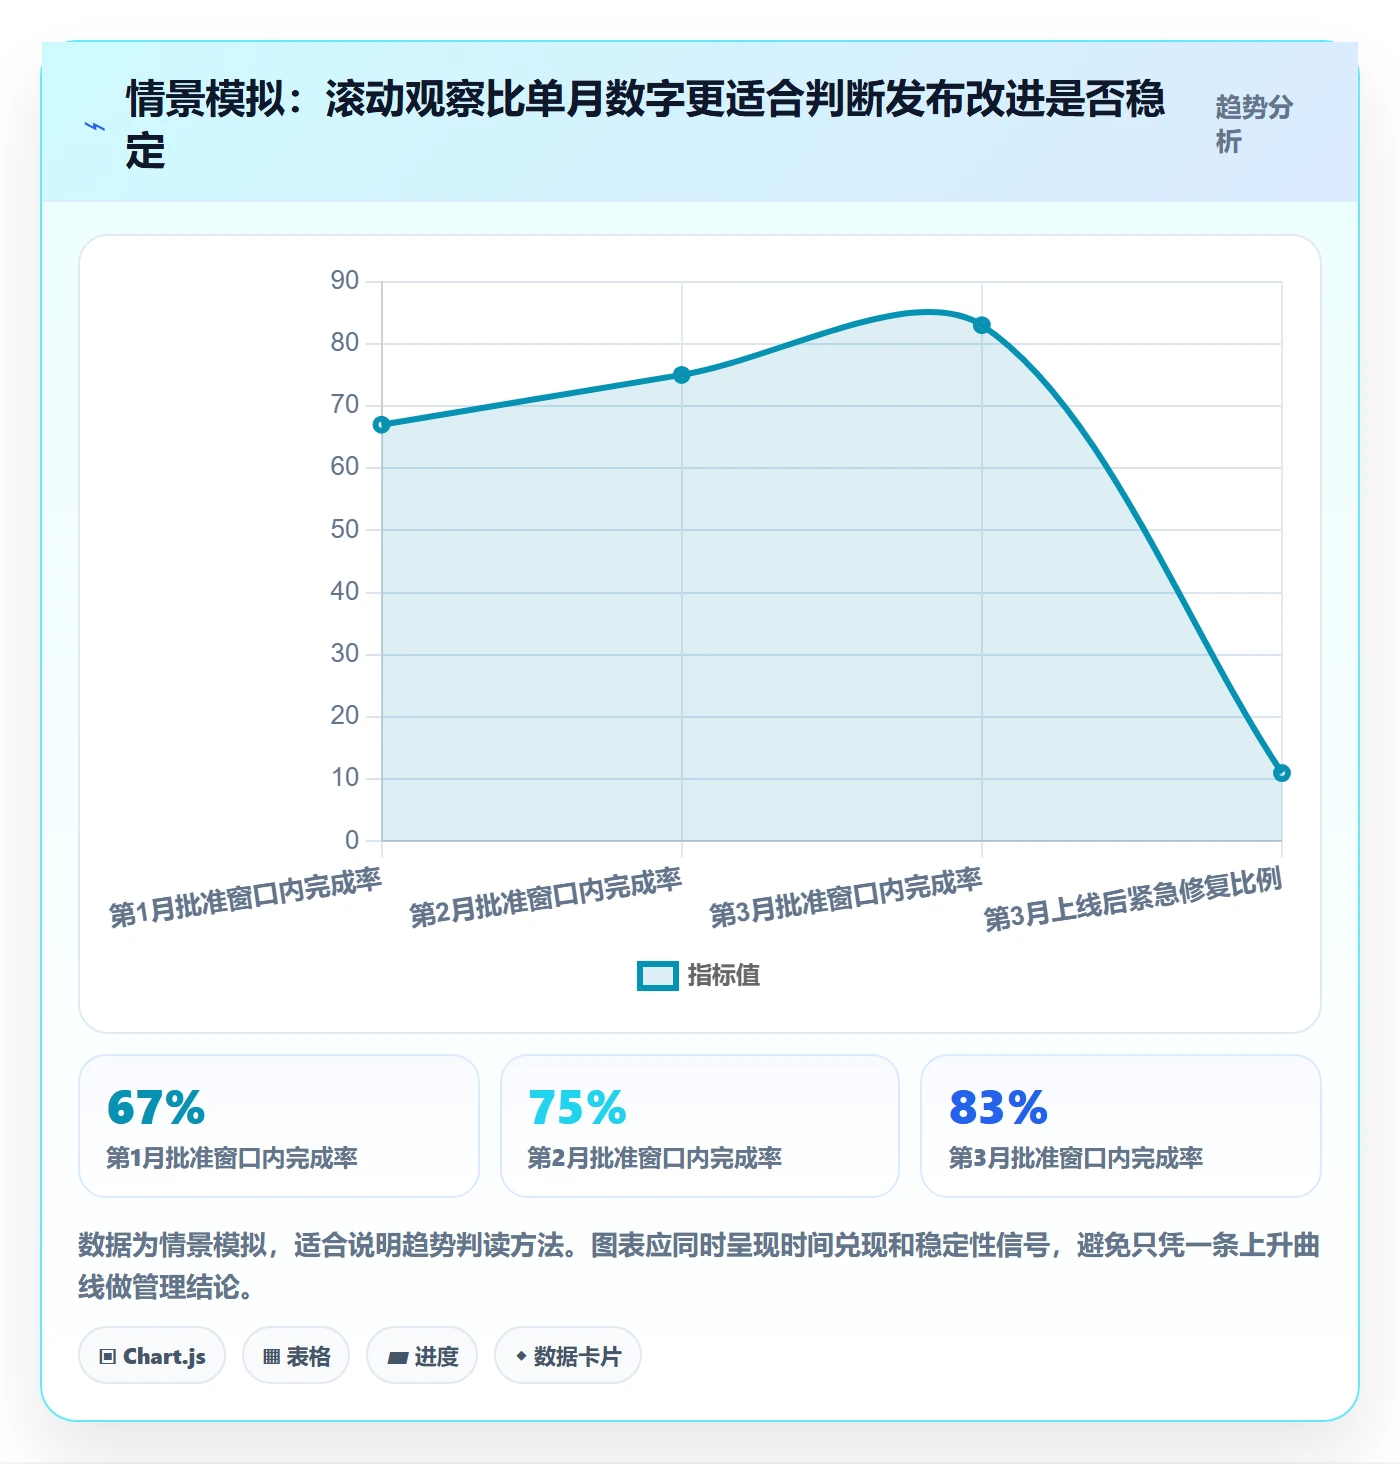
| 批准窗口内完成率 | 67% | 83% | 观察计划兑现改善,同时检查是否通过推迟批准日期获得表面提升。 |
| 基线后范围变更率 | 24% | 13% | 观察范围稳定性,需排除纯文档修正,聚焦实质性新增和移除。 |
| 测试阶段首次暴露的高风险项 | 每次发布平均4.2项 | 每次发布平均2.5项 | 反映风险是否更早被发现,不能简单理解为测试发现问题越少越好。 |
| 上线后紧急修复发布比例 | 22% | 11% | 观察线上稳定性变化,并核查缺陷归属与观察窗口是否一致。 |
| 发布准备人工对账耗时 | 每次6小时 | 每次2.5小时 | 衡量信息整合成本,需记录参与角色和是否把工作转移到其他团队。 |
这些数字不能证明某个流程一定有效,因为样本小、项目难度可能不同,也可能存在业务季节性。它们更适合作为观察起点:若多个方向同时改善,且工作量、风险级别和统计口径相近,才值得继续验证流程是否带来稳定收益。
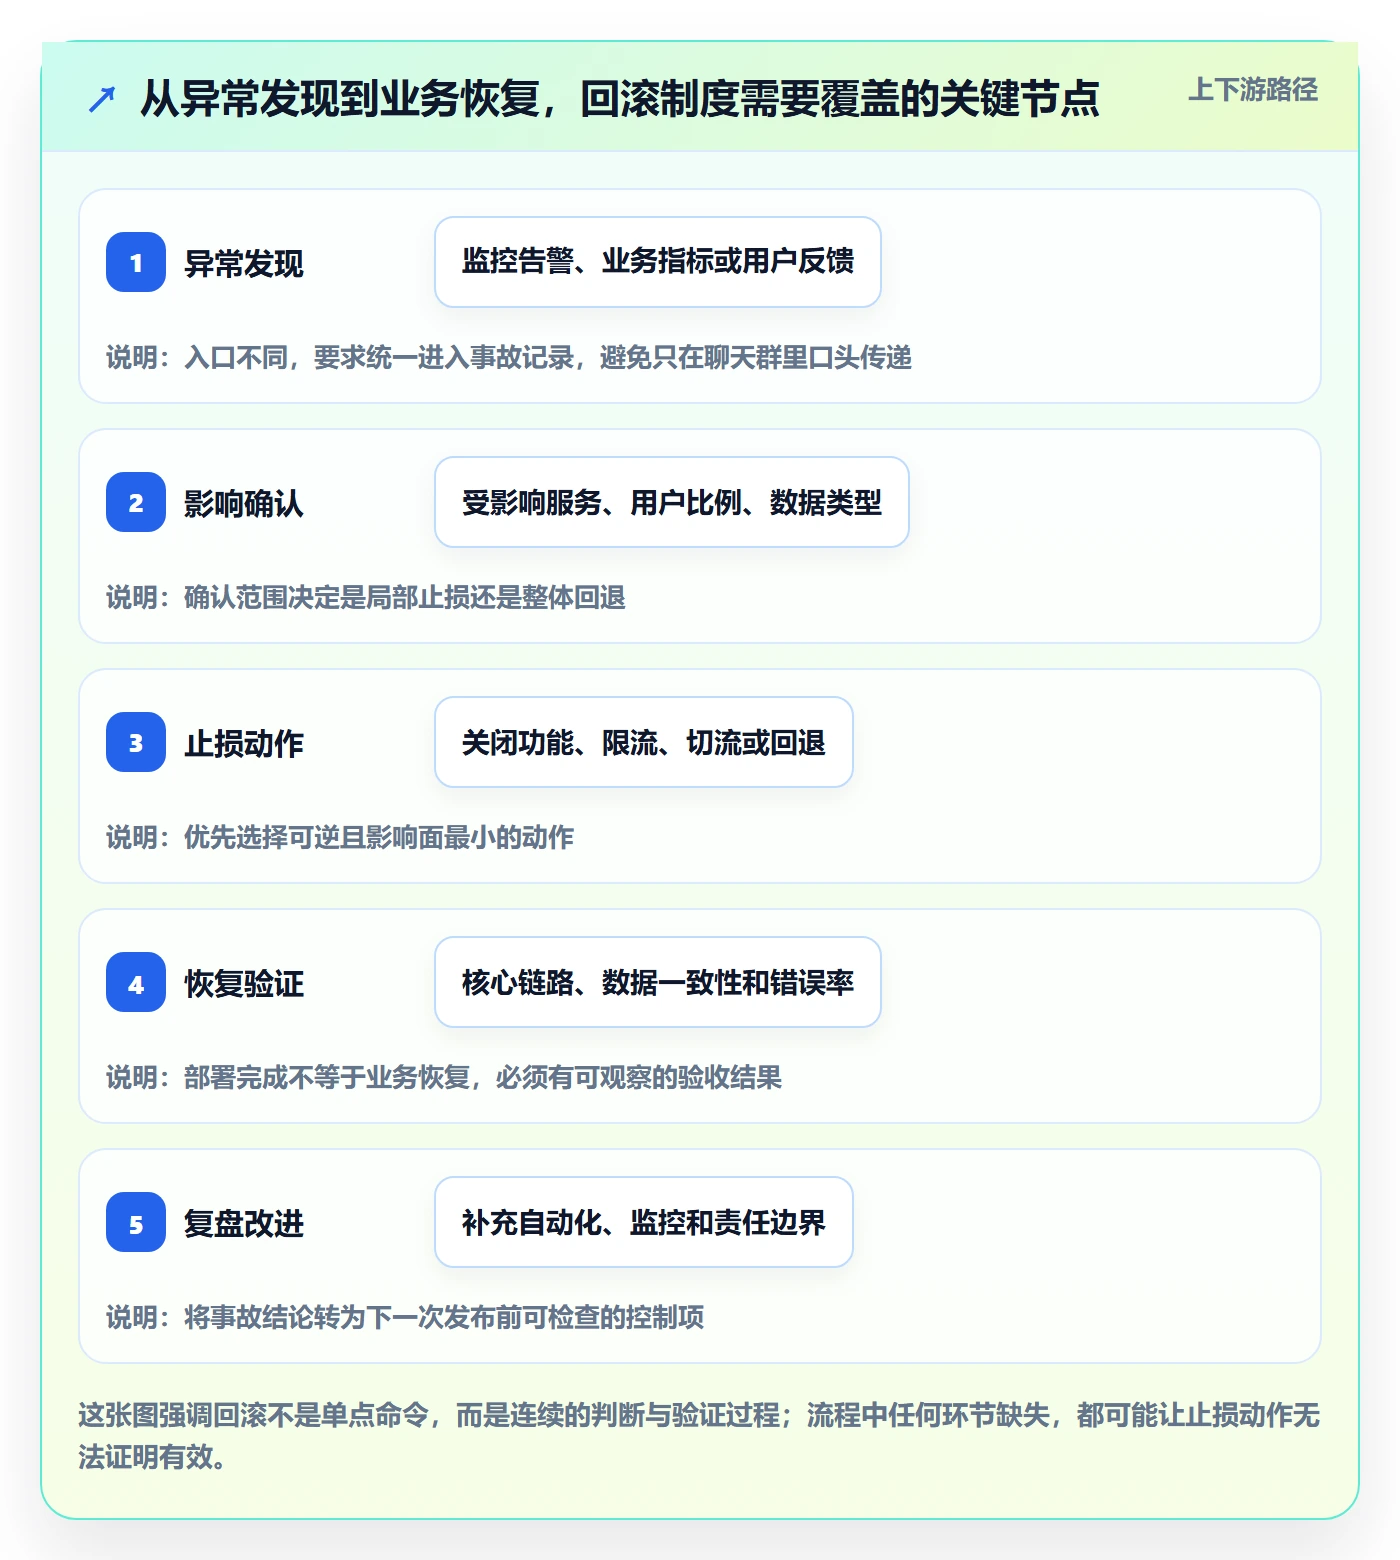
3. 关键变化不是“多开一次会”,而是把风险提前到可处理的时间点
试运行期间,组织可以在发布前两周进行一次范围与依赖检查,在发布前一周进行一次风险和验证准备检查,临近上线再做准入决策。检查不是增加层层审批,而是把原本最后一周才出现的信息拆散到更早的节点。
如果前置检查发现依赖团队未确认,PMO可以协调责任人与完成日期;如果测试环境尚未安排,团队有机会调整窗口或准备替代环境;如果业务验收人没有时间,发布范围就可以提前调整。越早发现,越可能通过低成本选项解决。
这里有一个重要的反直觉点:发布会次数增加,未必意味着管理更成熟;但风险发现时间提前、临时豁免减少、上线后紧急修复下降,往往比会议数量更能说明机制有效。要观察的是决策质量和返工成本,不是流程活动数量。
4. 如何避免用短期波动误判改进成效
发布样本量不大时,单月数据容易受重大项目、节假日和人员变动影响。PMO可以使用滚动周期观察,例如按最近三个月或最近若干次同类型发布计算,并把高风险发布与常规发布分开看。
还应保留基线和变更记录。若试运行期间组织同时更换测试工具、调整团队结构或改变发布策略,指标变化就不能直接归因于发布管理。数据分析的价值不在于把改善都归功于流程,而在于尽量识别哪些变化可能相关、哪些变化仍无法判断。
对外报告时,应给出样本数、统计窗口、指标定义和重要限制。例如“最近三个月18次发布,按批准窗口计算,其中15次按期完成”,比“准时率提升16个百分点”更有解释力。PMO需要让管理者知道数字能说明什么,也知道它不能说明什么。
六、从0到1的落地路线:先跑起来,再把有效做法固化
1. 第一步:用两周梳理现有发布事实,不急着设计理想流程
启动时先访谈研发、测试、产品、运维和业务负责人,梳理近几次发布的真实路径:谁提出版本计划,范围何时冻结,依赖如何确认,谁决定延期,问题在哪里记录。不要只听制度描述,应抽查实际发布记录,确认流程文件与现场做法是否一致。
这一阶段的产出不必是一份厚重规范。优先形成一张现状流程图、一份关键术语表、一份常见延期原因清单,以及一份当前可采集数据清单。PMO要识别的是重复劳动、责任空档和信息断点。
2. 第二步:选一个有代表性的试点,而不是选最简单的团队
试点需要既有足够复杂度,又有愿意合作的负责人。只选最简单的团队,无法验证依赖管理和风险升级机制;一开始就选择最高风险的重大系统,则可能把试运行变成高压审批项目。较稳妥的选择是一个涉及两个以上团队、发布节奏相对稳定、负责人愿意复盘的产品或业务域。
试点前要明确本轮要验证什么。例如:是否能提前识别未确认依赖,是否减少发布准备的人工对账时间,是否让延期原因可分类。目标越具体,越容易判断机制是否有效,也更容易在复盘时决定保留什么。
3. 第三步:建立一页纸发布卡片和统一风险台账
发布卡片不是把所有项目资料塞到一起,而是让参与者快速看到关键事实。建议包含发布编号、目标与范围、重要变化、负责人、窗口、依赖、风险、测试证据、业务验收、回退方式和决策状态。
风险台账应记录风险描述、影响范围、发生概率或等级、责任人、应对动作、截止时间、升级条件和当前状态。不要把风险写成“需要关注”或“持续跟进”,这类描述无法驱动行动。应写成“外部接口团队尚未确认周三前完成联调;若周四仍未通过,移出本次范围并启动替代路径”。
4. 第四步:用固定节奏管理信息,而不是等到发布会才收集
发布节奏可以按团队交付周期调整,但应有明确的信息更新时间。比如每周更新范围与依赖,关键节点更新测试证据和风险,发布前一周确认业务验收和运维准备,临近上线时只处理仍未关闭的例外和决策。
如果每次会议前都靠PMO私聊收集状态,机制就无法规模化。让责任人直接更新与自己相关的信息,并在系统中保留变更记录;PMO检查完整性、识别冲突和升级风险。若用某项目管理平台统一关联工作项,可以减少重复录入,但应先确定字段和状态含义,避免把旧流程原样搬进工具。
5. 第五步:复盘采用“事实,原因,机制,行动”结构
一次发布复盘不必追求追责式的根因分析,也不能停留在“沟通不及时”。建议按四步展开:发生了什么事实,为什么会发生,哪项机制没有拦住或加速暴露,下一次具体改变什么。
- 事实:记录计划与实际时间、范围变化、准入豁免、缺陷与回退情况。
- 原因:区分估算偏差、依赖未确认、环境问题、验收延迟、技术风险和外部变化。
- 机制:判断问题是否由于口径不清、检查节点缺失、责任不明或升级路径过长。
- 行动:写明负责人、完成时间、验证方式,以及何时确认改动有效。
复盘行动项要有关闭标准。比如“优化测试准备”过于抽象;“在版本范围冻结后一周内完成测试数据准备,并由测试负责人确认可用”更容易核验。连续多个发布重复发生同类问题时,应检查是否需要改系统机制,而不是每次只增加一项提醒。
6. 第六步:试点结束后只扩大已验证的控制点
试点结束时,不必把所有模板、会议和字段一次性推广。先回顾哪些做法实际减少了风险、哪些只是新增填表、哪些指标无法稳定计算。经过验证后,再将有效口径推广到同类团队,并保留不同风险等级的弹性。
扩展阶段要关注数据质量和采用情况。如果一线团队大量填入“未知”“不适用”,或每次更新都需要PMO代填,说明字段设计可能不符合工作流。流程能否被日常工作自然使用,比制度文件是否完整更能预测推广成败。
七、不同情况下的行动建议:按组织成熟度和发布风险做选择
1. 团队少、发布频率低:先做可追溯,不要先上复杂治理
如果组织只有少数团队、每月发布不多,先用一份统一发布台账即可。关键是让计划范围、责任人、风险、准入结论和实际结果可追溯。团队规模小并不意味着可以忽略回退方案,尤其是涉及数据变更和客户核心流程的发布。
此时不建议设置过多审批层级,也不必为了“数据化”而搭建大型仪表盘。先积累足够的发布记录,再找出高频问题。没有稳定数据输入的仪表盘,只会把人工判断包装成精确数字。
2. 团队多、依赖复杂:重点建设共同口径和跨团队责任机制
当多个团队共享接口、环境、数据服务或发布窗口时,PMO应优先统一状态定义、依赖责任人和升级时限。跨团队依赖不能只写“等待某团队”,必须明确谁接收、何时确认、未完成时如何处理,以及是否影响范围或窗口。
这类组织适合把发布标识与需求、缺陷、测试、变更和部署记录关联起来。若使用PingCode等某项目管理平台,应先确认它是否支持组织需要的关联和视图,再评估配置成本、权限治理和数据维护责任。平台部署不是发布治理的替代品,更不是流程成效的证明。
3. 发布风险高、回退困难:把演练和分批验证放在日期之前
对数据迁移、核心交易、涉及监管要求或回退成本高的发布,准入重点应从“文件是否齐全”转为“关键路径是否验证”。要确认备份与恢复方法,演练回退或前向修复,评估分批放量条件,准备监控指标和应急联系人。
如果技术上无法安全回退,就要明确替代补救路径和决策时限。没有回退能力并不自动意味着不能发布,但意味着组织必须更充分地验证前置条件,并设置更严格的风险接受机制。
4. 业务窗口固定、日期不可轻易调整:早期管理范围和决策时点
有些发布必须赶在业务活动、合同节点或窗口期前完成,延期成本很高。此时不要等到临近上线才集中加人,而应更早冻结核心范围,设置范围变更的影响评估和批准规则,并为关键依赖预留缓冲。
固定窗口不等于质量门槛可以降低。更实际的办法是定义核心范围和可选范围:核心范围满足准入后按期发布,非核心能力在条件不足时移出。必须记录删减影响,确保团队没有把必要的安全、合规或稳定性工作误标为“可选项”。
5. 组织已经使用管理平台:先检查数据链路,再追加自动化
如果已经使用工作管理平台或发布工具,先看版本、需求、缺陷、测试和部署记录是否能关联,关键状态是否有统一定义,历史数据是否可信。若同一个发布的状态要在多个系统中手工重复更新,自动化可能只是更快地传播不一致信息。
自动化适合处理重复、规则清晰、低判断成本的工作,例如提醒未确认依赖、汇总风险状态、生成准入清单。涉及风险接受、范围取舍和业务影响判断的事项,仍需明确由具备权限的人作出决定。
八、不同情况下的取舍:发布管理不可能同时把所有目标推到最高
1. 速度与控制:控制要盯住高影响风险,不要平均加码
增加检查通常会消耗时间,因此需要判断它是否能降低足够多的风险。低影响、可快速回退的变更,可以采用轻量准入;高影响、难回退的变更,应要求更多验证证据。将所有发布都按最高风险治理,看似安全,实际上会使团队绕流程、降低信息质量。
在速度与控制之间,我会优先保留能够显著改变决策质量的检查:关键依赖确认、风险状态透明、回退或补救路径明确、业务验收责任清楚。对重复抄写和纯形式签字,则应持续评估是否可以取消或自动化。
2. 可比性与适配性:先统一定义,再允许按风险分组
组织需要共同指标,才能识别系统性问题;但不同团队的工作性质又不适合被完全等同。解决办法不是放弃统一,也不是强行用一个口径解释所有业务,而是统一核心定义,再按产品类型、风险等级、发布规模和交付方式分组分析。
例如,实际完成时间和紧急修复的定义可以统一;但不同风险级别的准入证据、发布窗口和观察期,可以有差异。比较时必须展示分组,避免用整体平均数掩盖结构差异。
3. 承诺稳定与范围灵活:稳定基线,但允许有证据的变更
范围冻结能够提高计划可预测性,但业务变化和故障修复不可能完全禁止。正确做法不是把范围锁死,而是建立变更规则:变更前说明原因、工作量影响、测试影响、依赖影响和对日期的影响,再由合适角色批准。
如果变更足以改变风险级别或上线窗口,应重新进行准入判断。这样既保留业务灵活性,也避免团队在没有重新评估的情况下,把新工作偷偷塞进既定承诺。
4. 数据精细度与维护成本:先采集能改变行动的数据
数据越细,理论上越能解释差异,但维护成本也越高。早期应优先采集会影响决策的数据:日期、范围变化、关键依赖、风险、缺陷严重度、准入结论和回退情况。每新增一个字段,都要回答它是否能触发行动、支持分析或满足必要的审计要求。
如果某个字段长期没人使用、定义经常争议、也不影响任何决策,就应考虑简化。指标治理不是收集尽可能多的信息,而是以可接受的维护成本获得可靠且能行动的信息。
九、结尾:先让风险早一点出现,再谈发布管理成熟度
1. 真正的0到1,不是把流程写出来,而是把闭环跑出来
发布管理的起点不是买工具,也不是发布一份制度,而是把一次交付的承诺、风险、决策和结果连接起来。PMO先统一定义和责任,再建立轻量准入与复盘;通过试点证明哪些控制能减少临时救火,再逐步扩大应用范围。
如果只能从一件事开始,我建议先挑最近几次发布,把计划日期、实际日期、范围变化、延期原因、上线后问题和回退情况放到同一条时间线上。团队通常会很快看到:最值得改的地方,不一定是开发速度,而可能是风险出现得太晚、依赖没人负责,或决策没有明确的证据门槛。
2. 下一步行动:用一次复盘建立第一版发布管理基线
接下来可以按这个顺序行动:选择一个跨团队但可控的试点;收集最近几次发布记录;定义范围、日期、风险和质量口径;建立一页纸发布卡片;安排前置检查和上线准入;记录决策与例外;在试点结束后用同一口径复算指标。
我最看重的不是第一次就把流程设计得无懈可击,而是让下一次发布比上一次更早知道风险、更少依赖临时救火,并能解释结果为什么变好或变差。当组织具备这三种能力,发布管理才真正从0走向1。
常见问题解答(FAQ)
1. 发布管理从0到1,第一步应该先建流程还是先做数据分析?
我刚接手发布管理,团队里有人想先上审批流程,也有人认为应该先把数据看清楚。我担心流程设计得很完整,实际却没人照做;到底应该从哪里开始,才能避免做成一套纸面制度?
先统一“什么算一次发布”,再补最小流程和数据,不要一开始就设计复杂审批。建议用一周盘点近三个月的上线记录,至少收集计划时间、实际时间、变更范围、测试结果、故障与回滚情况;如果历史记录不全,就先从下一次发布开始人工登记。
随后建立一条最小链路:提出发布申请、确认范围与负责人、完成验证、评估风险、执行上线、观察结果并复盘。判断流程是否可用,不看审批节点数量,而看每次发布能否回答三个问题:改了什么、谁负责、出问题如何恢复。
2. PMO 做发布管理,最值得优先跟踪哪些指标?
我看到过不少发布看板,指标很多,但开会时还是说不清发布到底稳不稳。有的团队把按时上线当成成功,有的团队更关注故障;我应该选哪些指标,才能让数据真正支持决策?
起步阶段优先跟踪四类指标:计划发布完成率、发布变更失败率、发布后故障数、回滚或紧急修复次数。每个指标先写清分子、分母和统计窗口,例如“发布变更失败率=导致回滚、故障或紧急修复的发布次数÷已完成发布次数”,并统一按发布批次统计,避免把一个批次拆成多个工单后虚增分母。
建议先连续观察四周建立基线,再看趋势;例如失败率从8%升到15%,要进一步按系统、变更类型和发布时段切分,不能只凭总体数字归责。指标是定位风险的入口,不是团队绩效排名的替代品。
3. 发布流程怎样设计,才不会变成“审批很多、风险照旧”?
我所在团队的上线流程已经有多层审批,但临近发布时仍会出现测试未完成、依赖方不知情的情况。我想知道哪些检查必须前置,哪些审批其实可以删掉,才能既控制风险又不拖慢交付?
把控制点放在会改变发布决策的位置,而不是每个环节都加签字。发布前至少确认变更范围、依赖与影响对象、测试证据、监控指标、负责人和回退方案;高风险变更再增加灰度、业务确认或变更窗口要求。可以按风险分层:低风险、可独立回退的常规变更走轻量检查;
涉及数据结构、多个系统依赖或不可逆操作的变更,要求分阶段执行并明确停止条件。一个实用判断是:某个审批若不能指出具体风险、证据或决策责任,就应考虑合并或改成自动校验。
4. 发布后复盘怎么做,才能从故障记录变成可执行改进?
我们每次出问题都会开复盘会,也会记录原因,但类似问题隔几个月又出现。我不确定是复盘深度不够,还是后续跟踪没有闭环;怎样让复盘结果真正改变下一次发布?
复盘不要止于“加强测试”或“提高意识”,要把事件还原成可验证的因果链:哪个信号没有被发现、哪个检查点失效、影响持续多久、回退为何成功或受阻。每项改进都指定负责人、截止日期和验收证据,例如把人工核对依赖项改成发布前自动检查,并统计后续四周的漏检次数。
PMO 可以每月汇总重复故障类型、改进按期完成率和改进后复发率;若行动项完成率高但复发率不降,说明改进措施可能只补了文档,没有改变实际控制点。
核心关键词
文章包含AI辅助创作:发布怎么做?PMO数据分析:发布管理从0到1,发布者:飞飞,转载请注明出处:https://worktile.com/solution-1/archives/520725

读者评论
我们之前也把准时率当核心指标,后来发现团队会不断调整发布日期,数字好看了,预测能力却没变。把最初计划和每次调整都留痕,确实更能看出问题出在哪。
分级准入比较实用。小修复如果也要走完整审批,大家容易绕流程;但涉及数据迁移的发布,回退方案和验证责任最好提前明确。
文中提到上线后观察窗口,我觉得还要考虑业务指标多久才有变化。有些功能24小时内看不出效果,若统一用短周期复盘,可能会把暂时没有反馈误判为无效。