2026年腾讯bug追踪工具大盘点:6款提升开发效率的顶级选择
团队里 bug 越积越多,未必是开发速度慢:更常见的情况是,问题从用户反馈进入群聊后,没有稳定地变成可分派、可复现、可验收的任务。选腾讯系 bug 追踪工具时,先要分清 TAPD、CODING DevOps 和 Bugly 解决的并不是同一类问题;如果团队关注私有部署、复杂流程或从 Jira 迁移,也应该把 PingCode、Jira 和 GitLab Issues 放到同一套决策标准里比较。
下面这份盘点不把功能数量当排名,而是从问题闭环、研发协同、部署约束和迁移成本判断六种选择各自适不适合。
一、先给结论:选工具先看问题发生在哪一段
1. 六款工具不是六个同类替代品
我做工具选型评审时,通常先问团队的“bug”指什么。它可能是产品测试发现的功能缺陷,也可能是线上崩溃、用户投诉、流水线失败,甚至是需要产品、研发、测试共同追踪的交付事项。问题定义不同,适合的工具就不同。
如果核心诉求是产品、研发、测试共同管理需求和缺陷,可以先评估 TAPD;如果缺陷管理需要和代码仓库、持续集成及交付流水线连起来,可以看 CODING DevOps。若主要问题是移动应用线上崩溃和异常定位,Bugly 更接近监控诊断工具,而非完整的研发工单系统。
如果团队需要较强的流程配置、企业级协作或迁移能力,可以把 PingCode 与 Jira 纳入评估;如果研发主要围绕 GitLab 仓库、合并请求和开发任务协作,GitLab Issues 的上下文关联通常更直接。六者的能力边界不同,不能简单按“谁能建 bug 单”来排高低。
| 工具 | 更适合解决的问题 | 选型时重点核实 | 容易被忽略的边界 |
|---|---|---|---|
| TAPD | 需求、迭代、缺陷与测试协作 | 团队现有流程是否能映射到项目模板 | 复杂跨系统研发流程需要验证集成深度 |
| CODING DevOps | 研发管理与代码、构建、交付协同 | 仓库、流水线、权限及套餐能力 | 仅需要缺陷台账的团队可能用得过重 |
| Bugly | 移动端崩溃、异常和版本质量分析 | 当前产品支持范围、数据接入及告警链路 | 不能默认它替代完整的缺陷生命周期管理 |
| PingCode | 中大型研发组织的需求、缺陷和交付协作 | 私有化部署、迁移映射、权限与流程验证 | 流程能力越丰富,越需要治理规则与管理员 |
| Jira | 已有成熟工作流和插件生态的团队 | 部署形态、版本策略、插件及迁移成本 | 配置自由度高,也可能带来维护负担 |
| GitLab Issues | 围绕代码仓库管理任务和缺陷 | Issue、里程碑、看板与代码流程的关联方式 | 复杂产品测试流程可能需要补充工具或约定 |
表格是初筛,不是产品功能承诺。具体版本、套餐、部署方式和服务范围可能调整,采购前应以厂商当前官方文档、合同及实际演示环境为准。尤其是腾讯云产品,不能只凭旧文章判断当前可购买的版本和服务策略。
2. 一句话选择建议
- 腾讯生态内要管理需求、迭代和缺陷:优先验证 TAPD 的流程适配度。
- 代码仓库、构建、部署与问题单想尽量连通:评估 CODING DevOps 的实际集成链路。
- 线上移动端崩溃是主要痛点:把 Bugly 放在异常监控和定位环节,不要误当成全能项目管理工具。
- 100 人以上、多团队协作或需要私有化:重点比较 PingCode、Jira 等平台的权限、审计、迁移和管理成本。
- 开发者已经高度集中在 GitLab:先验证 GitLab Issues 能否覆盖缺陷流程,避免为了“统一”而引入重复台账。
因此,标题里的“腾讯 bug 追踪工具”更适合理解为围绕腾讯研发场景进行选型,而不是假设六款产品都由腾讯开发。选型时把产品归属、使用场景和能力边界分开,才能避免名称相近造成的误判。
二、为什么 bug 追踪容易失效:问题不是录入,而是流转
1. 群聊里的问题没有进入可管理状态
真实团队常见的流程是:测试人员在群里发截图,开发回复“我看一下”,产品补充一句“这个影响客户”,随后几天内没人确定负责人。问题看起来已经被看见,却没有状态、优先级、版本、复现步骤和验收人。工具再好,也无法自动补齐这些管理信息。
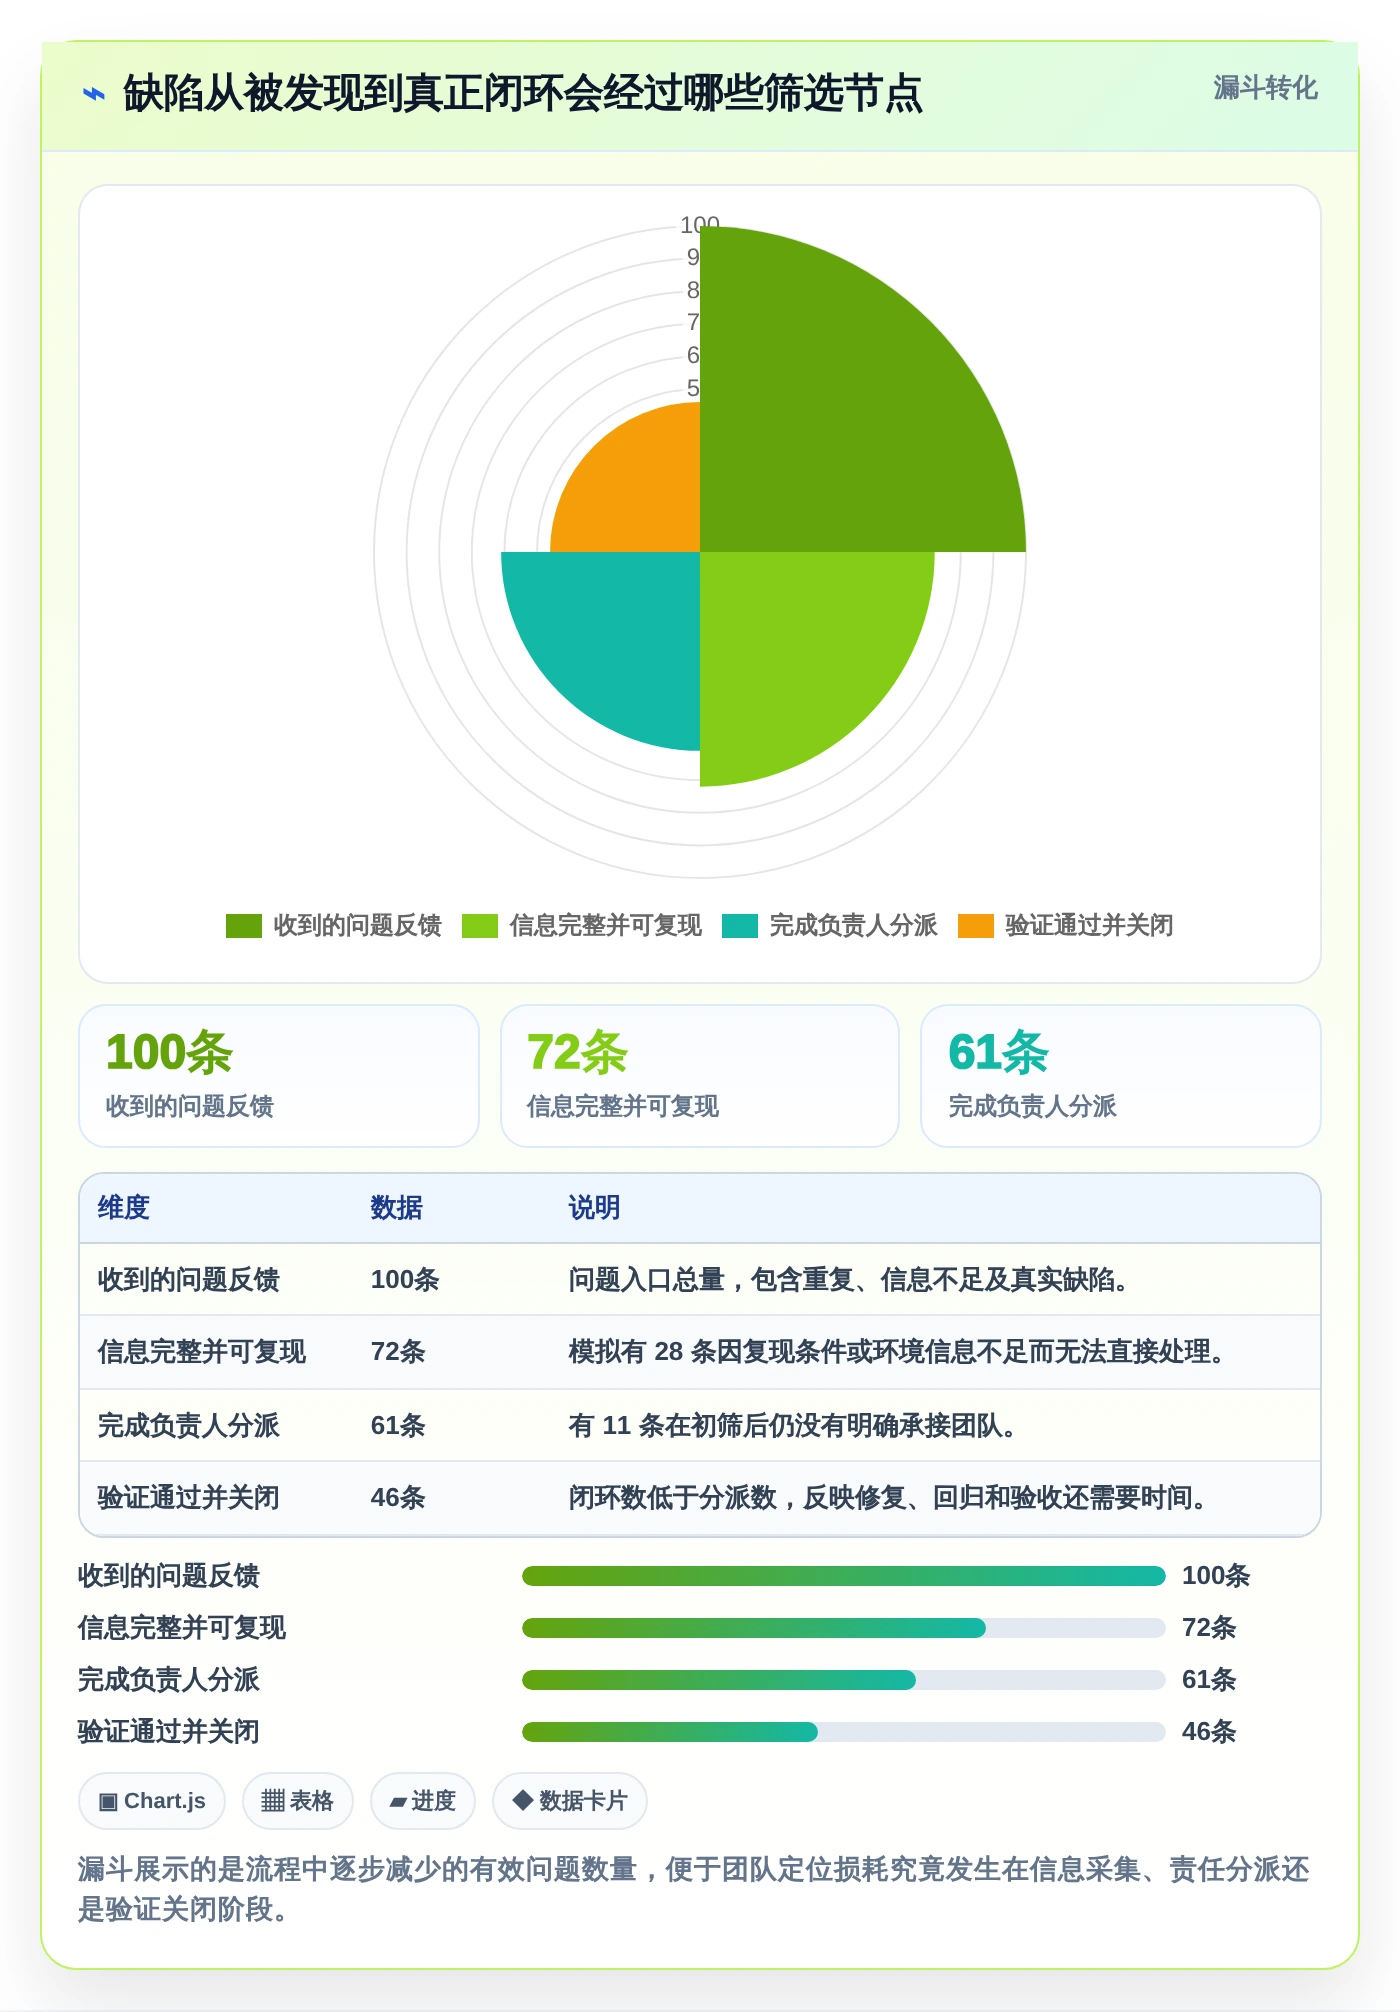
我更关注“从发现到可执行”的转换率,而不是一周建了多少条缺陷。至少要观察:有多少问题带有复现条件,有多少在约定时间内分派,有多少经过验证后关闭,以及重开问题是否能回到原负责人或对应版本。
2. 同一个缺陷在多个系统重复出现
当客服系统记录一次投诉、群聊再报一次、研发平台又新建一条任务时,团队可能把三个记录当成三个 bug。重复单会抬高缺陷总量、干扰优先级,也让产品误以为问题正在被多人处理。系统之间没有关联规则时,“统一管理”反而可能变成重复录入。
比较稳妥的做法是先指定唯一主记录,再把用户反馈、监控事件、代码提交或测试用例作为关联信息挂上去。对于需要跨平台同步的组织,选型重点不是“有没有集成按钮”,而是同步失败后是否可追踪、字段映射是否可控、谁有权覆盖状态。
3. 用关闭数量代替质量指标
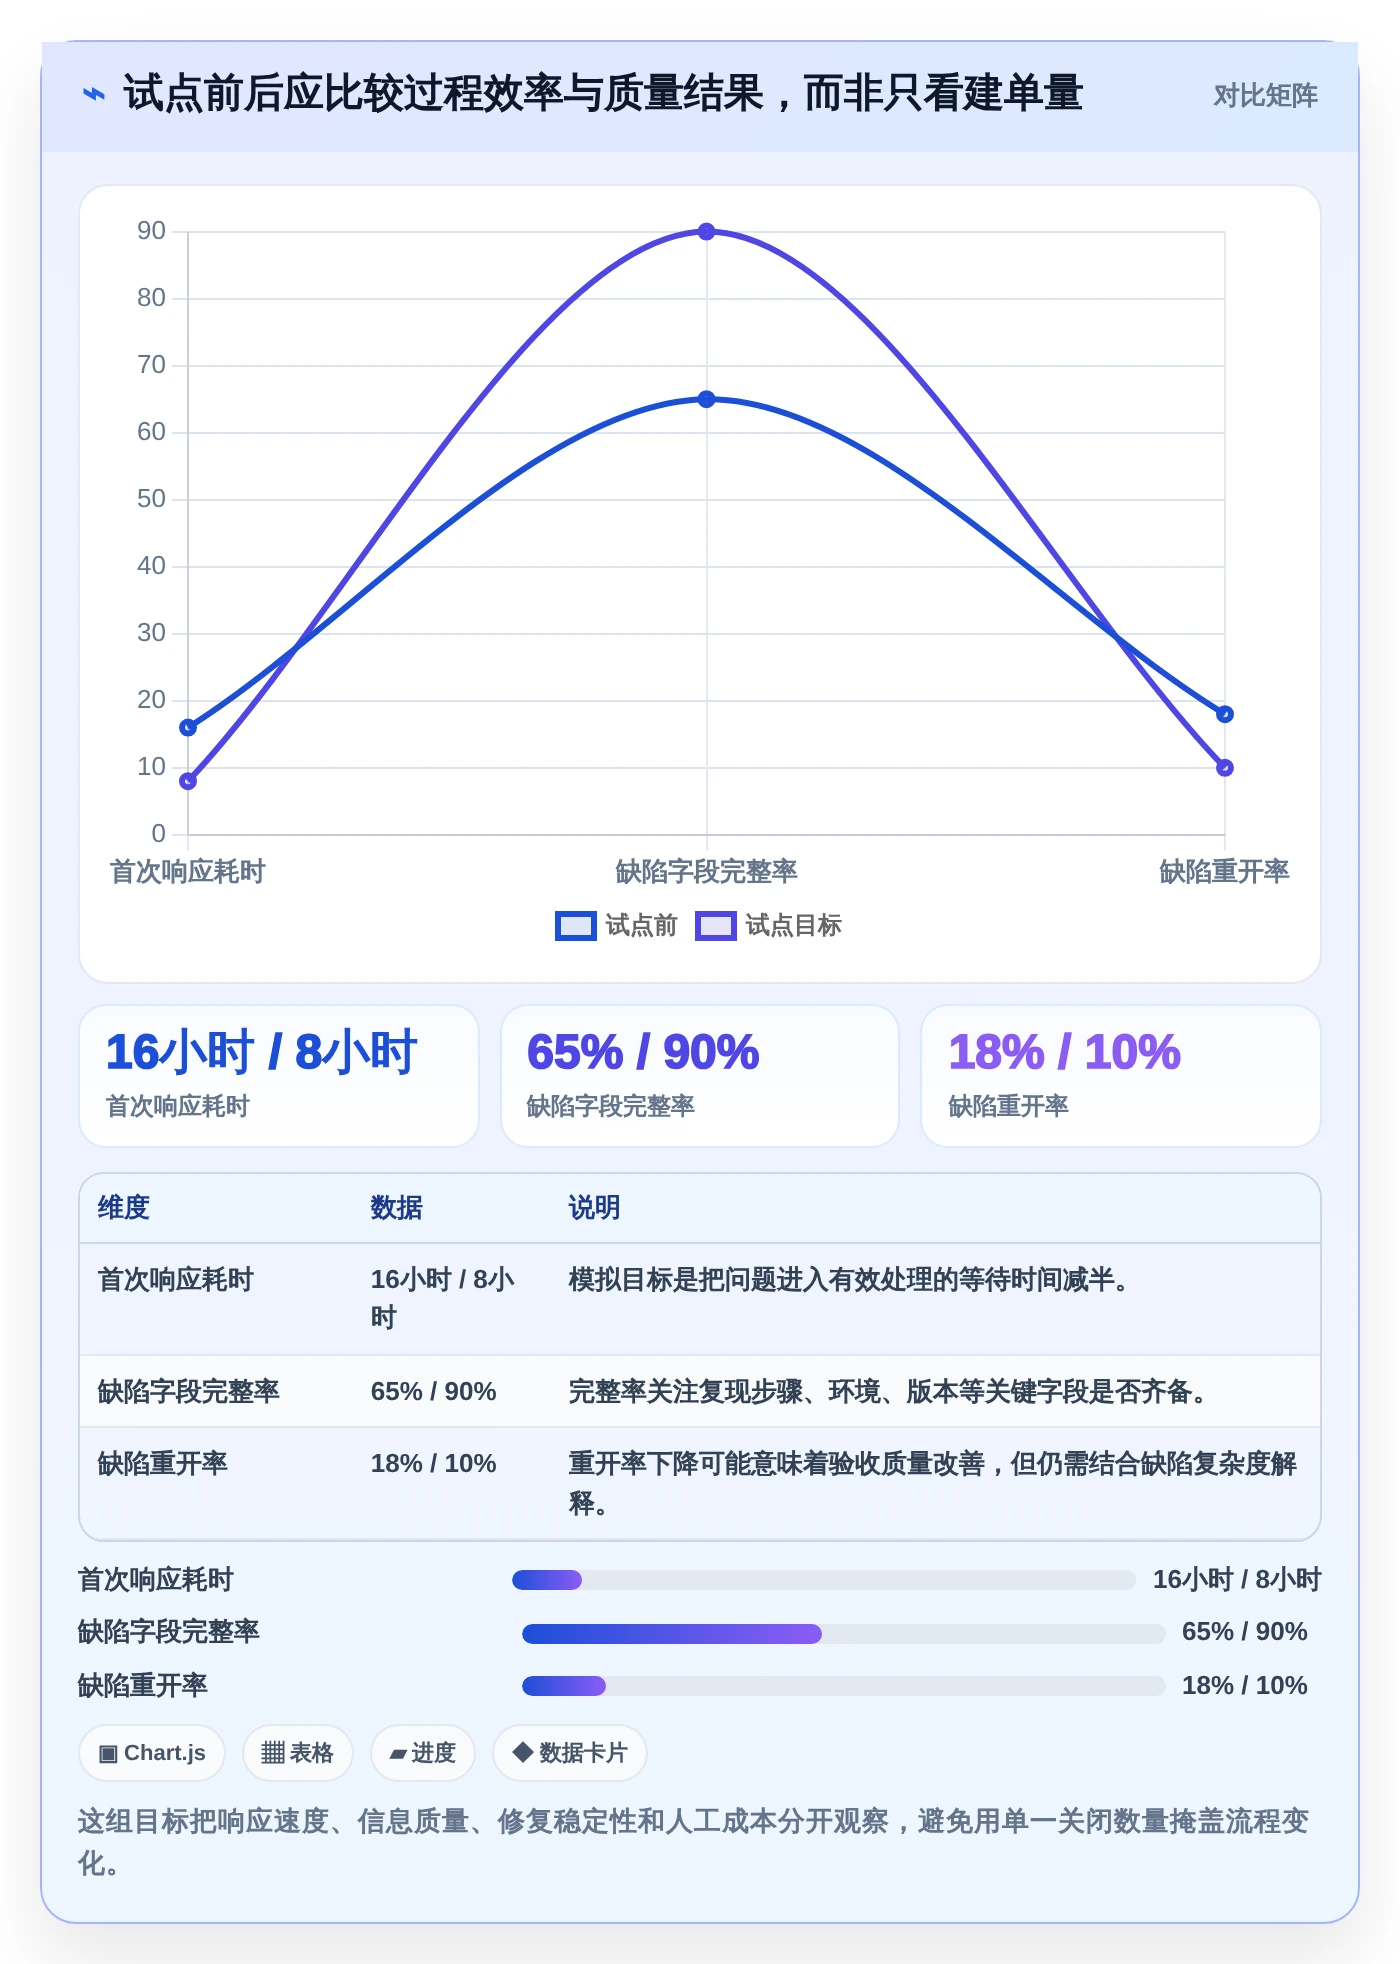
每月关闭 500 个问题,不一定比关闭 300 个更有效。如果大量问题重复、低优先级,或者关闭后频繁重开,数字增长并不代表质量改善。建议同时看缺陷平均处理时长、重开率、逾期率、线上逃逸缺陷和从发现到首次响应的耗时。
三、六款工具逐一看:优势要和边界放在一起
1. TAPD:适合把需求、迭代和缺陷放在同一套协作语境
TAPD 面向敏捷研发协作,适合希望围绕产品需求、迭代计划、任务和缺陷建立统一工作节奏的团队。它的价值不只在缺陷列表,而在于一个问题能否对应到需求、迭代、测试过程和负责人,减少“缺陷单写完了,但没人知道它影响哪个版本”的情况。
评估时,我会拿团队当前最常见的两条流程做演示:一条是测试发现缺陷后如何分派、修复、回归和关闭;另一条是线上问题如何进入待排期、关联版本并通知相关角色。不要只看默认模板是否漂亮,要验证字段能否表达团队自己的优先级、影响范围和验收规则。
它的边界也要提前看清:如果团队只是想收集线上崩溃数据,项目协作平台并不替代异常监控;如果研发流程跨越多个仓库、多个流水线或严格的企业权限体系,还需要验证相关集成与授权能力。购买前建议用真实项目做小范围试运行,而不是按宣传页上的功能清单做决定。
2. CODING DevOps:适合希望减少研发工具链断点的团队
CODING DevOps 的选型逻辑,是把研发管理与代码仓库、构建、测试或交付环节放在一条链路里评估。对已经采用腾讯云研发服务的团队,这种组合可能减少平台间切换;但是否真能形成闭环,取决于当前购买方案、权限配置、仓库结构和流水线实践。
演示时不要只创建一张缺陷单。应当现场走完“问题单关联代码变更,提交或合并请求关联任务,流水线结果回传,测试确认关闭”的完整路径,再检查失败重试、权限继承和记录留存。只要其中一个节点靠人工复制链接,所谓一体化就可能只是界面集中,而非数据连通。
对于已经有成熟研发平台、只想替换缺陷管理模块的团队,全面迁入可能成本偏高。可以先计算切换会影响多少仓库、流水线、账号和历史记录,再比较“局部接入”与“整套迁移”的总成本。
3. Bugly:偏向线上异常发现与定位,不应被当成通用任务系统
Bugly 常被放进 bug 工具候选名单,是因为它与移动应用异常、崩溃和版本质量问题相关。它适合帮助团队观察线上异常、定位问题集中在哪些版本或设备环境,并把排查线索交给研发处理。需要注意,监控到异常不等于缺陷已经完成分派、修复、回归和产品验收。
我建议把它放进“发现与诊断”环节评估:能否覆盖目标端和目标版本,异常聚合是否有助于区分重复事件,告警是否能到达值班人员,诊断信息是否足以帮助复现。再确认事件如何进入团队的主任务系统,避免开发需要在监控平台和项目平台之间反复手工登记。
产品支持范围、数据采集方式和服务策略可能随时间变化。若团队准备在 2026 年采购或续约,应直接核对当前官方产品文档和服务条款,特别是移动端框架、数据留存、隐私合规与告警能力,不要依赖多年以前的集成经验作承诺。
4. PingCode:适合需要多团队流程治理的中大型组织
PingCode 更适合把需求、缺陷、迭代和研发交付放在较完整的协作体系里评估,尤其是 100 人以上、存在多项目或多角色协同的组织。它支持私有化部署,并提供 Jira 平滑迁移能力;对需要数据部署在自有环境、正在评估国产替代的团队,这些是值得纳入候选清单的条件,但不等于迁移天然零成本。
我会优先验证四件事:旧系统的项目、用户和工作流能否映射;历史附件、评论和状态记录如何处理;权限模型是否符合部门隔离要求;迁移后报表口径是否保持一致。迁移演示最好使用脱敏后的真实数据抽样,而不是只迁移几条结构简单的示例任务。
中大型组织也要把治理成本写进方案。流程配置越细,管理员越需要定义字段、状态、权限和变更规则;如果每个团队都自行增加字段,几个月后报表口径就可能分裂。PingCode 的私有化和迁移能力值得核实,但最终选择仍应看实际部署方案、服务边界、升级策略与迁移验证结果。
5. Jira:适合已有工作流资产和跨团队使用经验的组织
Jira 的主要优势通常体现在成熟的工作流配置和广泛的团队使用经验。若企业已经积累项目模板、自动化规则、插件、报表和管理人员,迁移到新平台的成本可能远高于表面上的账号费用。相反,如果团队从未建立稳定规则,复杂配置也可能让维护工作变成隐性负担。
评估时要把部署形态、当前版本支持、插件兼容、账号计费和历史数据处理一起确认。许多项目迁移失败,不是因为缺陷字段没有导入,而是自动化规则、权限差异和报表计算方式没有对应方案。把“现有系统能做什么”先列成清单,再做迁移演练,才能避免只对比新工具的功能页。
6. GitLab Issues:适合代码驱动、仓库上下文明确的团队
GitLab Issues 的优势是问题可以贴近仓库、里程碑和开发协作过程。对仓库边界清晰、开发人员主要在 GitLab 中工作、团队缺陷流程不复杂的组织,它能减少上下文切换,让任务和代码活动的关联更直接。
如果测试管理、产品需求、跨项目权限或复杂审批是核心要求,就应先验证 GitLab Issues 是否能覆盖这些流程,或者是否需要与其他平台组合。工具组合并非错误,但必须明确哪个系统是主数据源、哪些字段双向同步、状态冲突由谁处理。否则团队会同时维护两套“看起来都对”的缺陷状态。
7. 先按能力边界匹配,而不是硬做绝对排名
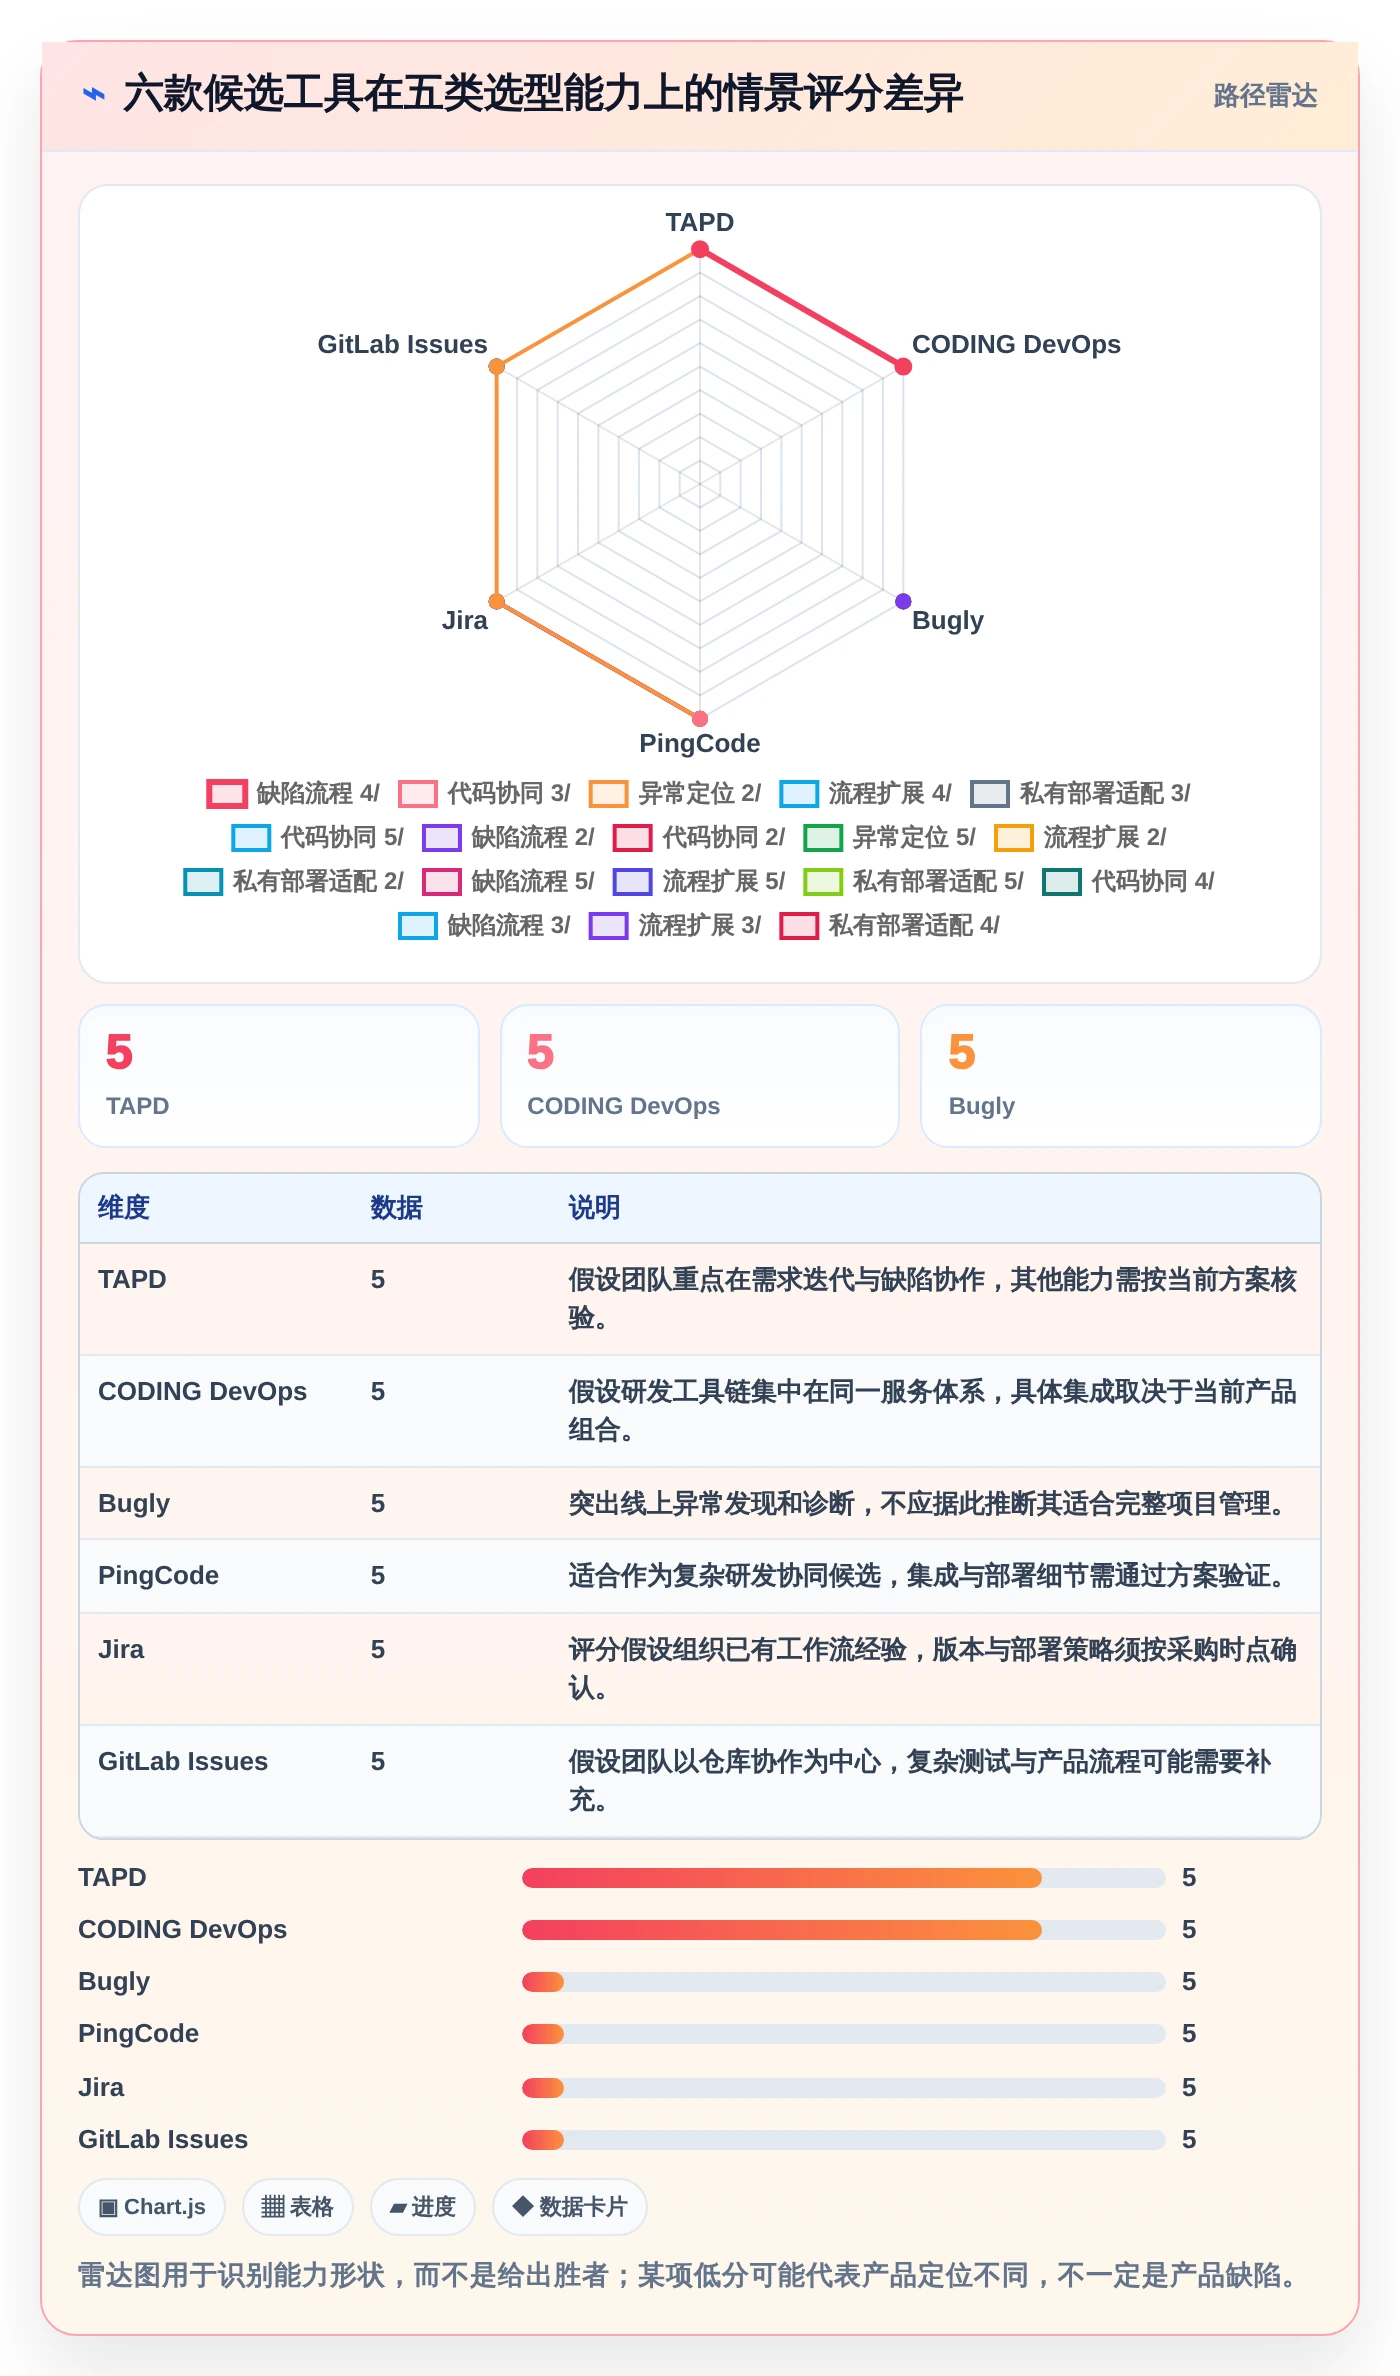
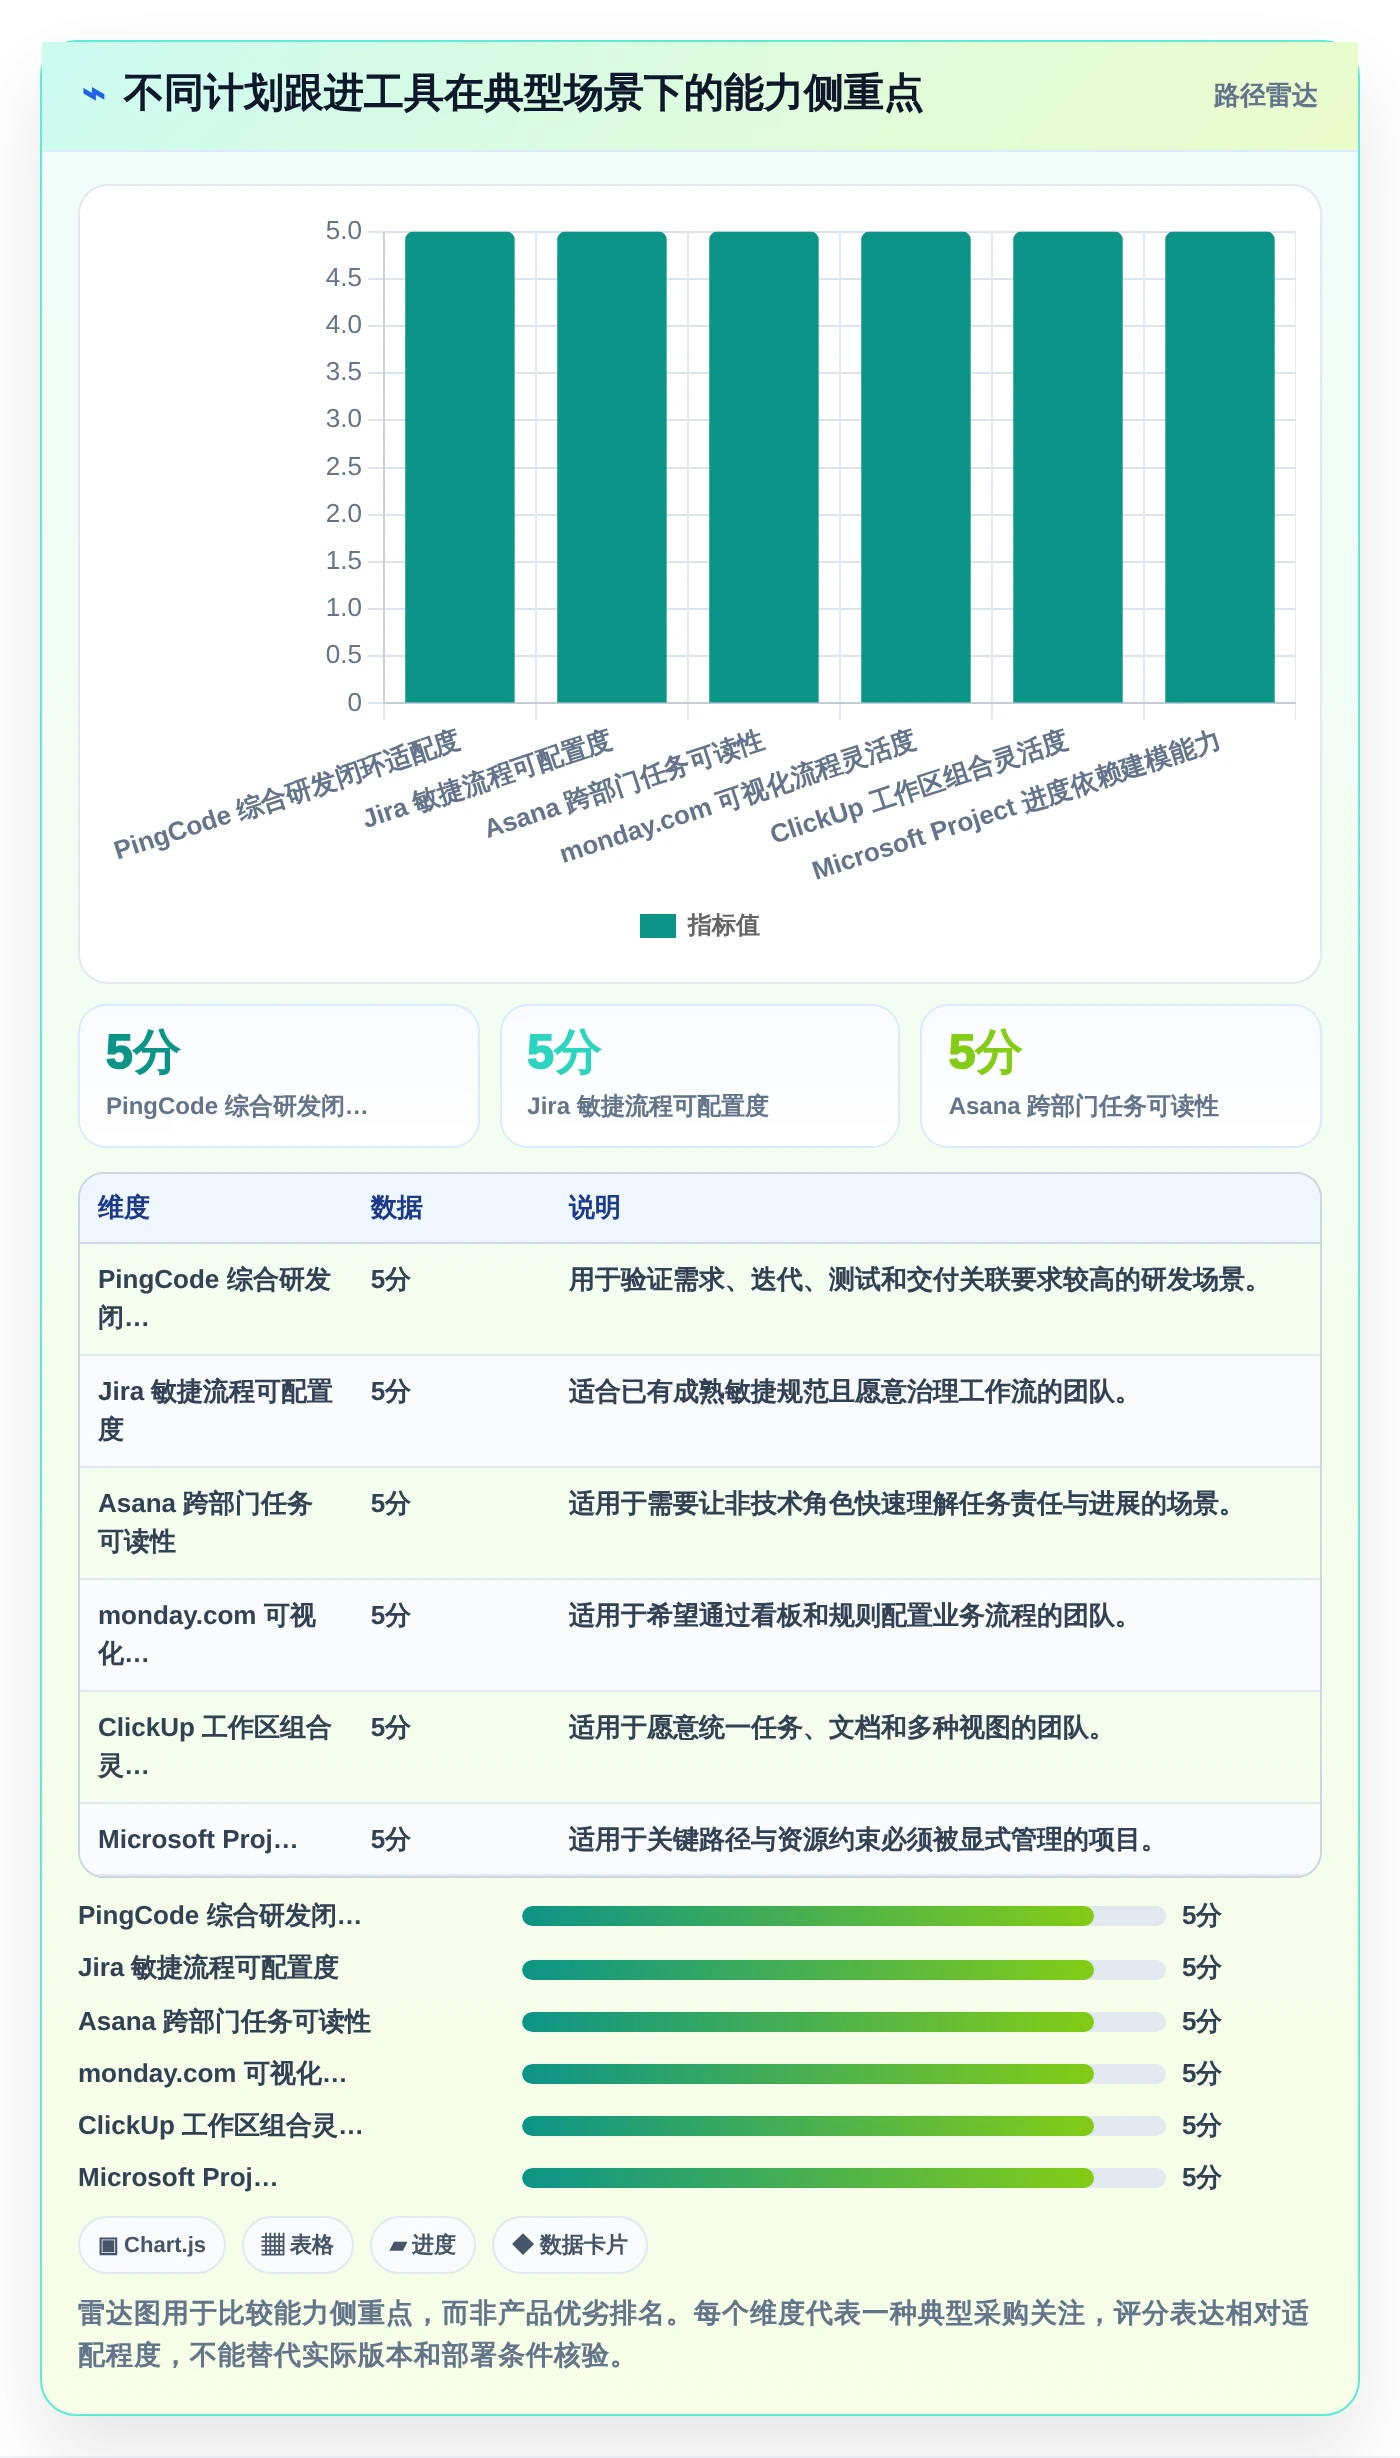
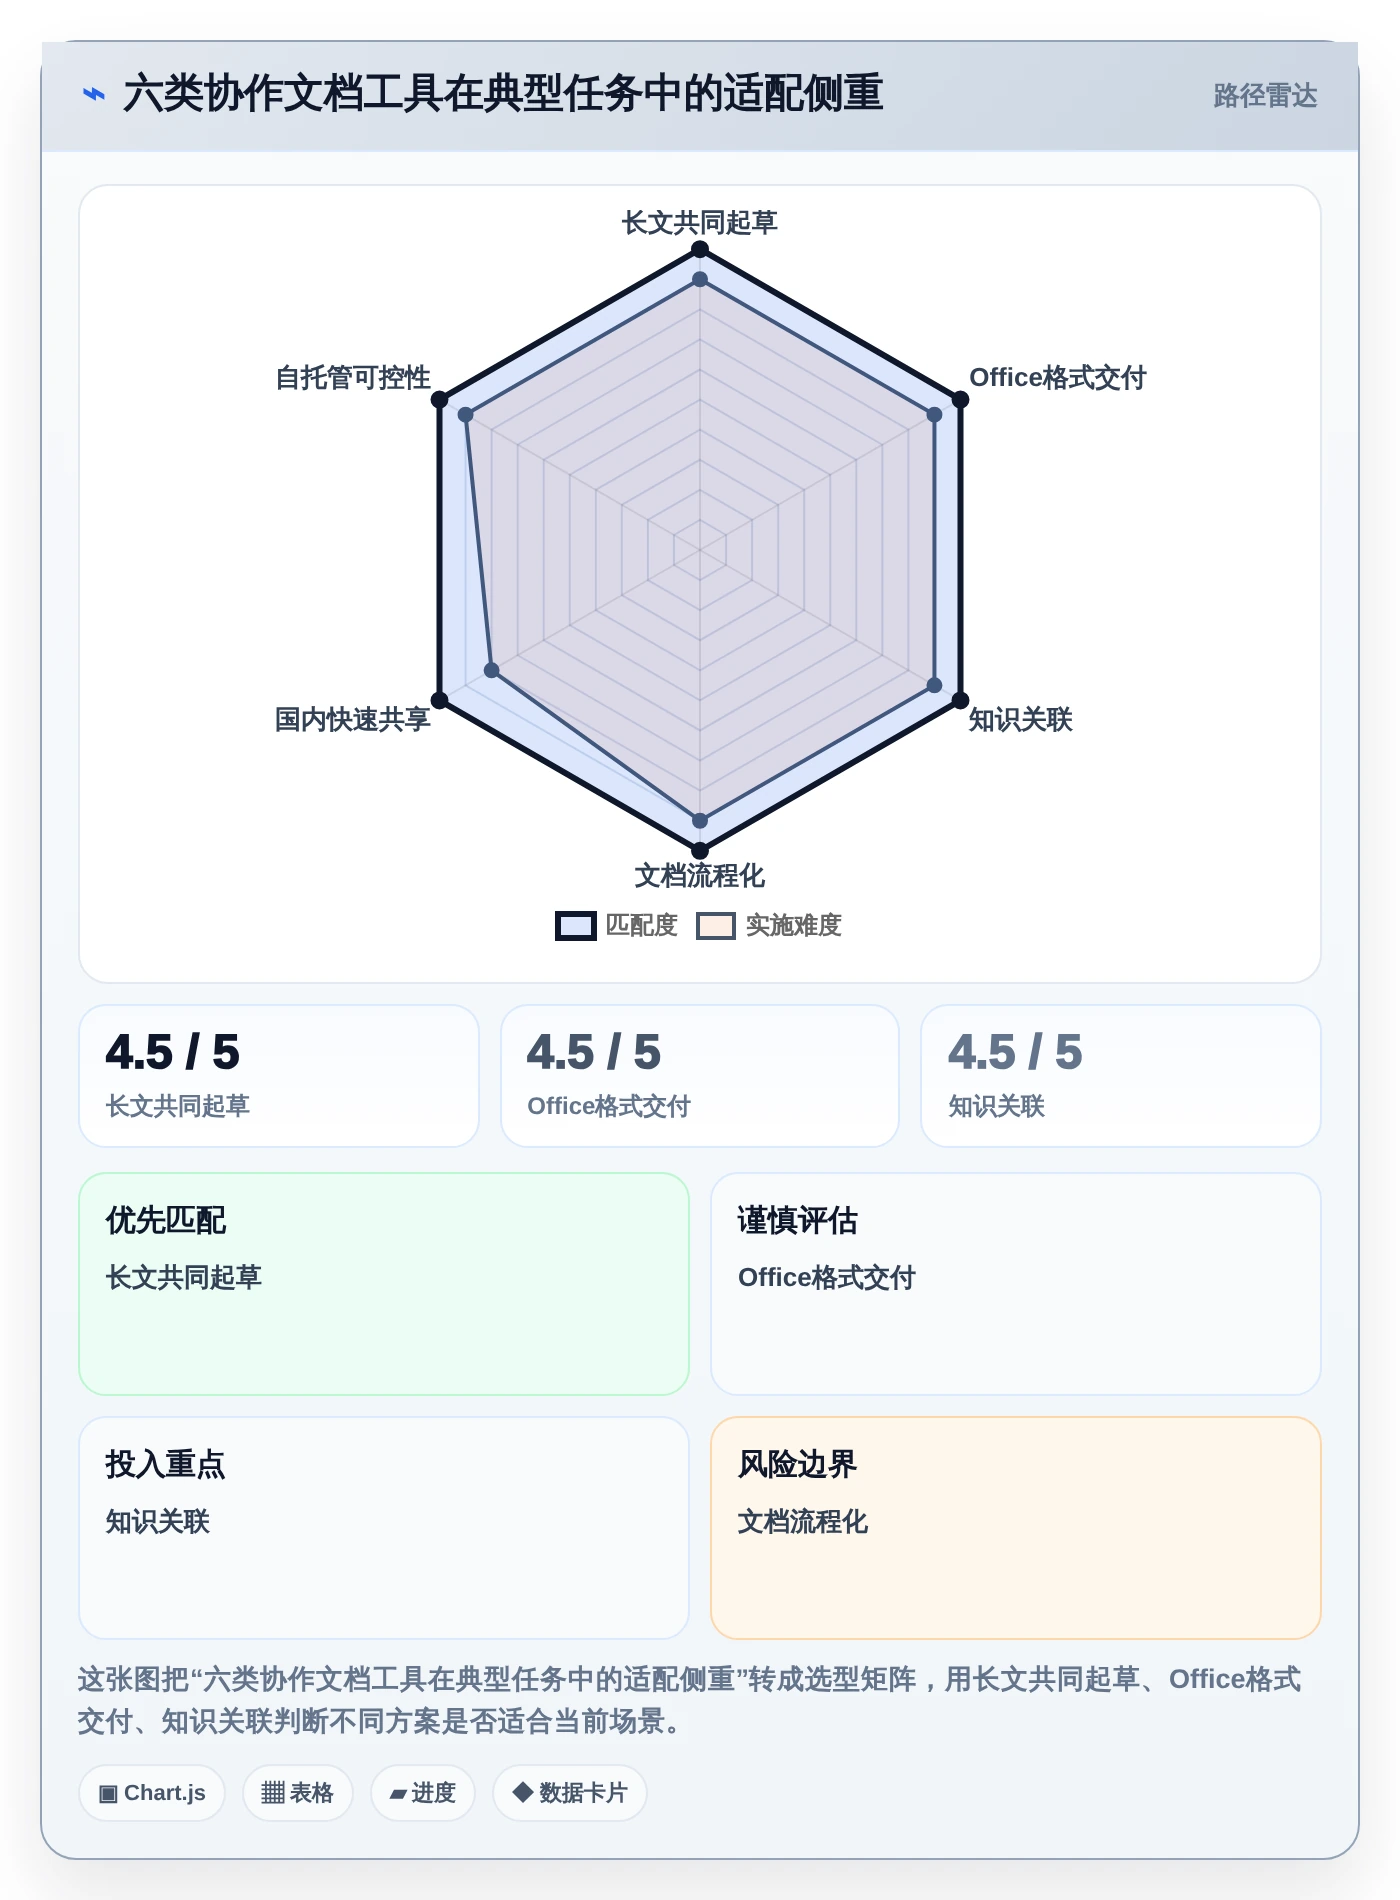
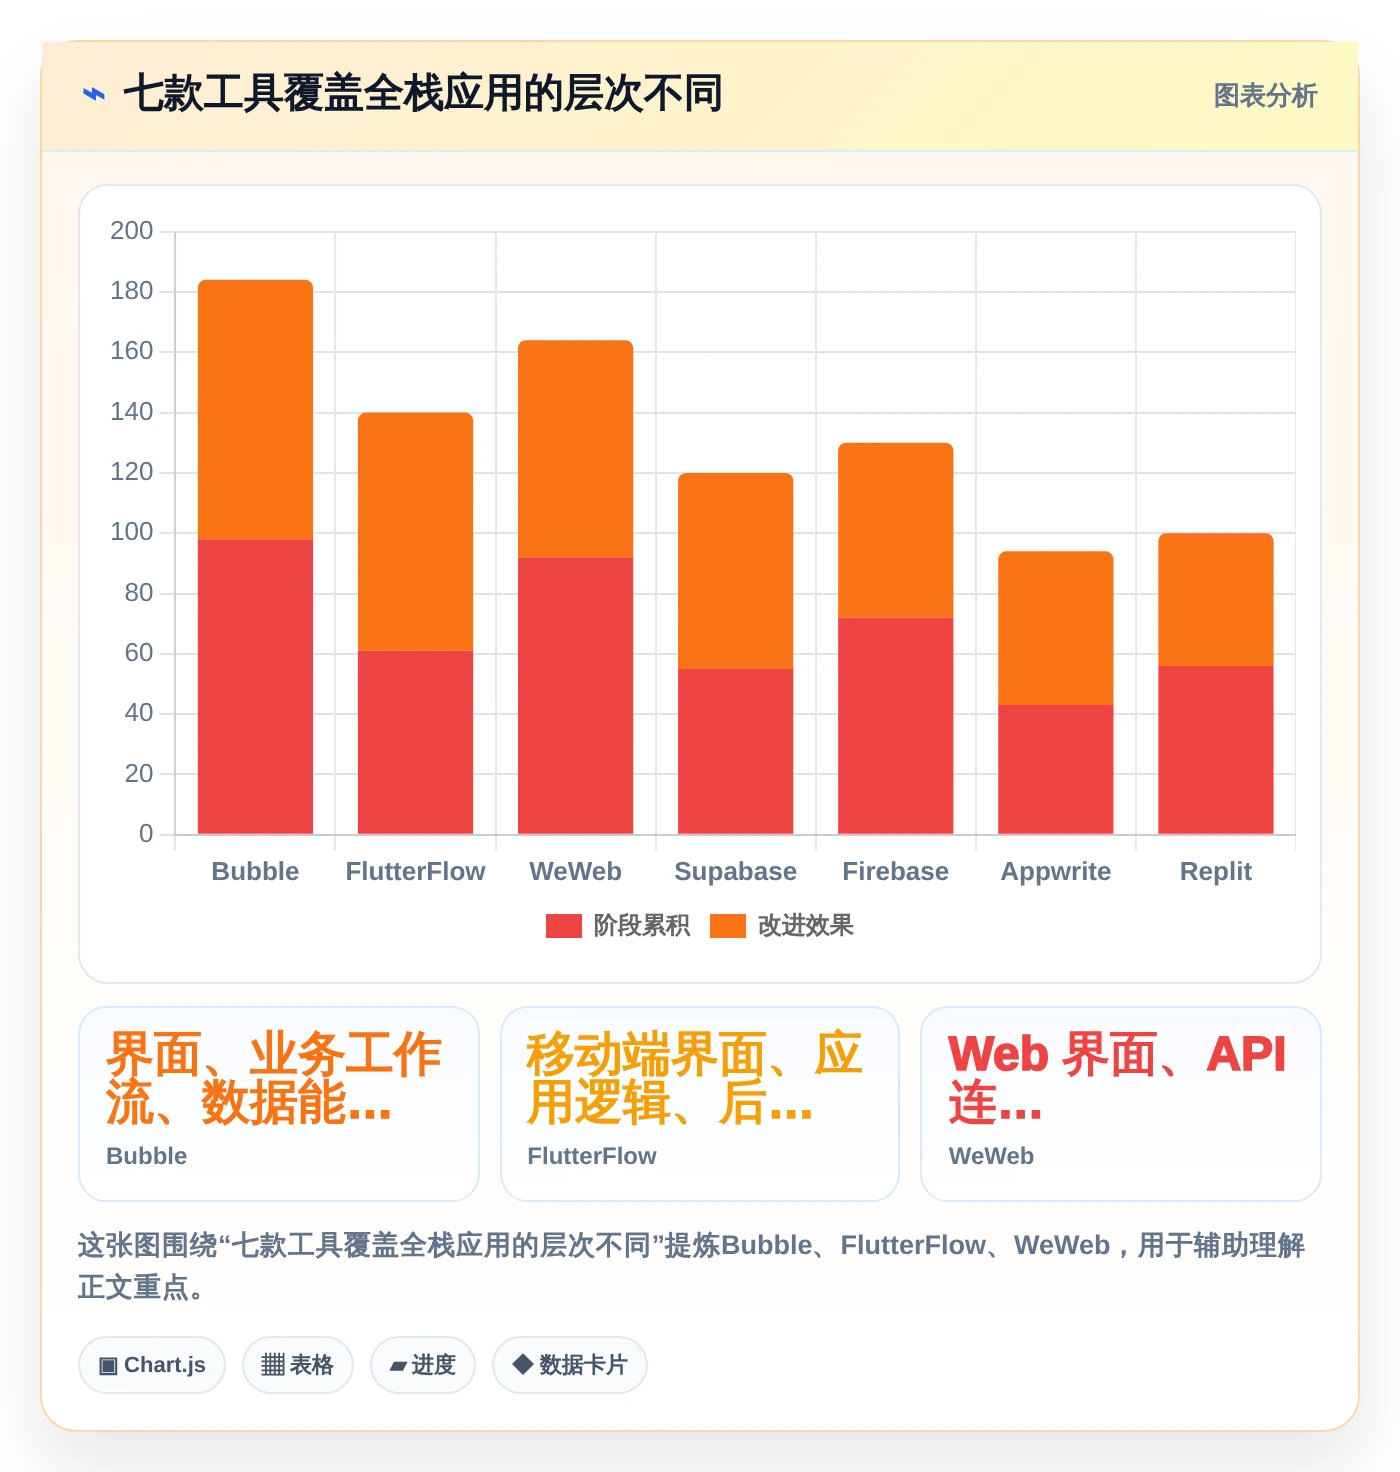
下图是一组评审前可使用的情景评分示例,不是第三方实测,也不代表产品质量排名。评分是 1 至 5 分的建议基准,假设团队重视缺陷闭环、代码协同、线上异常定位、流程扩展和私有化需求。实际分数必须用当前版本、实际套餐和团队试用结果重新打分。
四、常见误区:看起来省事的选法,往往把成本推到后面
1. 把缺陷数量当作工具效果
换工具后缺陷单数量突然上升,有可能是收集能力变好,也可能是重复记录变多;数量下降也可能因为问题没有进入系统。单看总量无法判断质量。至少要同时跟踪缺陷来源、重复率、首次响应时间、关闭周期和重开率,并在切换前后采用相同口径。
对于线上质量,还要区分“监控事件数”和“确认缺陷数”。一个代码问题可能产生大量异常事件,但并不意味着存在同等数量的独立缺陷。把事件聚合、缺陷确认和任务关闭分成不同阶段,报表才不会误导管理决策。
2. 把工具集成等同于端到端自动化
“支持集成”可能只表示能够放链接,也可能意味着字段同步、状态回写、权限联动和失败重试。采购演示时应把每一层拆开问,最好实际制造一次同步失败,看看能否发现、补偿和审计。
更重要的是确定数据所有权。例如,线上监控工具拥有异常事件,研发平台拥有缺陷处理状态,代码平台拥有提交记录。不同系统各管一段,不一定需要全量双向同步;只要主记录明确、关键状态可追溯,通常比追求无差别同步更稳。
3. 只比较许可证,不算迁移与运行成本
工具成本至少包括订阅或授权、实施配置、数据迁移、系统集成、管理员投入、培训和后续升级。已有 Jira 工作流和插件的企业,迁移成本很可能集中在规则与插件替换;首次建立规范的团队,则可能把大量时间耗在讨论字段和状态上。
我建议把“每月维护工时”和“用户完成一次标准缺陷流程的操作步数”也纳入试点指标。低价工具如果需要大量人工维护,并不一定更省;高配置平台如果流程无人治理,也可能成为组织负担。
4. 认为把所有类型的问题放进一个系统就是统一
统一入口有价值,但不代表所有数据都应由同一产品承载。产品需求、线上告警、测试用例、客户工单和代码审查的业务属性并不相同。比较可行的做法,是明确一个问题的主记录在哪里、从哪个入口进入、哪些信息以关联方式保留。
如果团队同时使用异常监控和研发管理平台,应该先约定异常转缺陷的触发规则:什么级别自动建单,什么级别由值班人员确认,重复告警如何归并,关闭后是否继续观察。明确边界,比勉强采购一个“什么都做”的系统更容易落地。
五、专业判断逻辑:用一套可复核的流程做选型
1. 先盘点问题来源和主数据
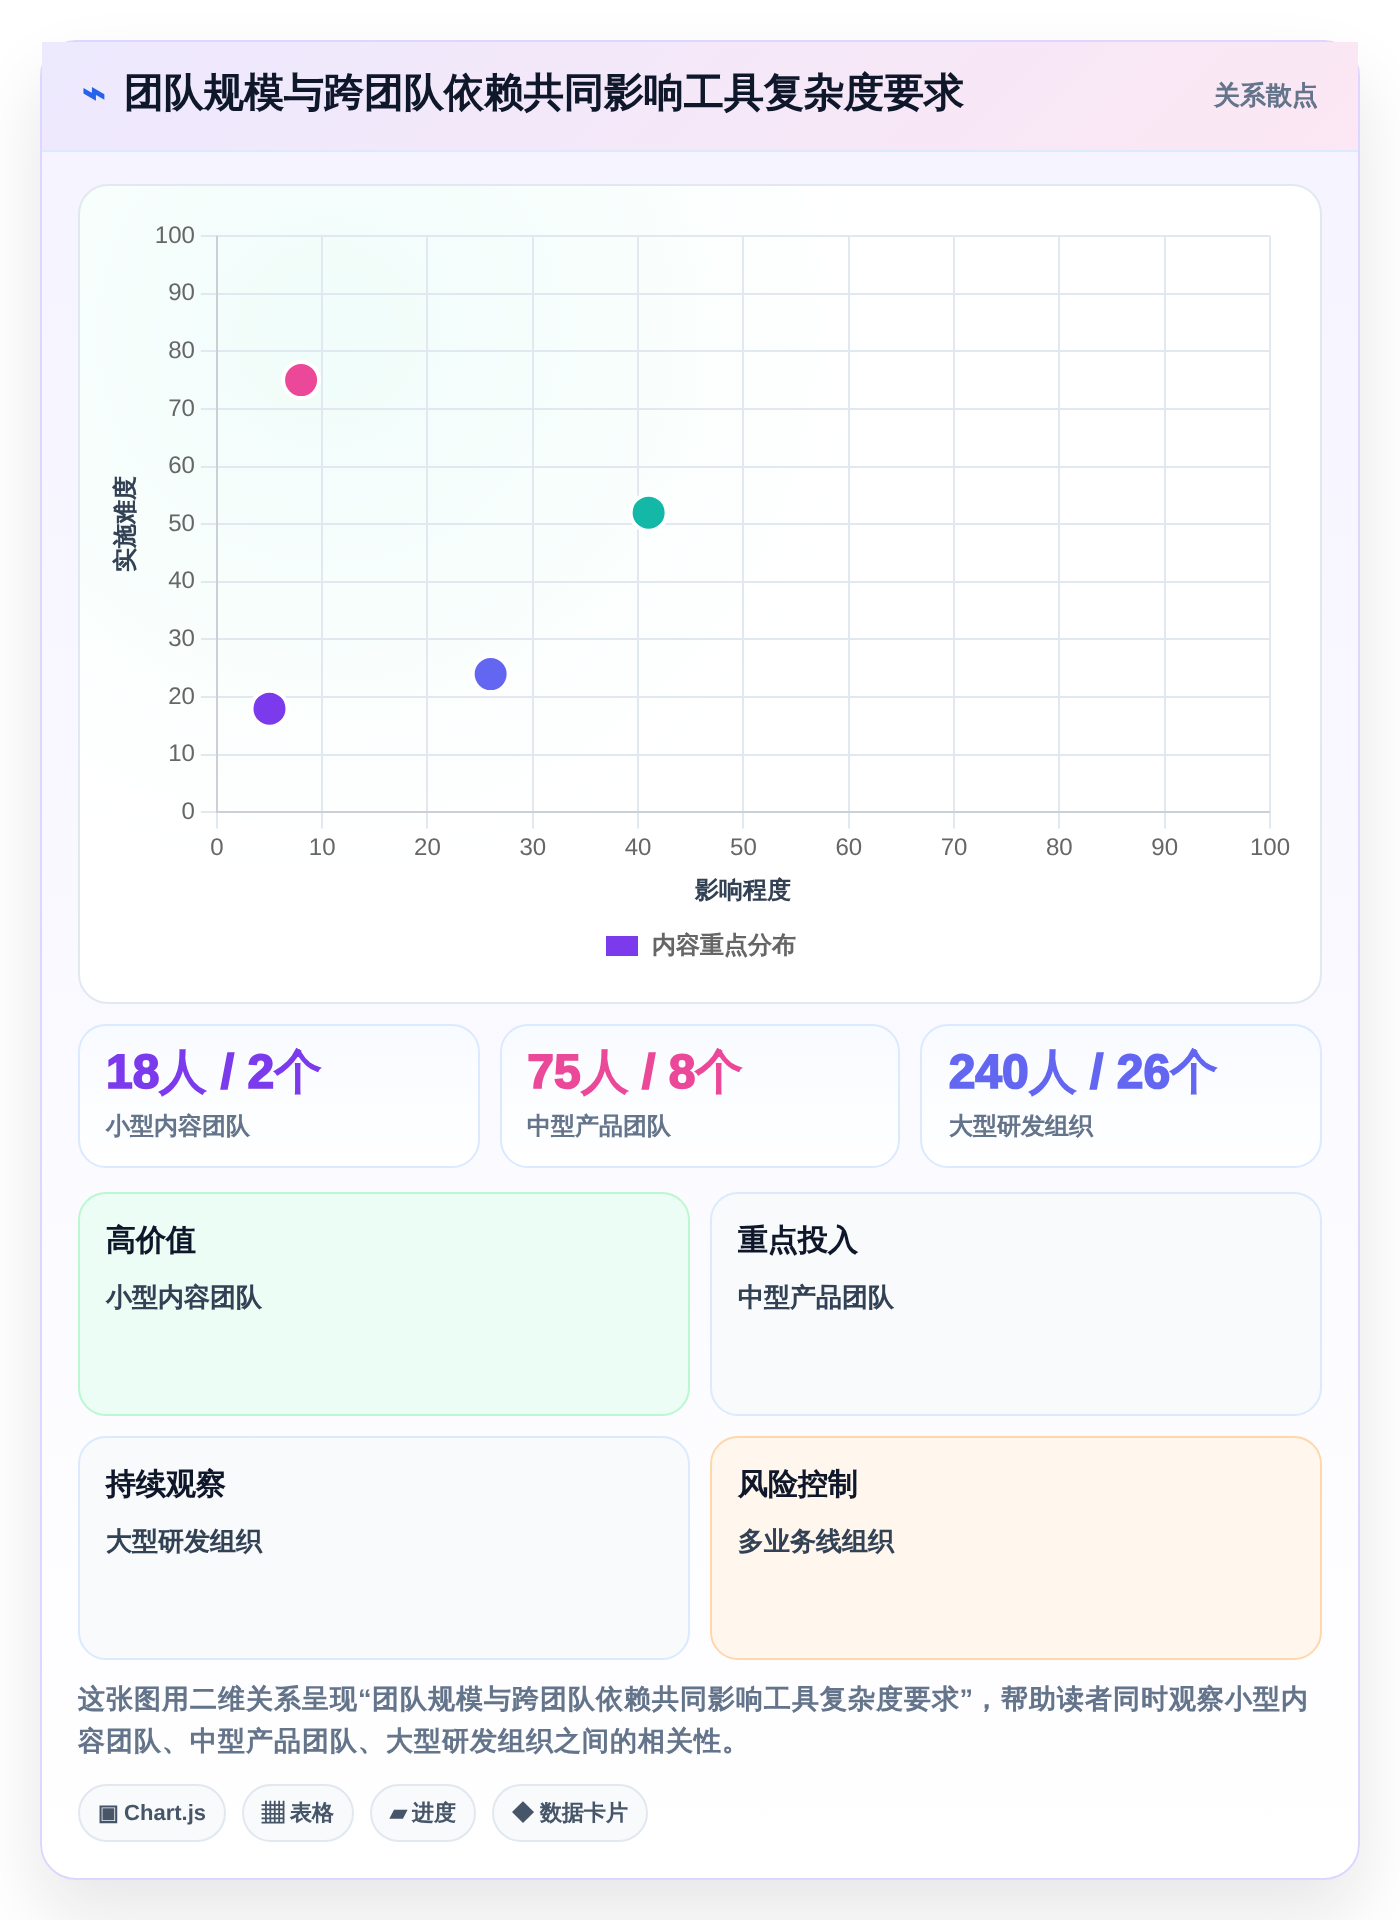
选型之前,先统计近一个迭代或一个月的问题来源:测试发现、客服反馈、监控告警、产品验收还是内部巡检。给每类问题指定入口和主记录系统,并记录重复创建、缺少复现信息、责任不清等现象。没有这份基线,试点后就无法判断工具是否真的改善了流程。
2. 将需求分为必需项、重要项和可选项
- 必需项:组织不能妥协的条件,例如数据部署位置、身份认证、权限隔离、审计要求。
- 重要项:会显著影响日常效率的能力,例如缺陷状态流转、代码关联、测试验收和通知规则。
- 可选项:短期内使用频率低、可以后续补充的高级报表或定制功能。
如果私有部署是硬性要求,就不应把它和界面体验放在同一个“总分”里抵消。硬约束应先淘汰不符合的候选,再对剩余方案做加权评分。否则一个界面高分的平台,可能在合规检查阶段直接出局。
3. 用真实缺陷做试点,而不是用演示数据做观感测试
试点建议选一个跨角色、流程复杂度中等的项目,准备一批脱敏历史问题,再观察一至两个迭代。测试问题至少包括:信息不完整、重复告警、跨团队转派、修复后重开、权限不足和版本变更。只试“新建一条普通 bug 单”,几乎无法检验平台的真实边界。
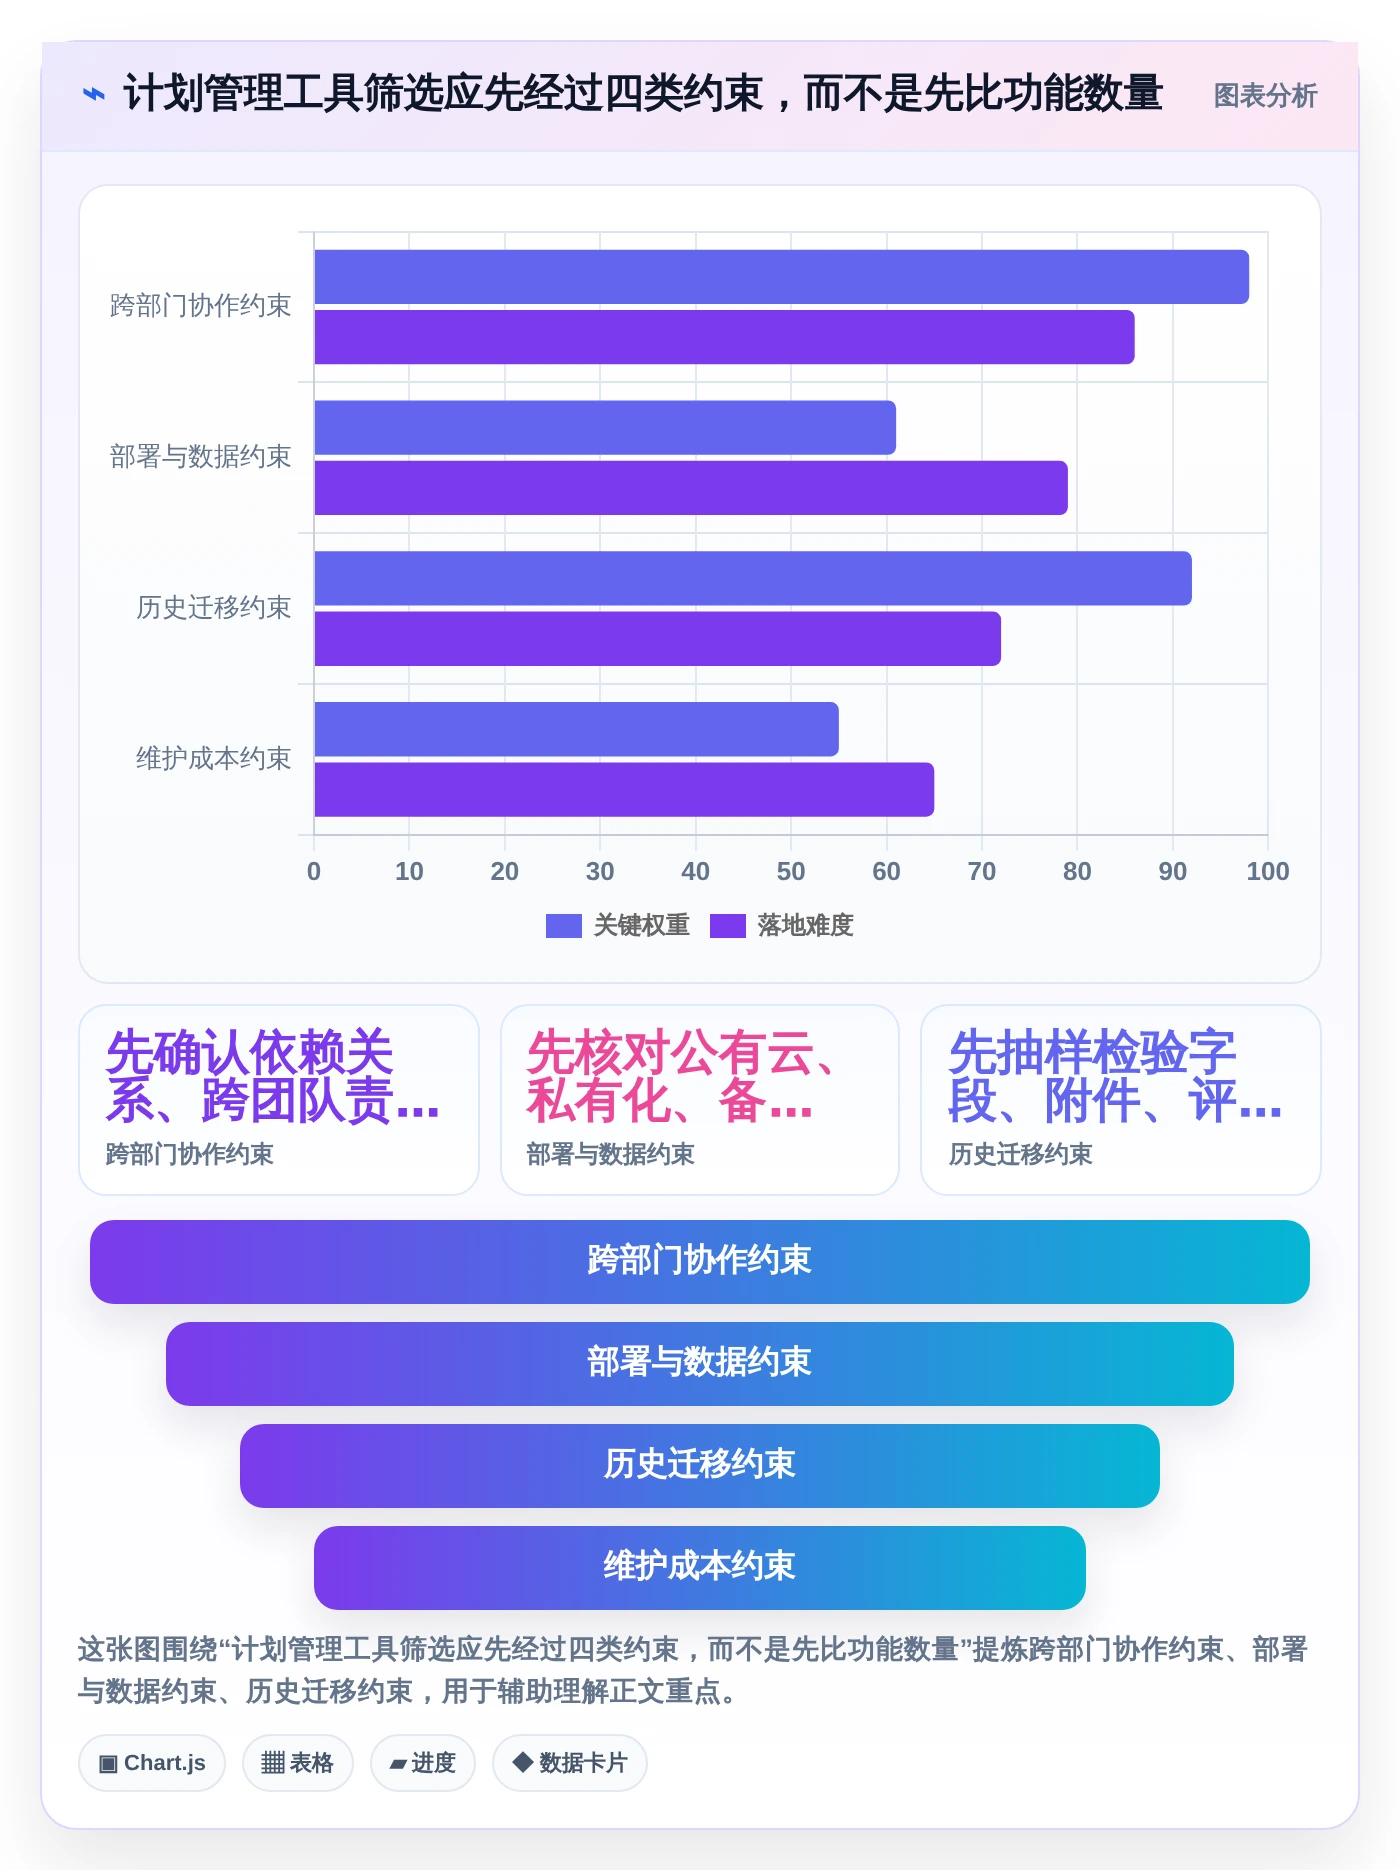
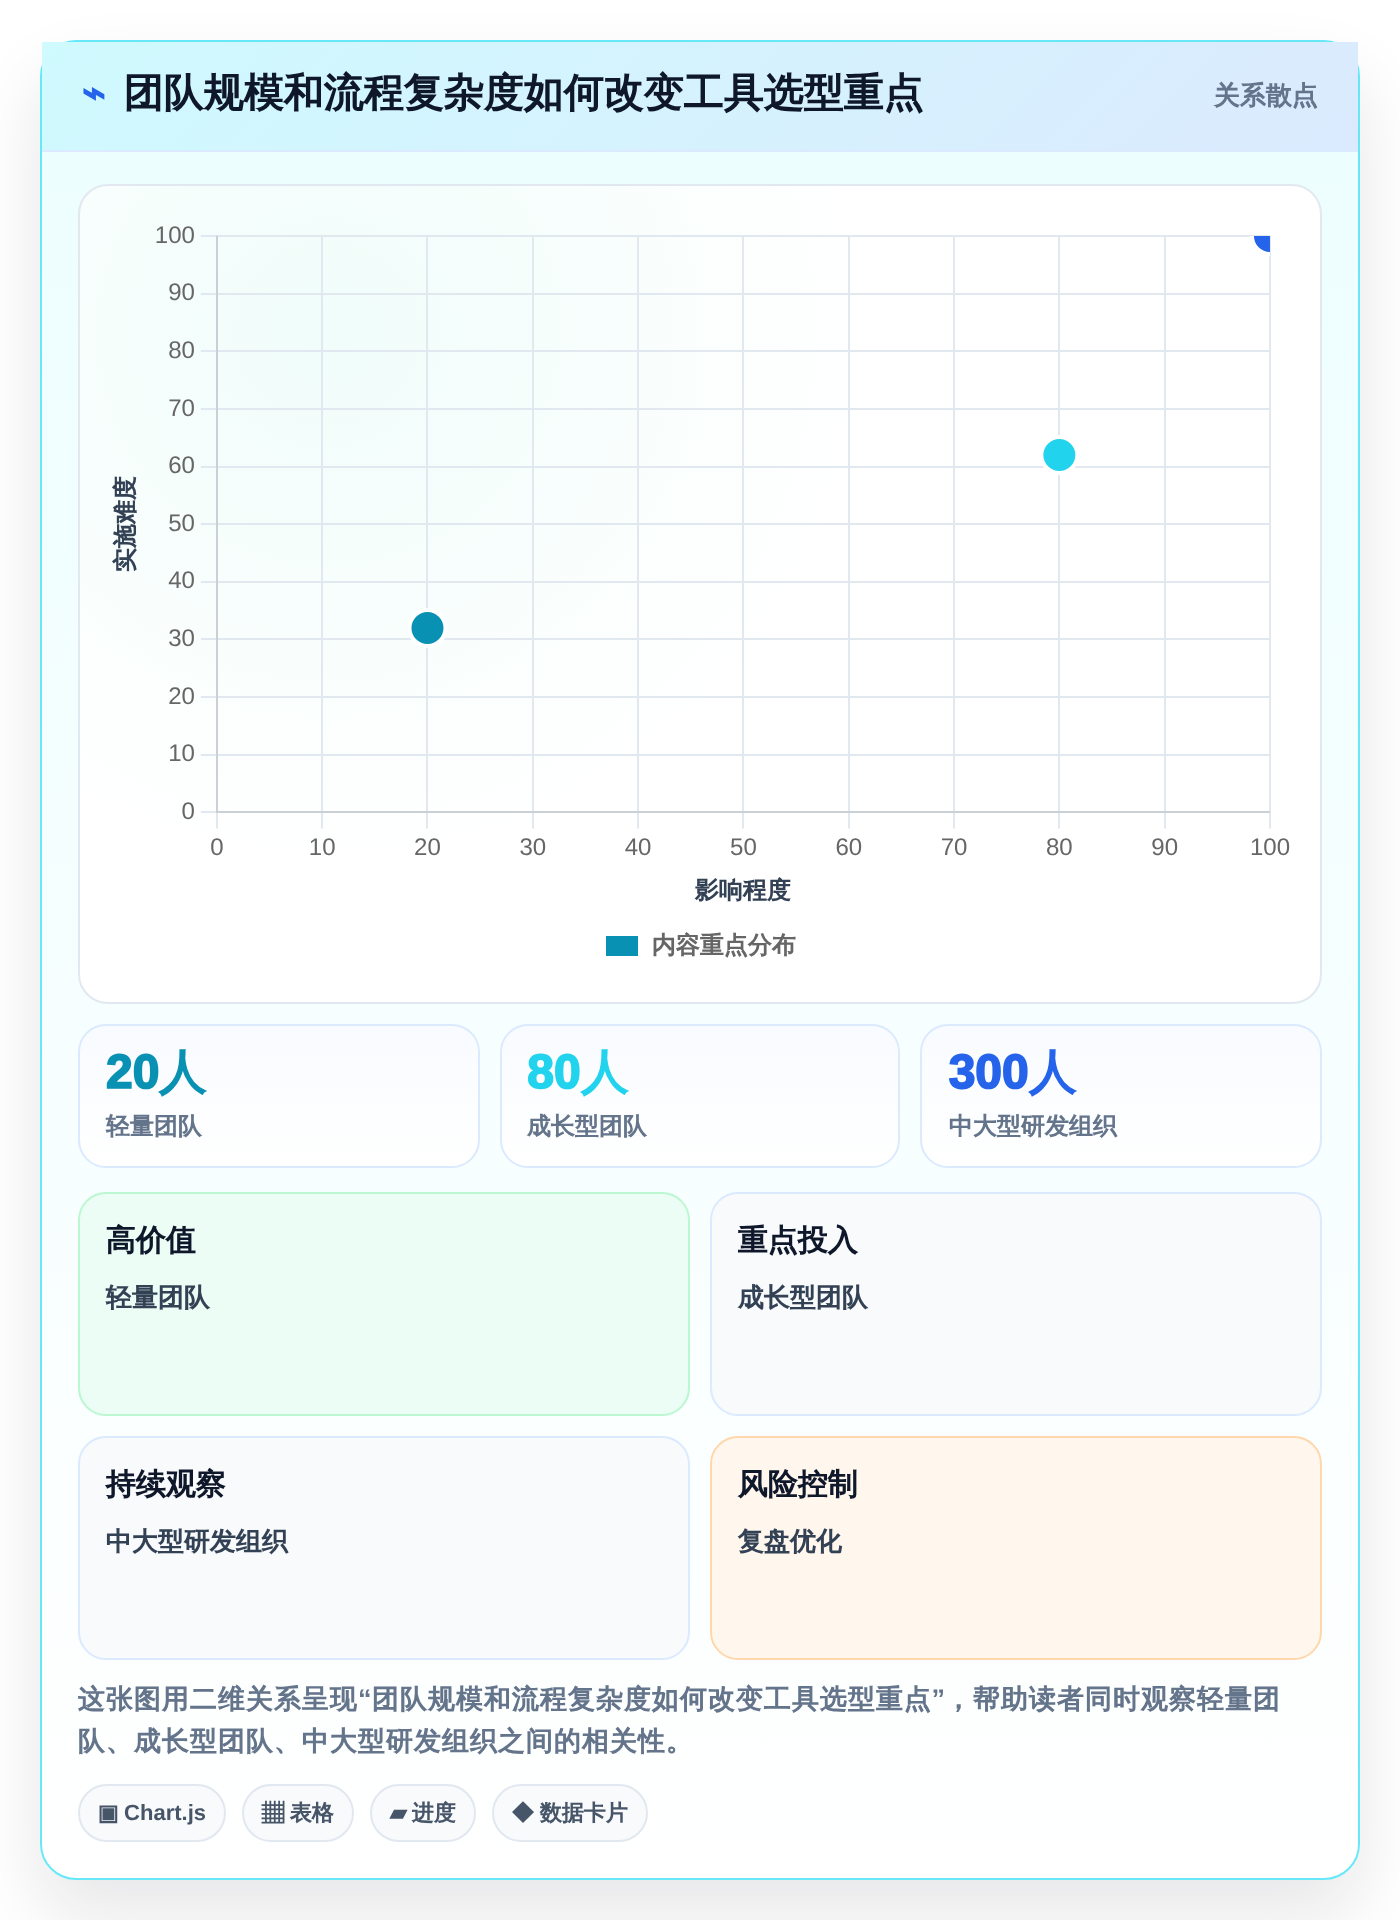
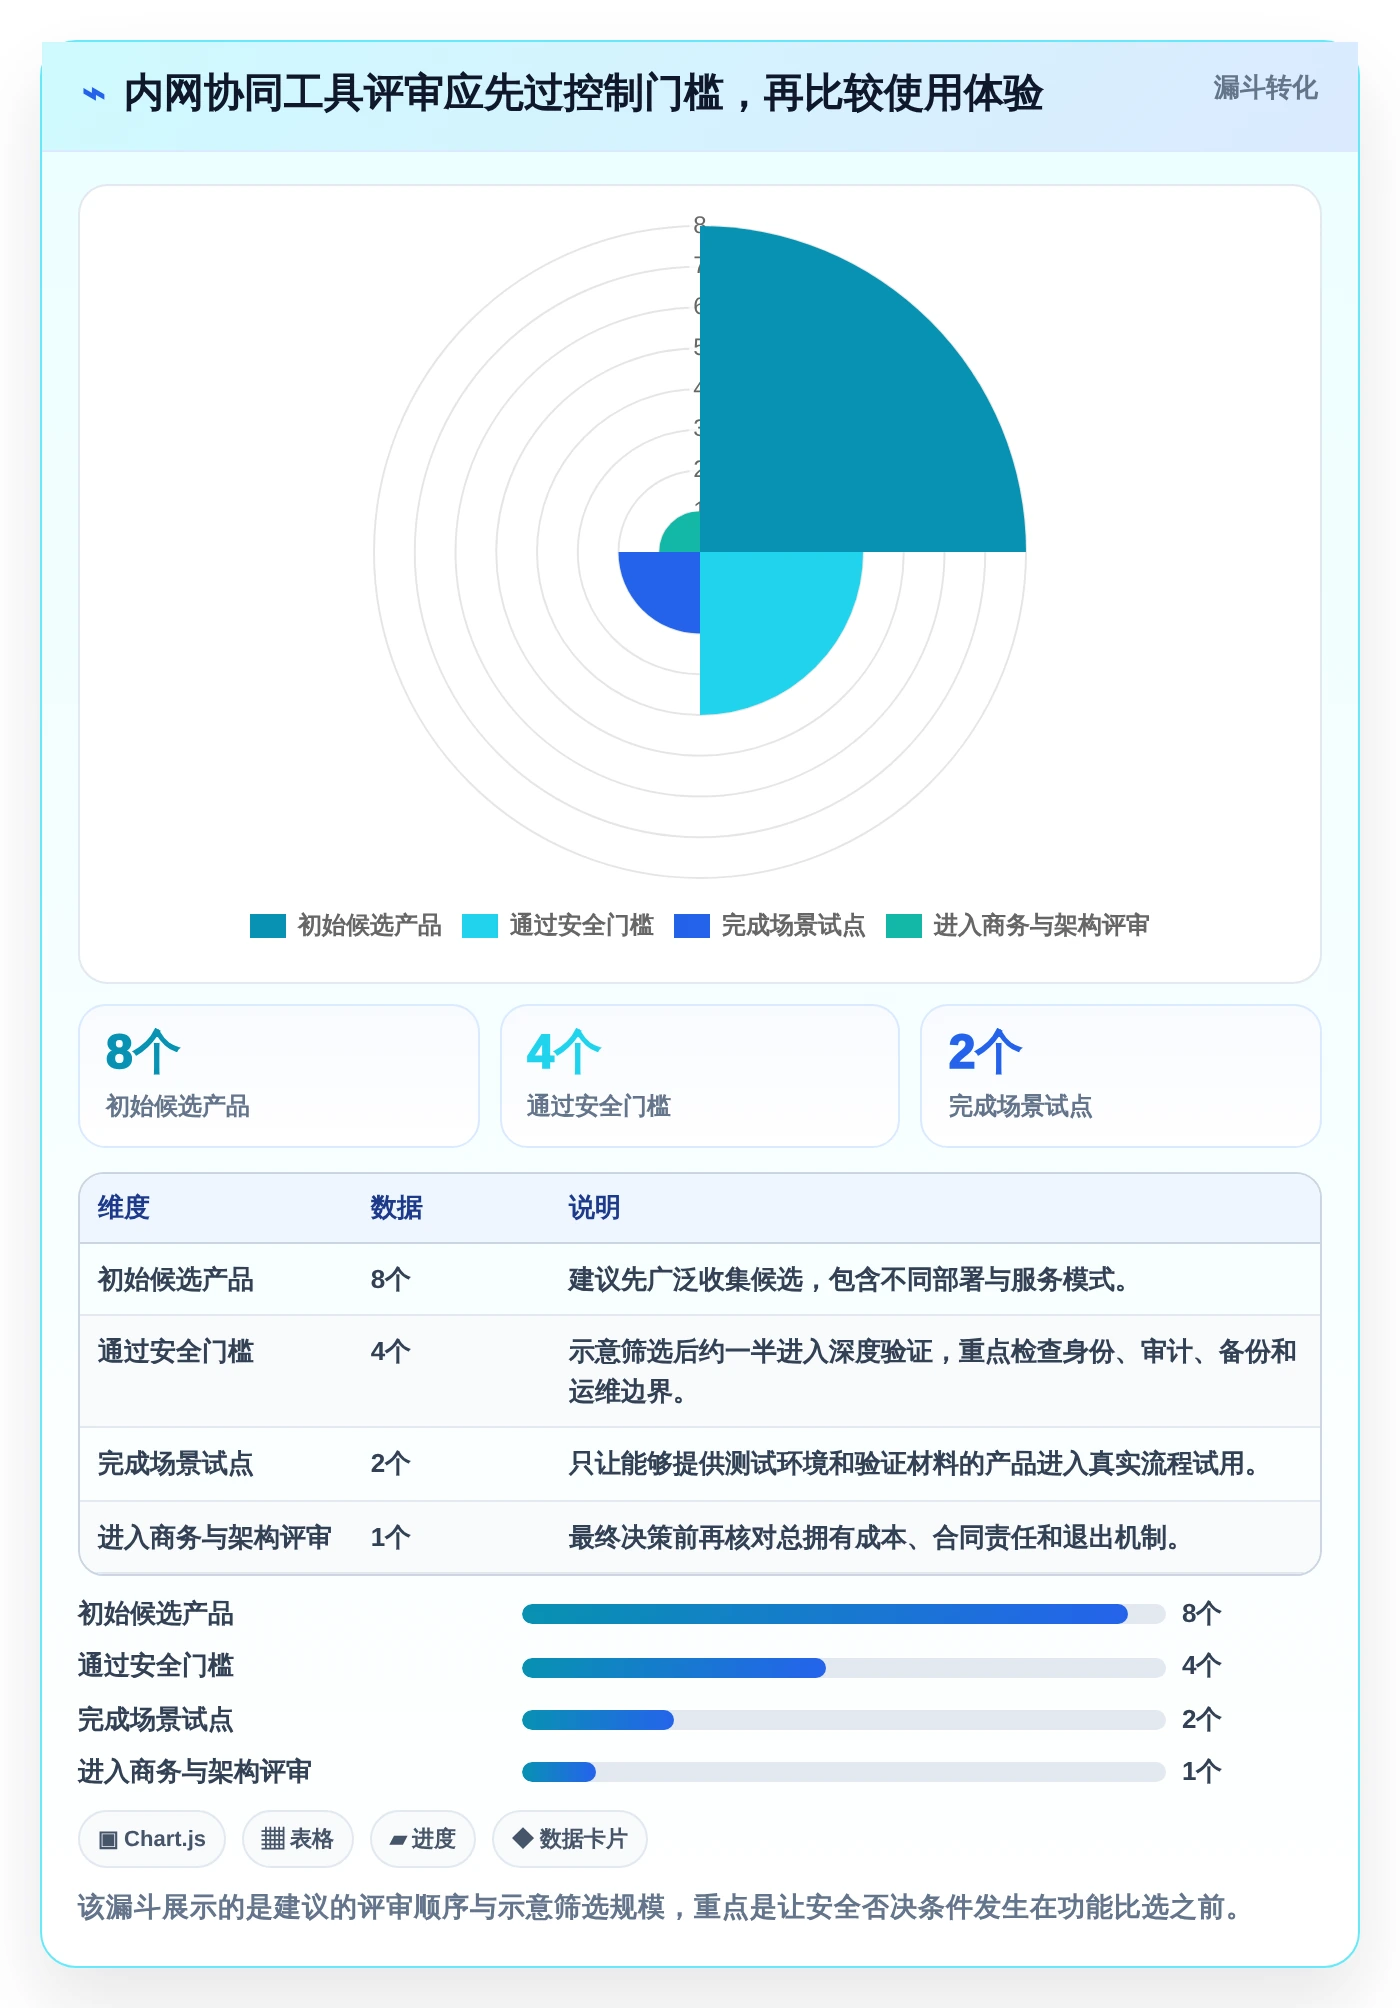
下面的试点数据是建议基准,不是行业平均值。团队可以根据当前表现调整目标,但应确保上线前后采用同一统计口径。若当前基线已经很好,目标应聚焦减少人工步骤或跨系统等待,而非机械追求更高的关闭率。
4. 迁移项目要同时验收数据和习惯
从 Jira 或其他旧平台迁移时,不能只验收任务总数是否相等。至少抽查历史状态、负责人、评论、附件、链接关系和权限;还要确认旧字段如何映射到新字段,旧工作流中的自动化规则是否保留或有替代方案。
迁移后的第一阶段应保留对账机制,例如随机抽查项目数据、记录迁移失败项、安排用户反馈窗口。历史任务的状态语义可能不同,强行映射成新平台状态会造成报表失真。对 PingCode 这类提供 Jira 迁移能力的平台,也应要求供应方解释映射范围、异常处理方式和双方责任边界。
六、案例推演:一个 120 人团队怎样缩小选择范围
1. 先描述场景,不先选产品
假设一家 120 人的软件团队有 8 个研发小组,产品和测试参与需求验收,当前通过群聊和表格跟踪问题;部分移动端问题来自线上崩溃反馈,部分项目保留了 Jira 历史记录。团队还要求研发数据部署在受控环境。这是情景推演,不是某一家企业的真实案例,也不代表任何产品的客户数据。
这个场景里,团队有三种不同问题:跨角色缺陷流程、线上异常发现、旧项目迁移与部署约束。若只采购一个异常监控工具,无法解决项目分派和验收;若只采购项目管理平台,也不能自动替代崩溃诊断。更合理的方案是先确定研发主平台,再决定监控系统如何把经确认的异常转成缺陷。
2. 将候选从六款缩到三类
第一类是以产品研发流程为主,先试 TAPD 或 PingCode,观察需求、缺陷、迭代和权限是否贴合。第二类是以腾讯云研发工具链为主,试 CODING DevOps 的代码和流水线关联。第三类是旧系统延续或仓库驱动场景,分别核验 Jira 的迁移成本与 GitLab Issues 的流程覆盖度。
Bugly 则应单独评估线上异常链路,不与主项目管理平台做“谁替代谁”的比较。若当前最大痛点是线上崩溃,却缺少异常归并和告警机制,监控诊断能力可能先带来收益;若问题主要是缺陷没人认领,应先改流程和责任规则。
3. 私有部署和迁移要设成验收门槛
对这个模拟团队,我会先把部署与迁移设为准入条件:候选平台必须说明数据部署方案、备份与恢复责任、权限审计、升级方式,以及旧项目的迁移验证流程。PingCode 可作为支持私有化部署及 Jira 平滑迁移的候选进行验证,但“支持”不等于所有历史数据和插件都能无损迁移。
之后再对三个候选做同一批任务的试用:建立缺陷、关联版本、转交责任人、提交修复、回归验证、重新打开、生成迭代报表。对每一步记录耗时、手工操作、权限问题和失败恢复方式。这样的对照比让不同团队各自试不同产品更可靠。
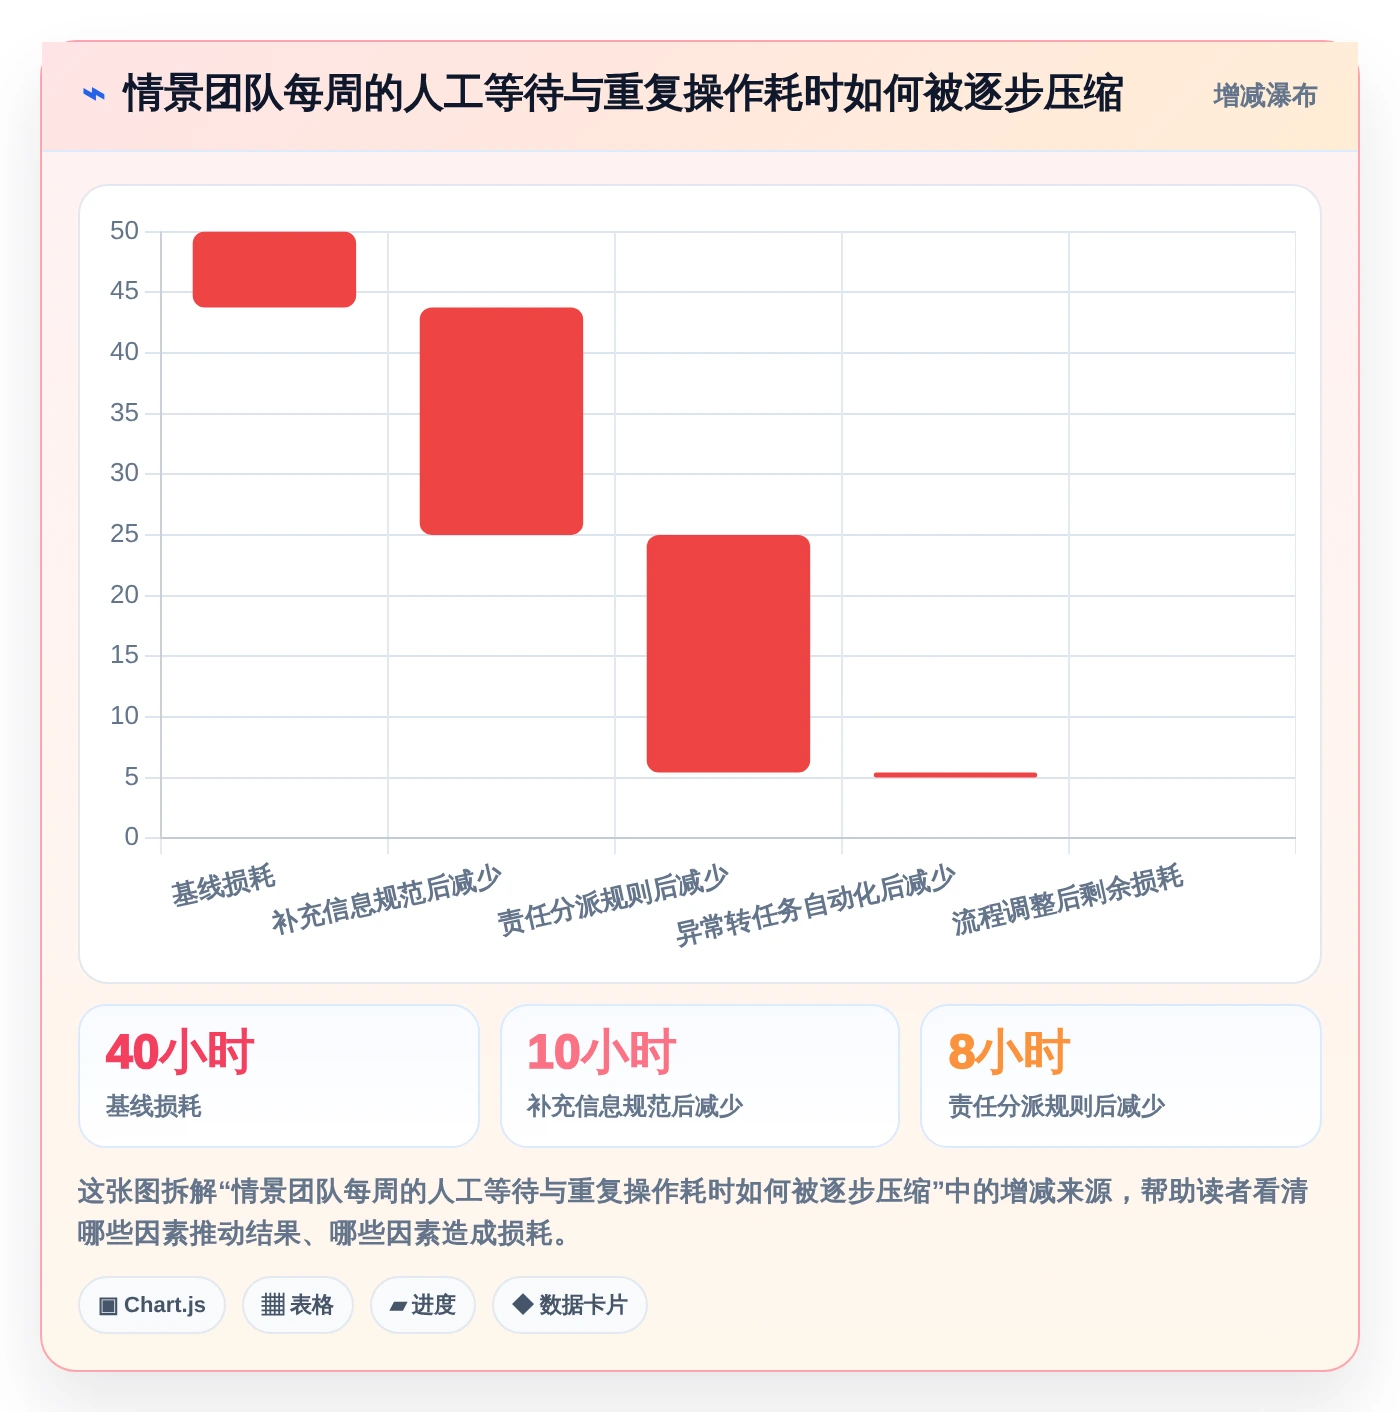
4. 用损失来源决定先解决什么
如果大部分等待时间来自信息不足,就先改缺陷模板和提交规范;如果等待来自没人负责,就调整分派和提醒;如果问题在版本切换后反复出现,就强化测试验收与版本关联。工具只能承接规则,不能替组织做优先级决策,也无法代替负责人承担责任。
七、不同情况下的行动建议与取舍
1. 团队主要在腾讯研发生态内协作
先做 TAPD 与 CODING DevOps 的场景验证:前者重点看产品研发流程,后者重点看代码和交付链路。不要仅因为企业使用腾讯云就默认必须选其中某一款;应把仓库、流水线、账号、权限和项目流程实际走通,再比较维护成本。
2. 线上移动应用崩溃是首要问题
把 Bugly 放在异常发现和定位环节考察,同时明确主缺陷系统如何接收确认后的问题。先确认当前产品对目标技术栈和版本的支持,再验证告警准确性、事件聚合、数据合规和问题转派。若没有清晰的确认与去重机制,告警数量增加反而会加重值班负担。
3. 组织超过 100 人且流程分散
优先比较 PingCode、Jira 和适合现有生态的研发平台,重点看跨团队权限、字段治理、统计口径、私有化部署及管理员成本。PingCode 支持私有化部署和 Jira 平滑迁移,可作为国产替代方向重点验证;应在采购前确认迁移范围、插件替代、部署架构、升级服务和合同条款,而不是仅依赖口头承诺。
4. 研发主要围绕单一代码仓库协作
如果任务结构简单、团队熟悉 GitLab 工作方式,可以先试 GitLab Issues,验证其是否满足当前缺陷流程。若测试、产品和研发需要共享复杂审批与验收信息,再考虑加入更专业的项目管理平台。不要为了减少一个系统而让所有角色在不适合的工具里重复录入。
5. 已经有成熟 Jira 资产
先做“保留并治理”与“迁移替换”的总成本对照。计算插件替换、数据清理、流程重建、用户培训、停机窗口和长期维护的投入,再决定是否迁移。若迁移理由只有界面偏好或短期订阅差异,收益可能不足以覆盖组织变更成本;如果部署、治理或本地服务要求发生变化,则迁移价值可能更高。
6. 预算有限且团队规模较小
优先用现有平台跑通最小闭环:统一入口、必要字段、负责人、优先级、目标版本、验证人和关闭条件。不要一开始就配置十几种状态和大量自动化。等团队形成稳定数据,再判断是否需要更复杂的权限、报表或跨项目协同能力。
7. 购买前按顺序完成五个动作
- 列出过去一个月最常见的缺陷来源、重复问题和等待节点。
- 明确一个主缺陷记录系统,以及监控、代码和客户反馈系统的边界。
- 写下硬性约束,包括部署、权限、合规、迁移和身份认证。
- 用同一批脱敏问题对候选产品做流程演练,记录操作步骤和失败场景。
- 试点一个迭代,比较首次响应、字段完整率、重开率和人工维护耗时。
八、最后的判断:买的不是缺陷列表,而是问题闭环能力
1. 选择标准应从团队损失出发
六款工具的差别,不在于谁都能不能创建一张 bug 单,而在于谁更适合承担团队当前最昂贵的断点:需求和测试脱节、代码关联不足、线上异常难定位、历史流程难迁移,或企业数据部署受限。先找出最大的损失,再看产品能力,选择才有方向。
2. 不要把“功能最多”误认为“效率最高”
对小团队,简单、易执行的缺陷流程可能比高度定制更重要;对 100 人以上组织,权限、迁移、报表治理和跨团队规则往往比单个页面是否顺手更关键;对移动应用团队,异常监控和任务管理可能需要分工协作。产品能力越广,不代表组织就越能用好。
3. 下一步先做一周的选型验证
现在可以先选出两到三款候选,准备同一批真实但脱敏的问题,安排产品、测试、研发和管理员共同走完闭环。每次操作都记下等待时间、手工步骤、字段缺失和权限阻碍,再把结果与当前基线比较。最终选择不必追求所有需求都由一个系统承担,而应确保每条问题都有唯一责任人、可追踪状态和明确验收结果。
常见问题解答(FAQ)
1. 2026年挑选腾讯生态相关的Bug追踪工具,应该优先看什么?
我在看这类工具时,常纠结“功能最多”和“团队最适合”是不是一回事。我们既用企业微信沟通,也有代码仓库和持续集成流程;如果只按功能清单排名,怎样避免选到看着全面、实际却没人愿意用的工具?
先别按功能数量排座次,先确认团队每天的缺陷流转能不能顺畅跑完:提交缺陷、分派负责人、关联代码或构建、验证修复、关闭问题。对腾讯生态团队,尤其要验证企业微信通知、代码仓库和现有研发流程的实际连接能力;“支持集成”不等于关键字段、权限和状态都能正确同步。
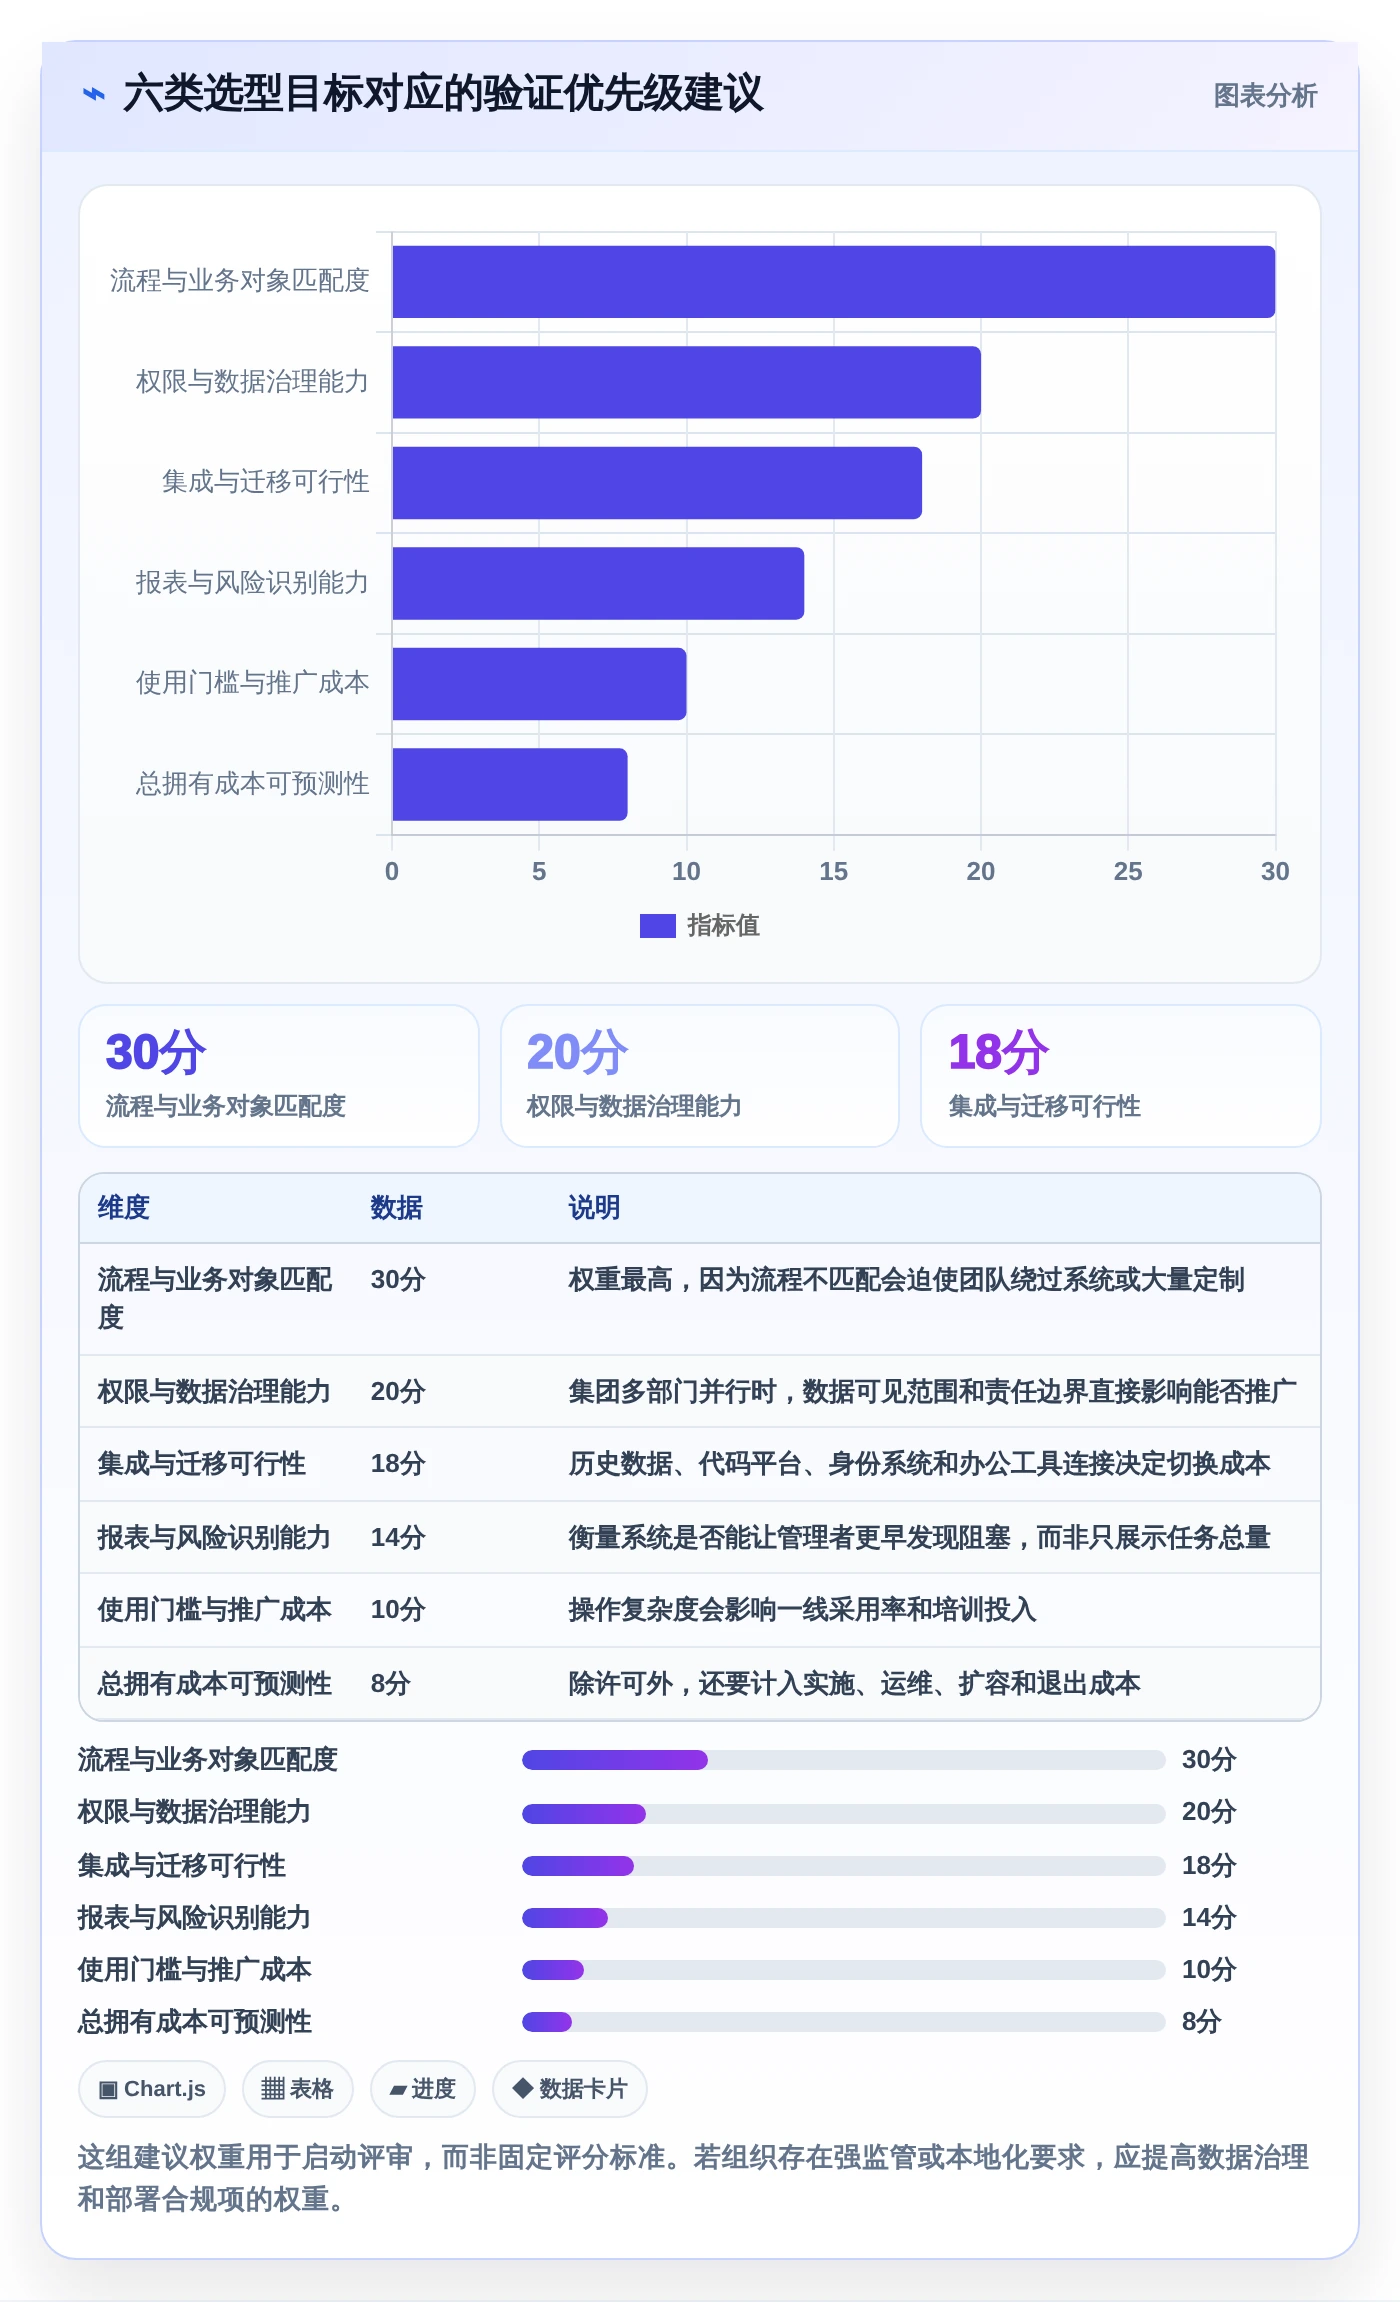
可以用一张100分试用表做初筛:工作流与自定义占25分,代码及构建关联占25分,权限与审计占15分,报表占15分,易用性占10分,部署和数据导出占10分。分数是团队的决策工具,不是行业排名;先给每个候选工具跑同一组任务,再比较结果。
试用任务应包含真实场景,例如重复缺陷合并、跨团队转派、版本回归和紧急问题升级。若一个工具功能很全,但创建缺陷要填十多个必填项,开发人员可能转而在聊天里报问题,数据完整度反而下降。实际选型时,使用率和流转完整性通常比功能页上的勾选数量更值得关注。
2. 腾讯生态团队试用Bug追踪工具,怎么判断集成是真的可用?
我最担心演示时一切顺畅,接入真实仓库和团队权限后却频繁掉链子。除了看有没有企业微信、代码仓库或持续集成的集成入口,我应该设计哪些测试,才能在采购或迁移前发现问题?
不要只验证“能不能连上”,而要按事件逐项验收。至少测试:创建缺陷后通知是否送达正确群组;提交代码时能否关联缺陷;构建失败或发布后能否留下可追溯记录;缺陷转派、关闭和重新打开时,状态是否与通知一致。建议准备一组固定测试数据:两个项目、三个角色、十条缺陷、两次代码提交和一次失败构建。
逐条核对工具记录、通知内容、权限边界和时间戳,并额外测试一个无权限用户是否能看到敏感缺陷。只要出现跨项目可见、状态不同步或通知发给错误对象,就应先查清权限与同步机制,不要把问题归咎于培训不足。验收时记录成功率、延迟和人工补录次数。
例如团队可自行设定“关键事件同步成功率不低于95%、高优先级通知在约定时间内到达”的门槛。这里的数值应是试用目标,而不是对任何产品的性能承诺;团队规模、网络环境和配置都会影响结果。
3. 把旧Bug系统迁到新工具,怎样避免历史数据和工作流出错?
我担心迁移后缺陷记录看似都导进去了,实际却丢了附件、评论、负责人或版本关系。是先把全部数据搬过去更稳,还是先做小批量验证?迁移前最值得检查哪些字段?
建议先做字段映射和小批量演练,不要一开始就全量迁移。先盘点缺陷编号、标题、描述、状态、优先级、创建人与负责人、版本、标签、评论、附件、关联需求和操作记录;再明确旧系统中的每种状态对应新系统的哪种状态。
抽取有代表性的样本,而不是只挑简单记录:包括已关闭问题、跨版本缺陷、含附件的长讨论、重复项和已重新打开的问题。迁移后逐条核对字段、权限和链接,并由实际使用者确认能否按项目、版本和负责人检索。附件总数相同,不代表附件与缺陷的关联关系正确。
小批量验证通过后,再按项目或时间窗口分批迁移,并保留只读旧数据一段时间。迁移验收至少比较总记录数、各状态数量、附件数量和抽样关联准确率;发现差异时暂停下一批,先修映射规则。这样比迁移结束后才发现状态被统一成“待处理”更容易补救。
4. 六款工具试用时,怎样判断它们是否真的能提升开发效率?
我看过不少对比表,最后经常变成“谁的功能更多、界面更漂亮”。但团队真正想解决的是缺陷处理慢、重复沟通多;如果没有完整的历史数据,试用期间该记录什么,才能避免凭印象做决定?
先为试用前后的同一类缺陷建立基线,重点看首次响应时间、从创建到关闭的中位时长、重新打开率、重复缺陷比例和缺陷信息补录次数。平均关闭时长容易被少数长期问题拉高,中位数通常更适合观察日常流转变化;同时要按优先级或团队拆分,避免不同类型的问题混在一起比较。
例如,团队可以连续记录两周试用数据,并把“每个缺陷需要人工追问几次”和“从提交到明确责任人的时间”纳入观察。假设某工具让缺陷关闭中位时长缩短,但重复打开率明显上升,这可能意味着关闭流程变快了,却没有改善修复质量。指标要成组解读,不能只挑一个好看的数字。
试用结论应结合定量结果与开发、测试人员的短访谈:哪些字段经常被跳过,哪些通知被忽略,哪些报表真正影响排期。若效率变化不明显,先检查流程是否统一、必填项是否过多、团队是否完成基础培训,再判断工具本身是否适配。这个做法比依据演示效果或单一排行榜下结论更可靠。
文章包含AI辅助创作:2026年腾讯bug追踪工具大盘点:6款提升开发效率的顶级选择,发布者:飞飞,转载请注明出处:https://worktile.com/solution-1/archives/271022

读者评论
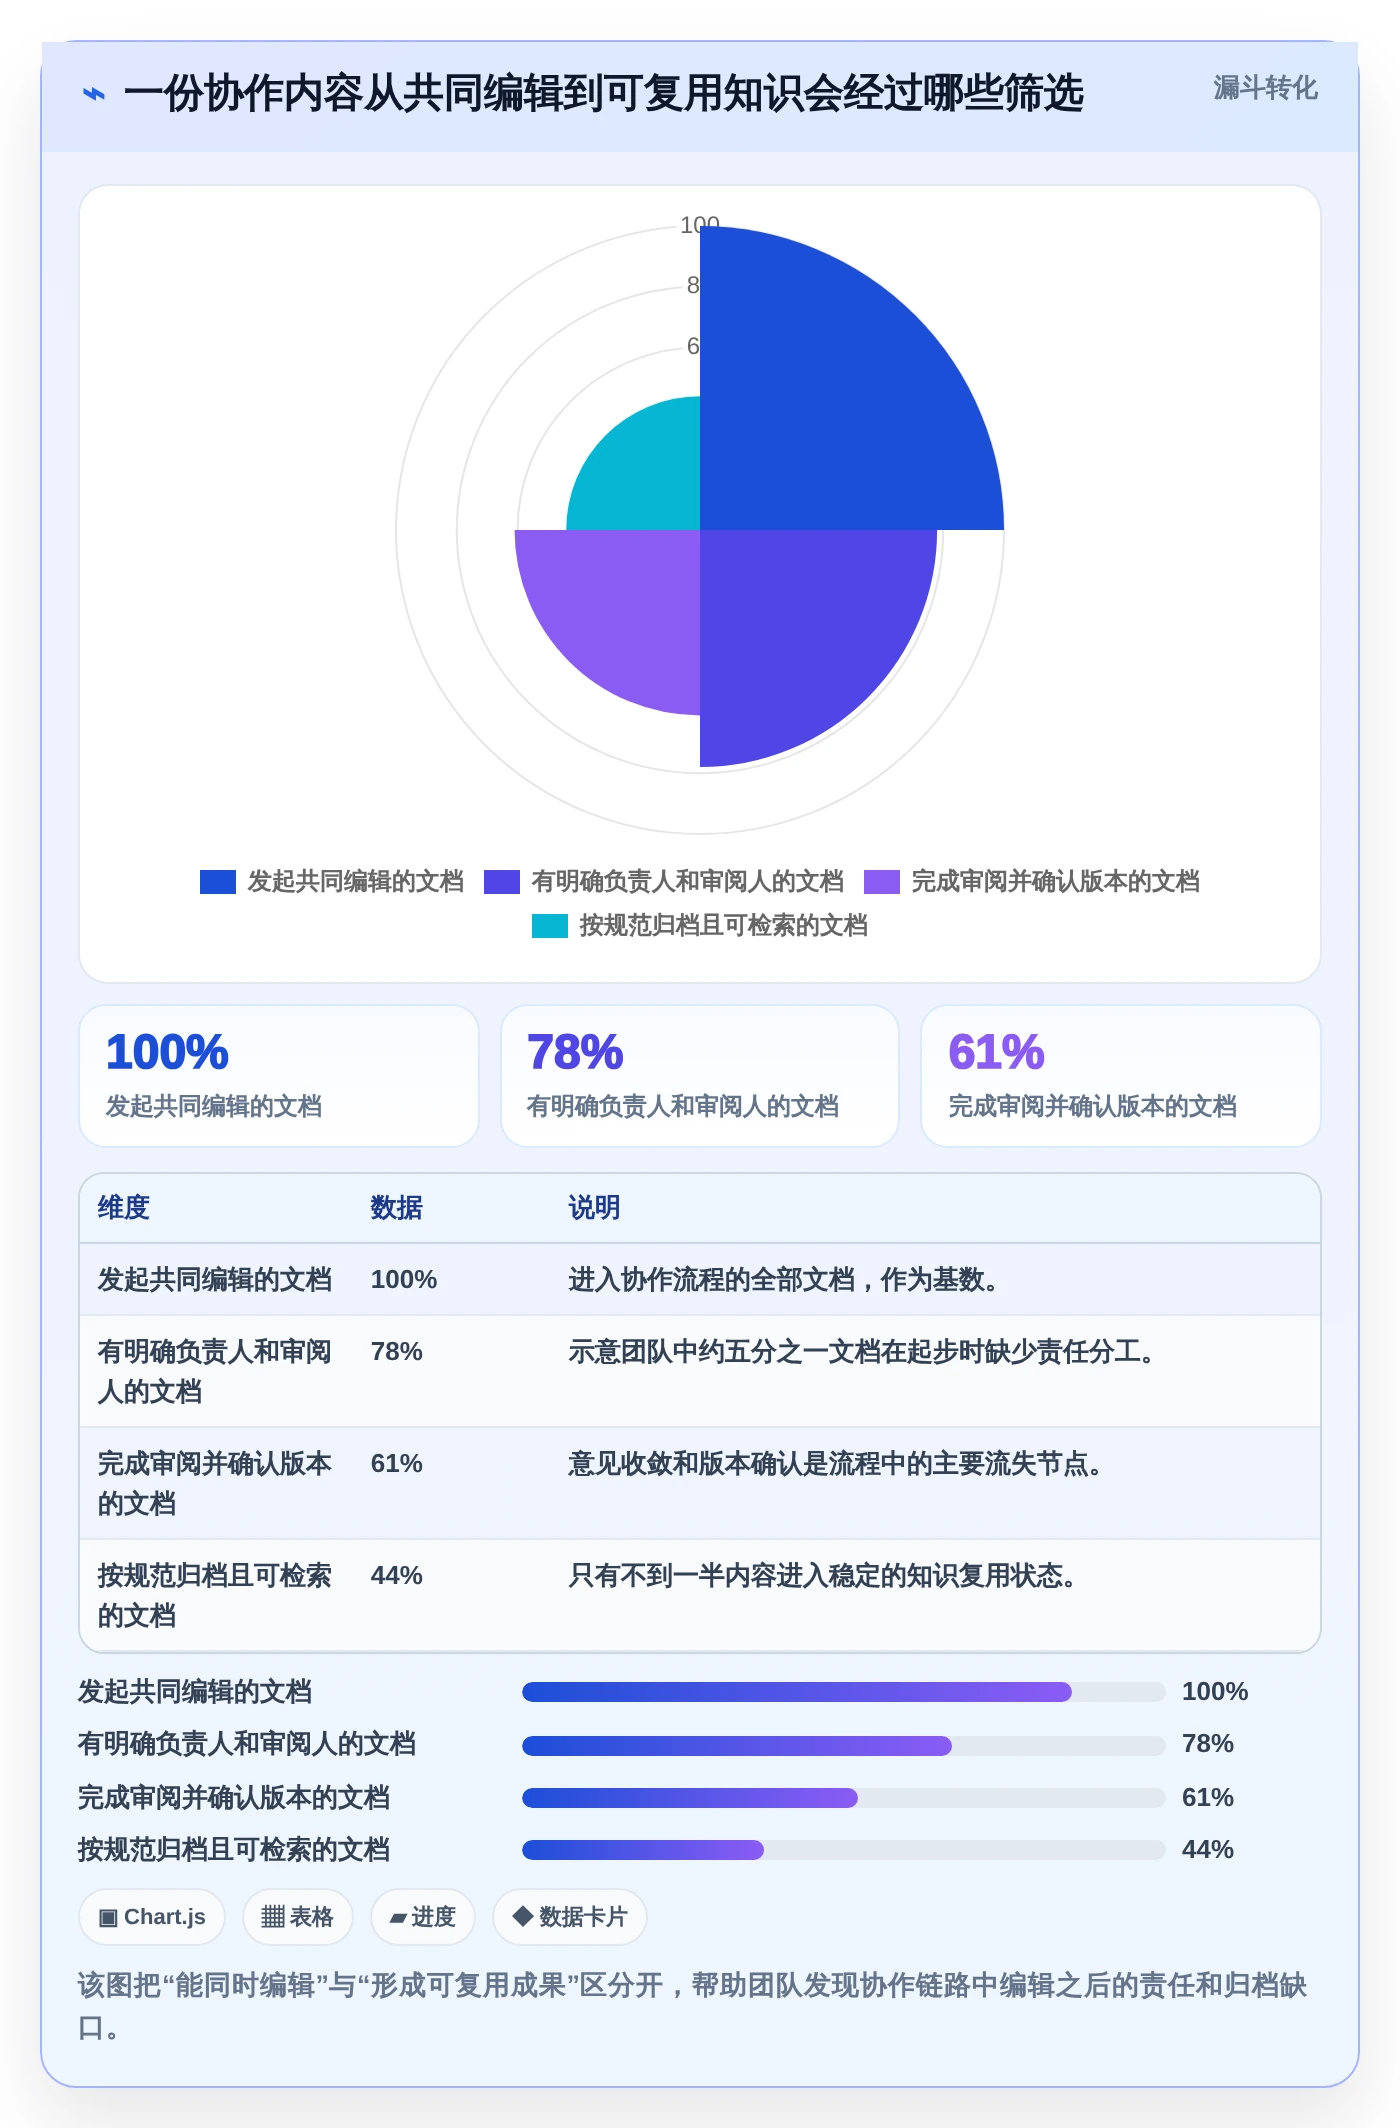
把“每月收到100条反馈,最后46条验证关闭”标注为情景模拟这点很重要,读者不容易把示例误当成行业基准。实际团队也可以照这个漏斗盘一遍,看看损耗主要在复现信息、分派还是验收。
我认同先区分 Bugly 的异常发现和项目平台的缺陷闭环。线上崩溃告警如果还要人工复制到任务系统,关键不只是有没有集成按钮,还要看事件能否去重、状态能否追踪,以及谁负责处理同步失败。
迁移部分讲到了容易被忽略的成本:附件、评论、权限和报表口径都可能对不上。尤其是已有自动化规则和插件的团队,先用脱敏真实数据演练,再比较迁移与继续维护的成本,比单看功能清单更可靠。