去年年底,我帮一家做工业自动化设备的企业复盘他们运行了两年的360绩效考核系统。HR负责人给我看了一份"漂亮"的报告:全员平均分4.62(满分5分),91%的员工被评为"优秀"或"良好",跨部门协作维度得分最高。但同一时间,这家公司的项目交付准时率只有63%,研发与销售的跨部门投诉在内部工单系统里积压了200多条。评分和现实之间的这道裂缝,就是形式主义最典型的形状,不是没人打分,而是打出来的分不指向任何真实判断。
这不是个案。在我参与过诊断的三十多家企业里,360度评估几乎是最容易"上线即失效"的HR模块:它比KPI更容易推行,因为不涉及硬指标博弈;它比述职更容易操作,因为可以线上点几下完成;但它也最容易变成一场所有人默契配合的表演。问题从来不在"多维度"这三个字上,而在于多维度评估的三个结构性前提被忽略了:维度是否可观测、评价者是否有资格、结果是否进入真实决策。这篇文章我会把这三个前提拆开讲透,并给出不同组织规模下可以照着做的配置方式和取舍逻辑。
一、核心结论:360度评估失效,几乎都源于三个结构性缺陷
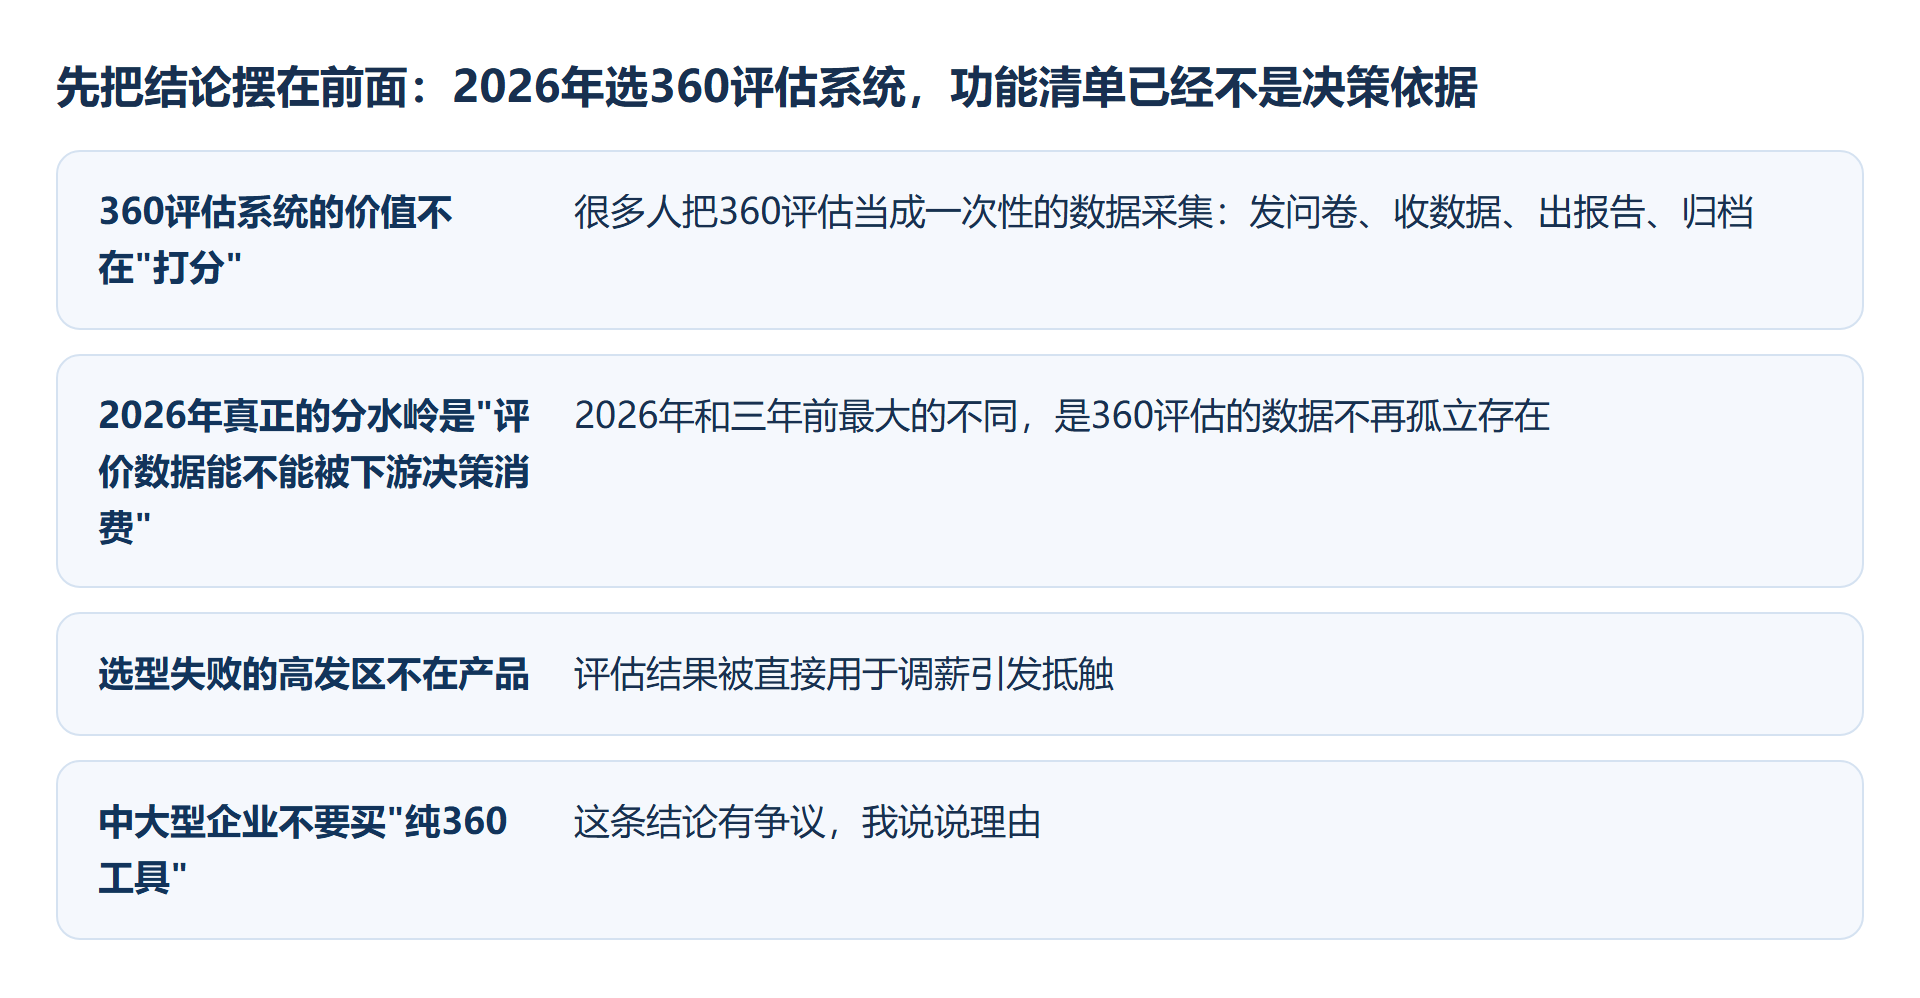
先把结论摆在前面。多维度评估之所以沦为形式主义,不是因为维度设计得不够花哨,也不是因为员工觉悟不够高,而是因为系统在三个环节上默认了"人性会自动向善",而真实组织里,人性只会向"成本最低"的方向走。
1. 维度上限由"可观测性"决定,不由"全面性"决定
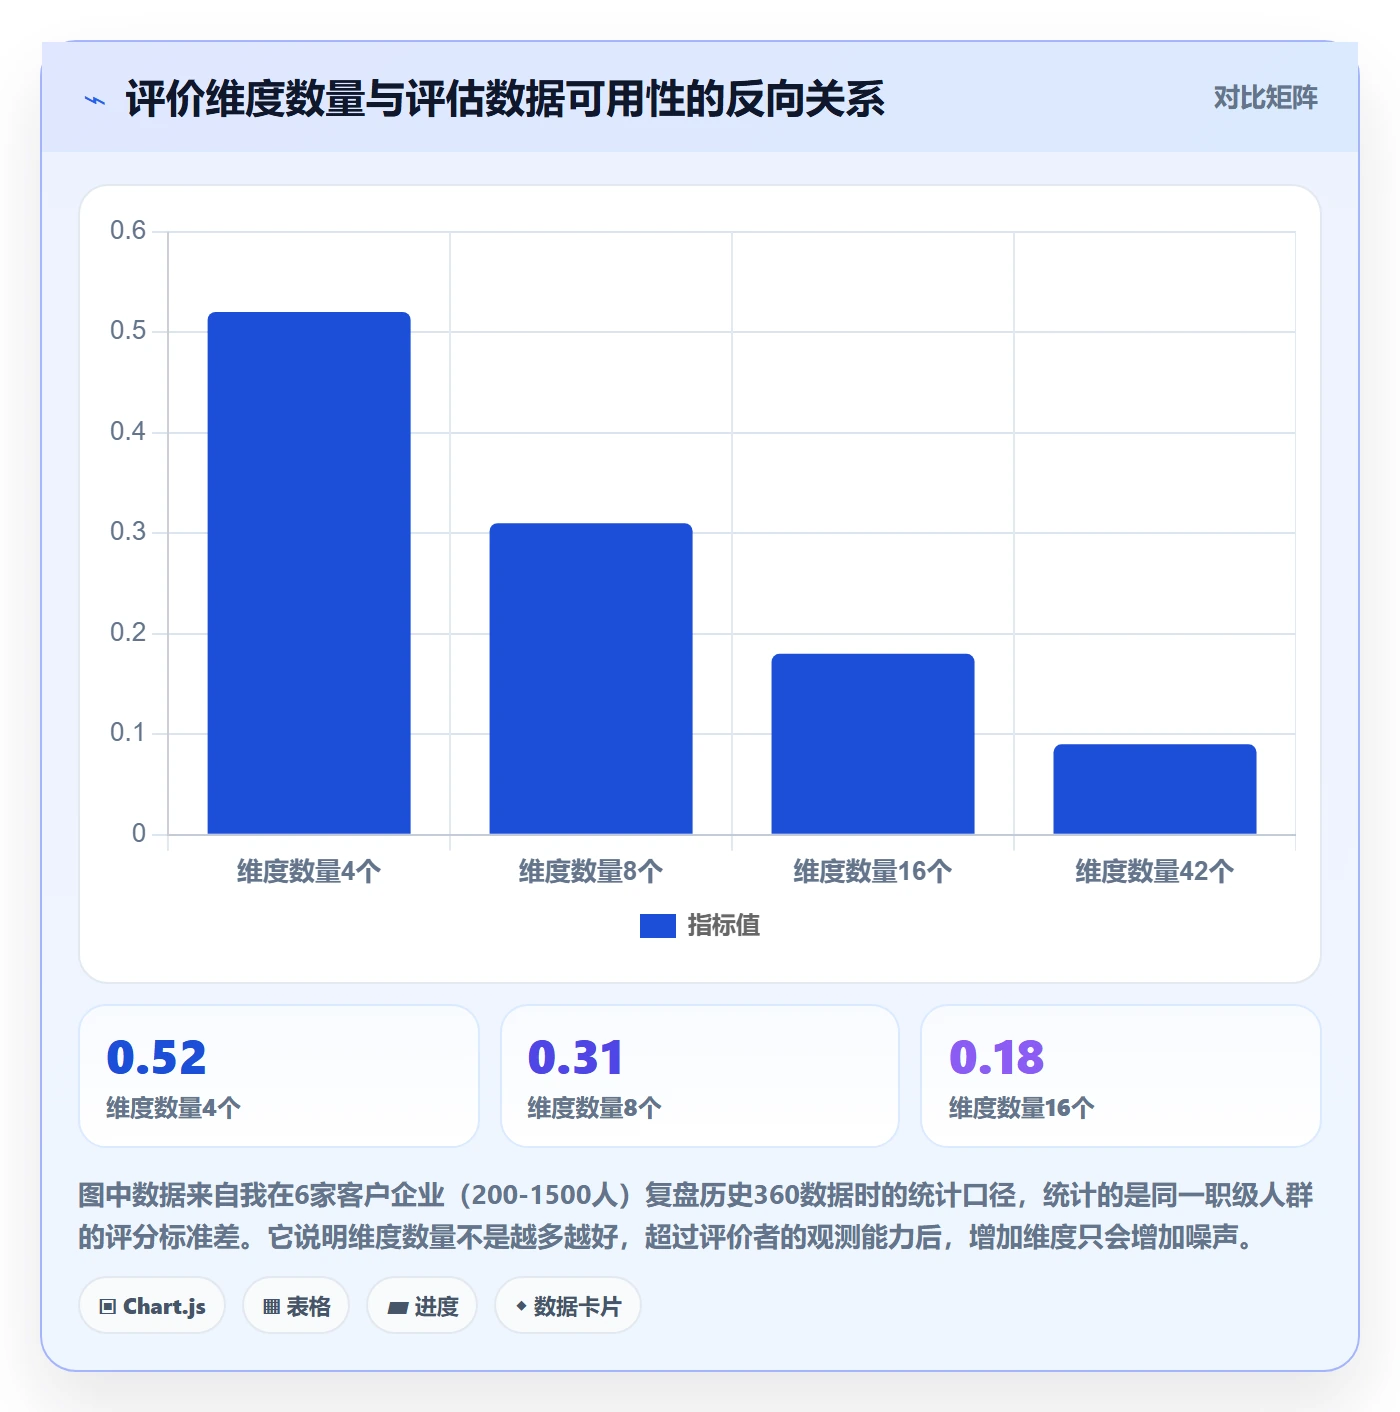
我见过最夸张的一份360问卷有42道题,覆盖"战略思维、创新意识、客户导向、团队协作、执行力、学习能力、抗压能力、职业操守"八个维度。设计者的逻辑是"越全面越公平",但实际结果是:评价者在第15题之后就开始凭印象点,第30题之后基本是连续点同一个选项。
更关键的问题是,其中"战略思维""创新意识"这类维度,一个平级同事一年可能只接触你三五次会议,他根本没有足够的行为样本支撑判断。评价者对被评价者的行为观测频次,才是维度的真实上限。观测不到的东西,打出来的分数不是信息,是噪声。
我的经验判断是:一个评价者对被评价者在某个维度上的有效观测,一年至少要达到6次以上具体事件,这个维度才值得放进他的问卷。低于这个频次,要么换评价者,要么删维度。
2. 360的第一用途是发展,不是分配
这句话听起来像老生常谈,但真正理解它的人不多。差别在哪?如果360的结果直接决定奖金系数和晋升名额,那么打分就变成了博弈:给下属打低分,可能影响团队整体额度;给平级打低分,明年对方也会还回来;给上级打低分,风险更直接。博弈一旦形成,分数就会系统性地向中间或偏高收敛。
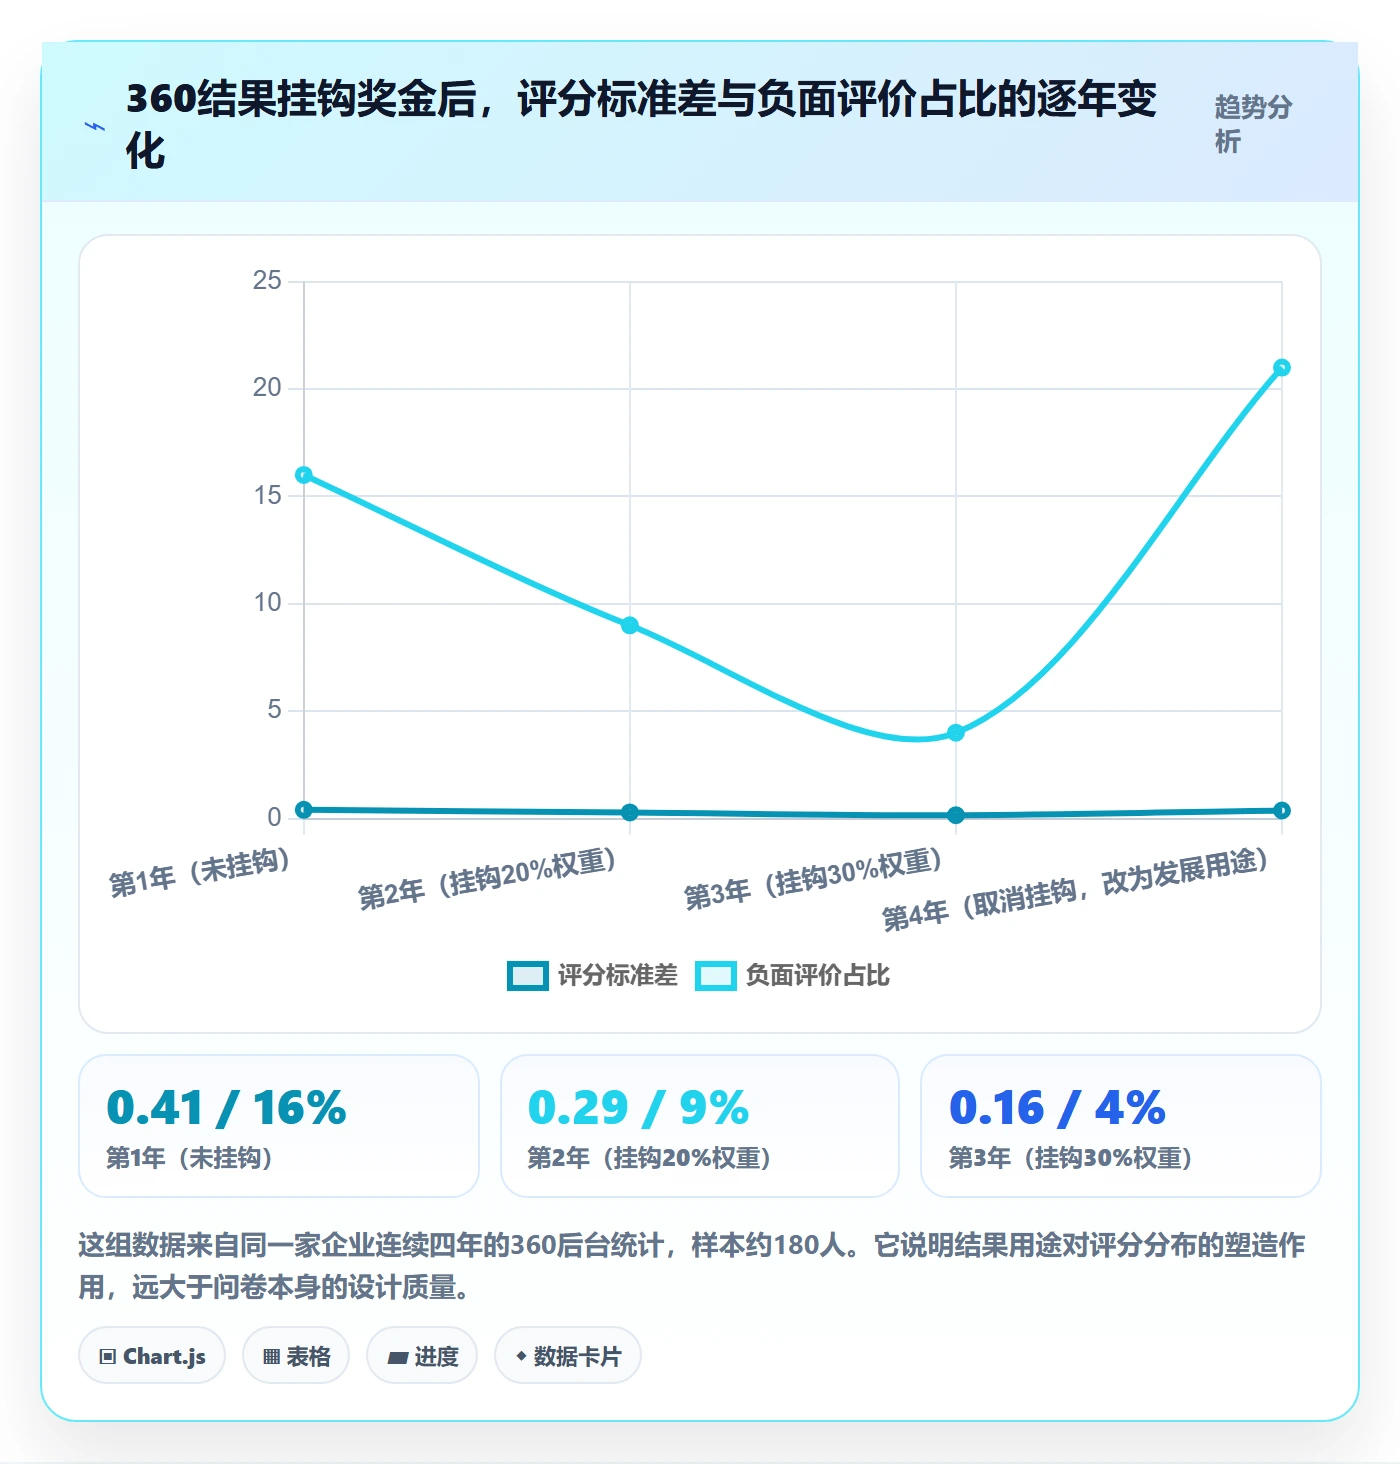
反过来,如果360的结果主要用于个人发展计划、培训选题、岗位调整参考,评价者的心理负担会显著下降,负面反馈的供给量会上升。我在两家客户那里做过对比:同样一套问卷、同样一批人,把结果用途从"绩效系数"改成"发展诊断"并明确告知后,负面评价(3分及以下)占比从4.7%上升到19.3%,而评价完成率反而从78%升到94%。负面信息的供给量,是判断360是否还活着的核心指标。
3. 结果必须进入至少一个真实决策,否则一定腐烂
形式主义最隐蔽的形态,不是打高分,而是"打完没人用"。当员工发现连续两年认真填写的评估意见从未在任何场合被提及,第三年他就会用30秒填完。这个过程是不可逆的。
所谓"进入真实决策",不一定非要是奖惩。它可以是一次一对一沟通里被引用的原话,可以是一份个人发展计划里的两条行动项,可以是一次培训名单的筛选依据,也可以是一次晋升评议会上被拿出来讨论的异议。关键不在于用得多重,而在于用得可见。
二、背景与真实场景:形式主义是怎么一步步长出来的
要避免形式主义,得先看清它长出来的过程。它通常不是一次性发生的,而是分四个阶段缓慢演化,每个阶段都有明确的信号。下面三个场景,是我在不同行业客户那里看到的真实演化路径。
1. 场景一:200人软件公司,8维度全员互评,两年后数据归零
这家公司的初衷很好:想打破"技术只看代码、销售只看回款"的单维评价。第一年上线8维度互评,每人被5-8名同事评价,系统自动汇总。
第一年数据还算健康,评分标准差0.41。第二年,公司把360结果按20%权重并入绩效奖金。第三年我接手诊断时,标准差已经降到0.16,全公司有73%的人落在4.0-4.5这个区间。有意思的是,他们内部其实矛盾不少,研发和售前的扯皮在周会上经常爆发,但问卷里"跨部门协作"这一项的平均分是4.53。
转折点就是那个20%权重。它把"如实评价"和"个人利益"绑在了一起,于是理性人的最优策略变成了"给所有人都打4.2"。
2. 场景二:1200人制造企业,班组长评估,维度对但评价者错
这家企业的设计相对克制,只用了4个维度:安全意识、现场管理、带人能力、问题响应。听起来很扎实。但问题是,评价者名单是系统按组织架构自动生成的,被评价者的直接下属、平级班组长、上级主管,各占一定权重。
实际运行中,平级班组长之间跨车间,一年说不上几句话,这部分评分完全是随机的;而下属评价又高度受排班、加班安排影响,本质是"满意度"而非"带人能力"。真正有观测的人是车间主任,但他只占25%权重。
这里的问题不是维度设计,而是评价者与被评价者之间的观测关系没有被建模。系统按汇报线生成名单,是最省事的做法,也是最容易错的。
3. 场景三:连锁零售,360与晋升硬挂钩,导致"高分低能"晋升
这家企业把360得分作为店长晋升的区域经理的必要条件,要求连续两次360得分排名前30%。结果很有意思:晋升上来的一批区域经理,门店运营数据反而下滑。
原因不复杂。擅长"人际关系经营"的店长更容易拿到高分,他们会主动帮同事顶班、在群里积极互动、对上级汇报勤快。但这些行为和"能否管好8家门店的库存周转和人员流失"之间的相关性,其实很弱。真正在抓运营的店长,因为对下属要求严,反而在"团队氛围"这一项上失分。
这是多维度评估最危险的误用:把一个测量"关系质量"的工具,用来预测"岗位胜任力"。两者的相关性远低于大多数HR的预期。
4. 一个反常识的观察:完成率高的360,往往更形式主义
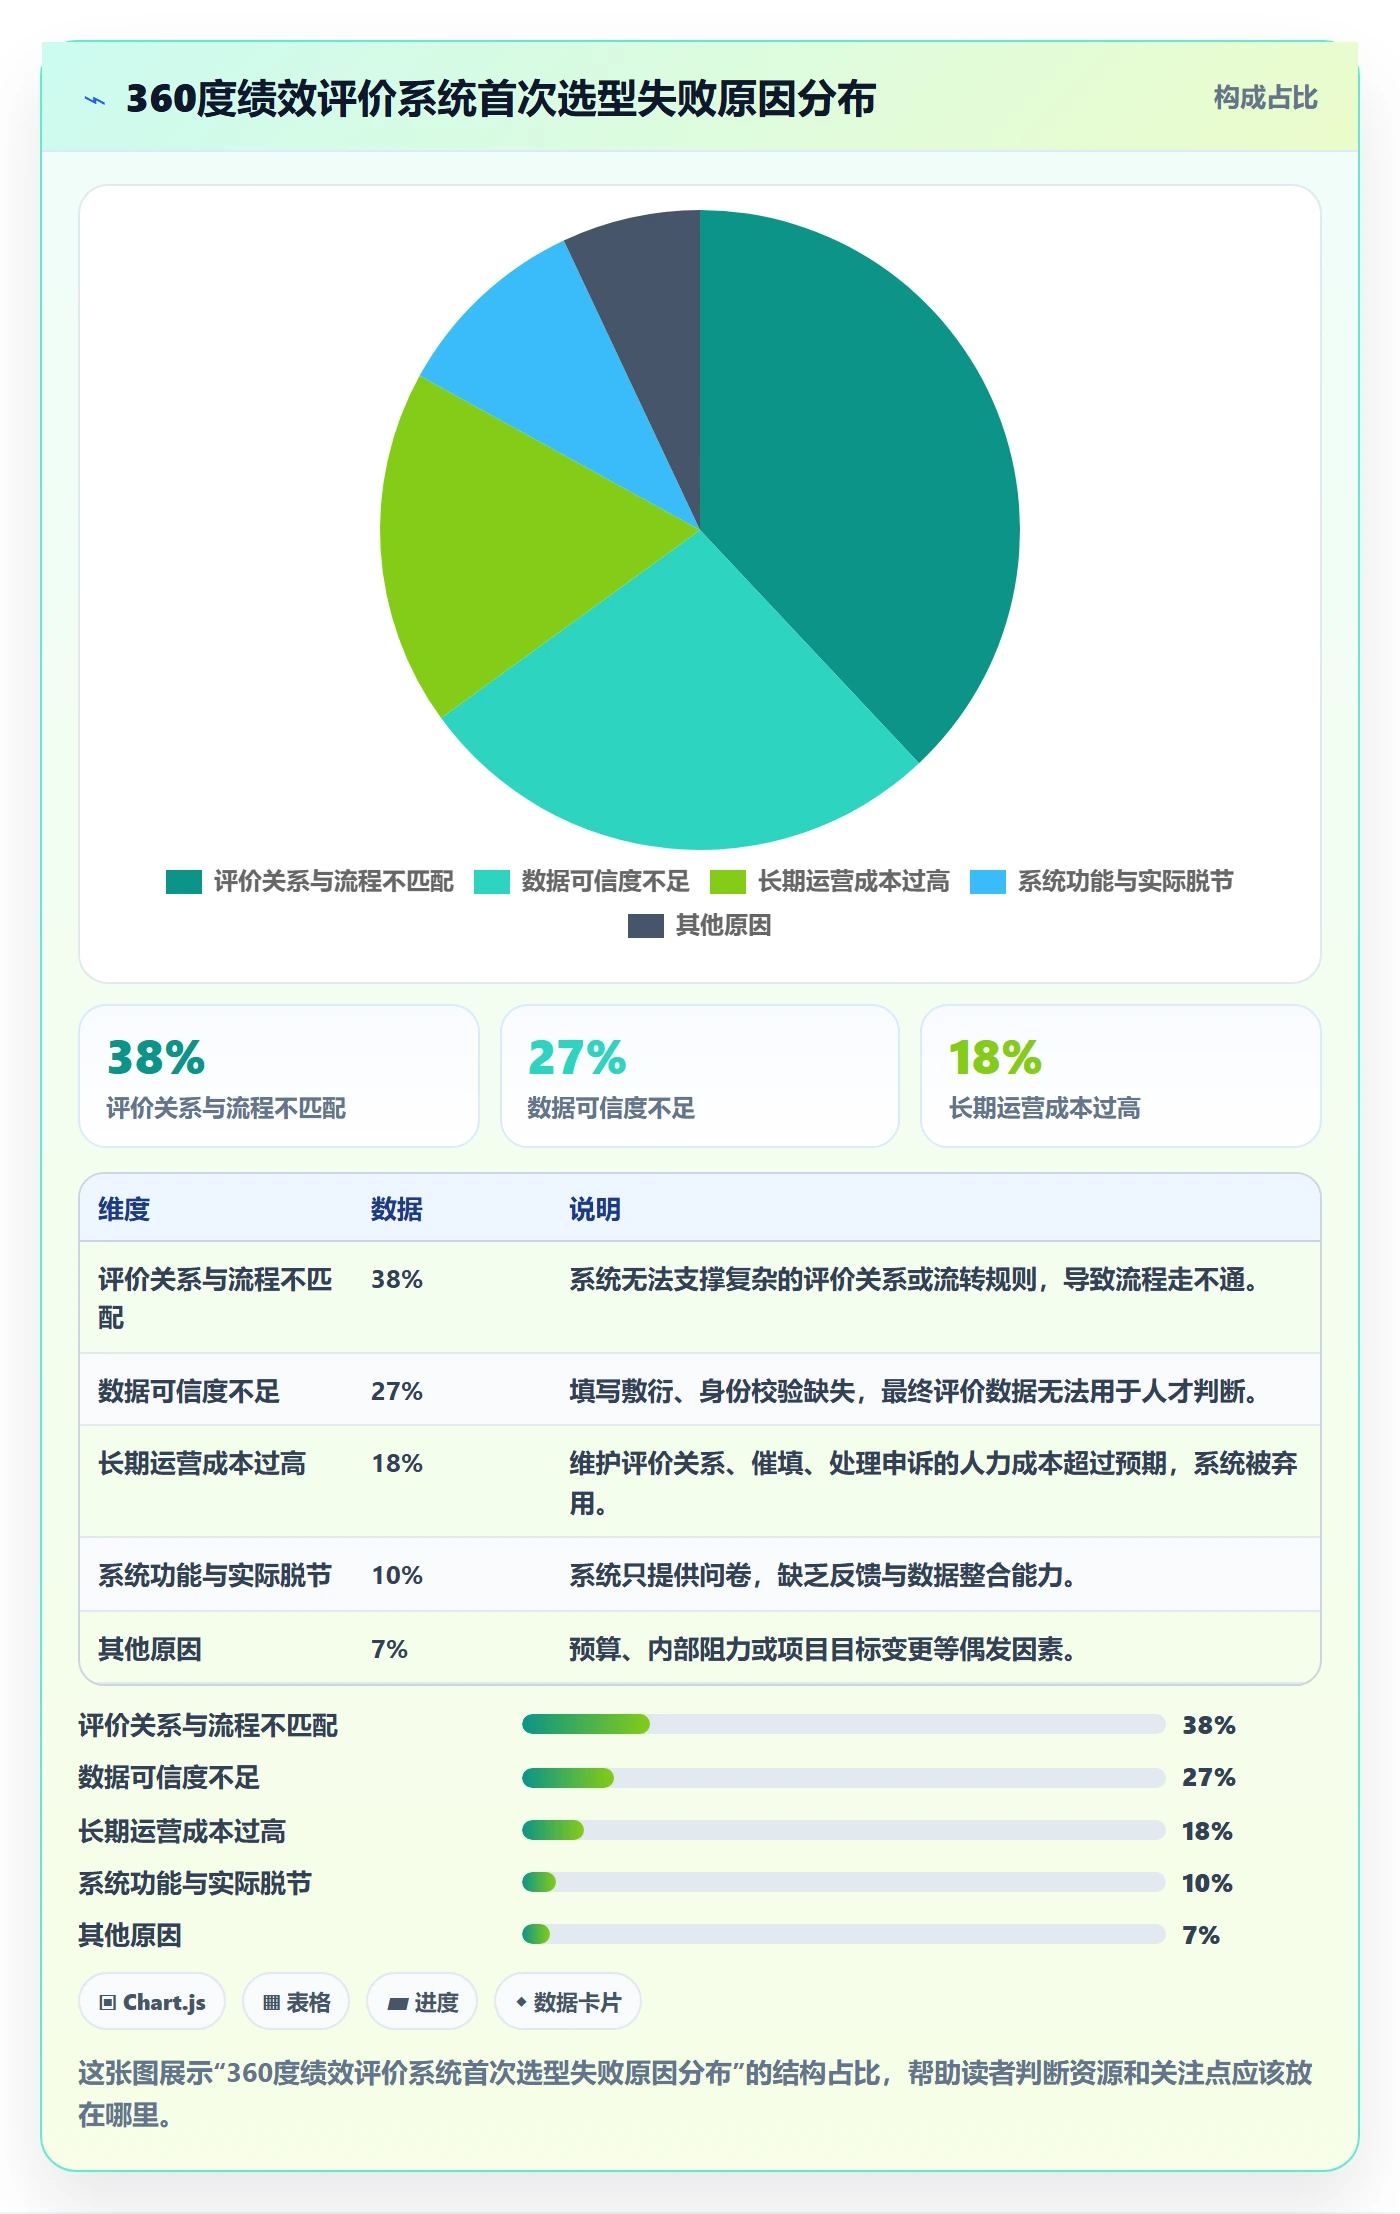
很多HR把"评估完成率"当成健康指标,认为95%以上就说明大家重视。我的观察恰恰相反:当完成率达到98%以上、且平均填写时长低于5分钟时,基本可以判定这份数据已经形式化了。
真正有效的360,完成率通常在85%-93%之间,因为有一部分人会认真思考、反复修改、甚至主动找HR确认题意。那5%-10%的"未完成",恰恰是深度参与的痕迹。我在利唐i人事的后台数据里也反复看到这个规律:填写时长中位数在8-12分钟的评估轮次,评分区分度明显高于3-5分钟的轮次。
三、拆解五个常见误区:每一个都在制造形式主义
下面这五个误区,我在诊断中几乎每次都能遇到至少三个。它们的共同点是:出发点都是"让评估更严谨",结果都是"让评估更失真"。
1. 误区一:维度越多越全面,越全面越公平
这是最普遍的误区。设计者的心理是"漏掉一个维度就是不公平",但评估不是考试,覆盖面不等于准确性。
维度增加会带来三重损耗:评价者的认知负荷上升导致后段敷衍;不同评价者对同一维度的理解口径分化;维度之间的高相关性让权重设计失去意义。我做过一次相关性分析,某企业8个维度里有5个两两相关系数超过0.8,等于用5个名字在测同一件事。
我的判断标准是:如果两个维度的相关系数长期高于0.75,就应该合并。保留4-6个真正独立的维度,比堆12个更有效。
2. 误区二:匿名就等于真实
匿名是必要条件,但不是充分条件。在小团队里(评价者少于5人),匿名几乎无效,被评价者能从措辞、时间、内容推断出是谁。更麻烦的是,评价者自己也清楚这一点,于是依然不敢说真话。
还有一种情况:系统声称匿名,但HR后台能看到是谁打的分。一旦有过一次"泄露"传闻(无论真假),整个评估的可信度就会崩塌,且很难修复。
我的做法是:评价者少于5人时,不展示个体分数,只展示汇总后的定性描述;同时在系统中明确公示"哪些角色能看到什么颗粒度的数据"。透明度比匿名承诺更能建立信任。
3. 误区三:把360结果直接换算成绩效系数
这是破坏性最强的一个做法。前面场景一已经说明了后果。这里补充一个更隐蔽的伤害:一旦挂钩,员工会把注意力从"我该怎么改进"转向"我该怎么让别人给我打高分",行为被扭曲,而扭曲的行为往往和真实绩效负相关。
如果确实需要多方评价进入绩效,更稳妥的做法是把360结果作为"校准输入"而非"计算因子",即在绩效校准会上,主管可以参考360的定性反馈来解释或修正自己的判断,但不做机械加权。这样既保留了多维视角,又避免了分数博弈。
4. 误区四:全员用同一套问卷
不同岗位的关键行为差异极大。研发岗的"协作"是代码评审和知识分享,销售岗的"协作"是线索交接和客户共访,用同一套行为描述去问,评价者只能凭模糊印象打分。
更严重的是管理层。对一位总监用"是否能按时完成分配任务"这种基层行为项去评价,本身就是错配。管理层需要的是"决策质量、资源争取、团队培养、跨部门影响"这类维度,且评价者应该以平级和上级为主,下属评价权重应下调。
5. 误区五:只考核不反馈,或反馈只给分数
这是最容易被忽略、但对系统寿命影响最大的一条。360的价值有70%在反馈环节,如果员工只能看到一个总分,那这次评估对他没有任何行为改变的作用。
我在客户那里推动的最低标准是:每位被评价者必须收到"三条具体行为描述+两条改进建议",且这些内容必须来自至少两个不同的评价者视角。做不到这一点的360,不如不做,它只会消耗组织的信任额度。
四、专业判断逻辑:什么样的多维度组合才真正"可评价"
讲完误区,需要给出一套可操作的判断框架。我在实践中用的是"三层维度+双门槛+一个校准"的结构,这套结构不依赖特定系统,但需要系统支持才能低成本运行。
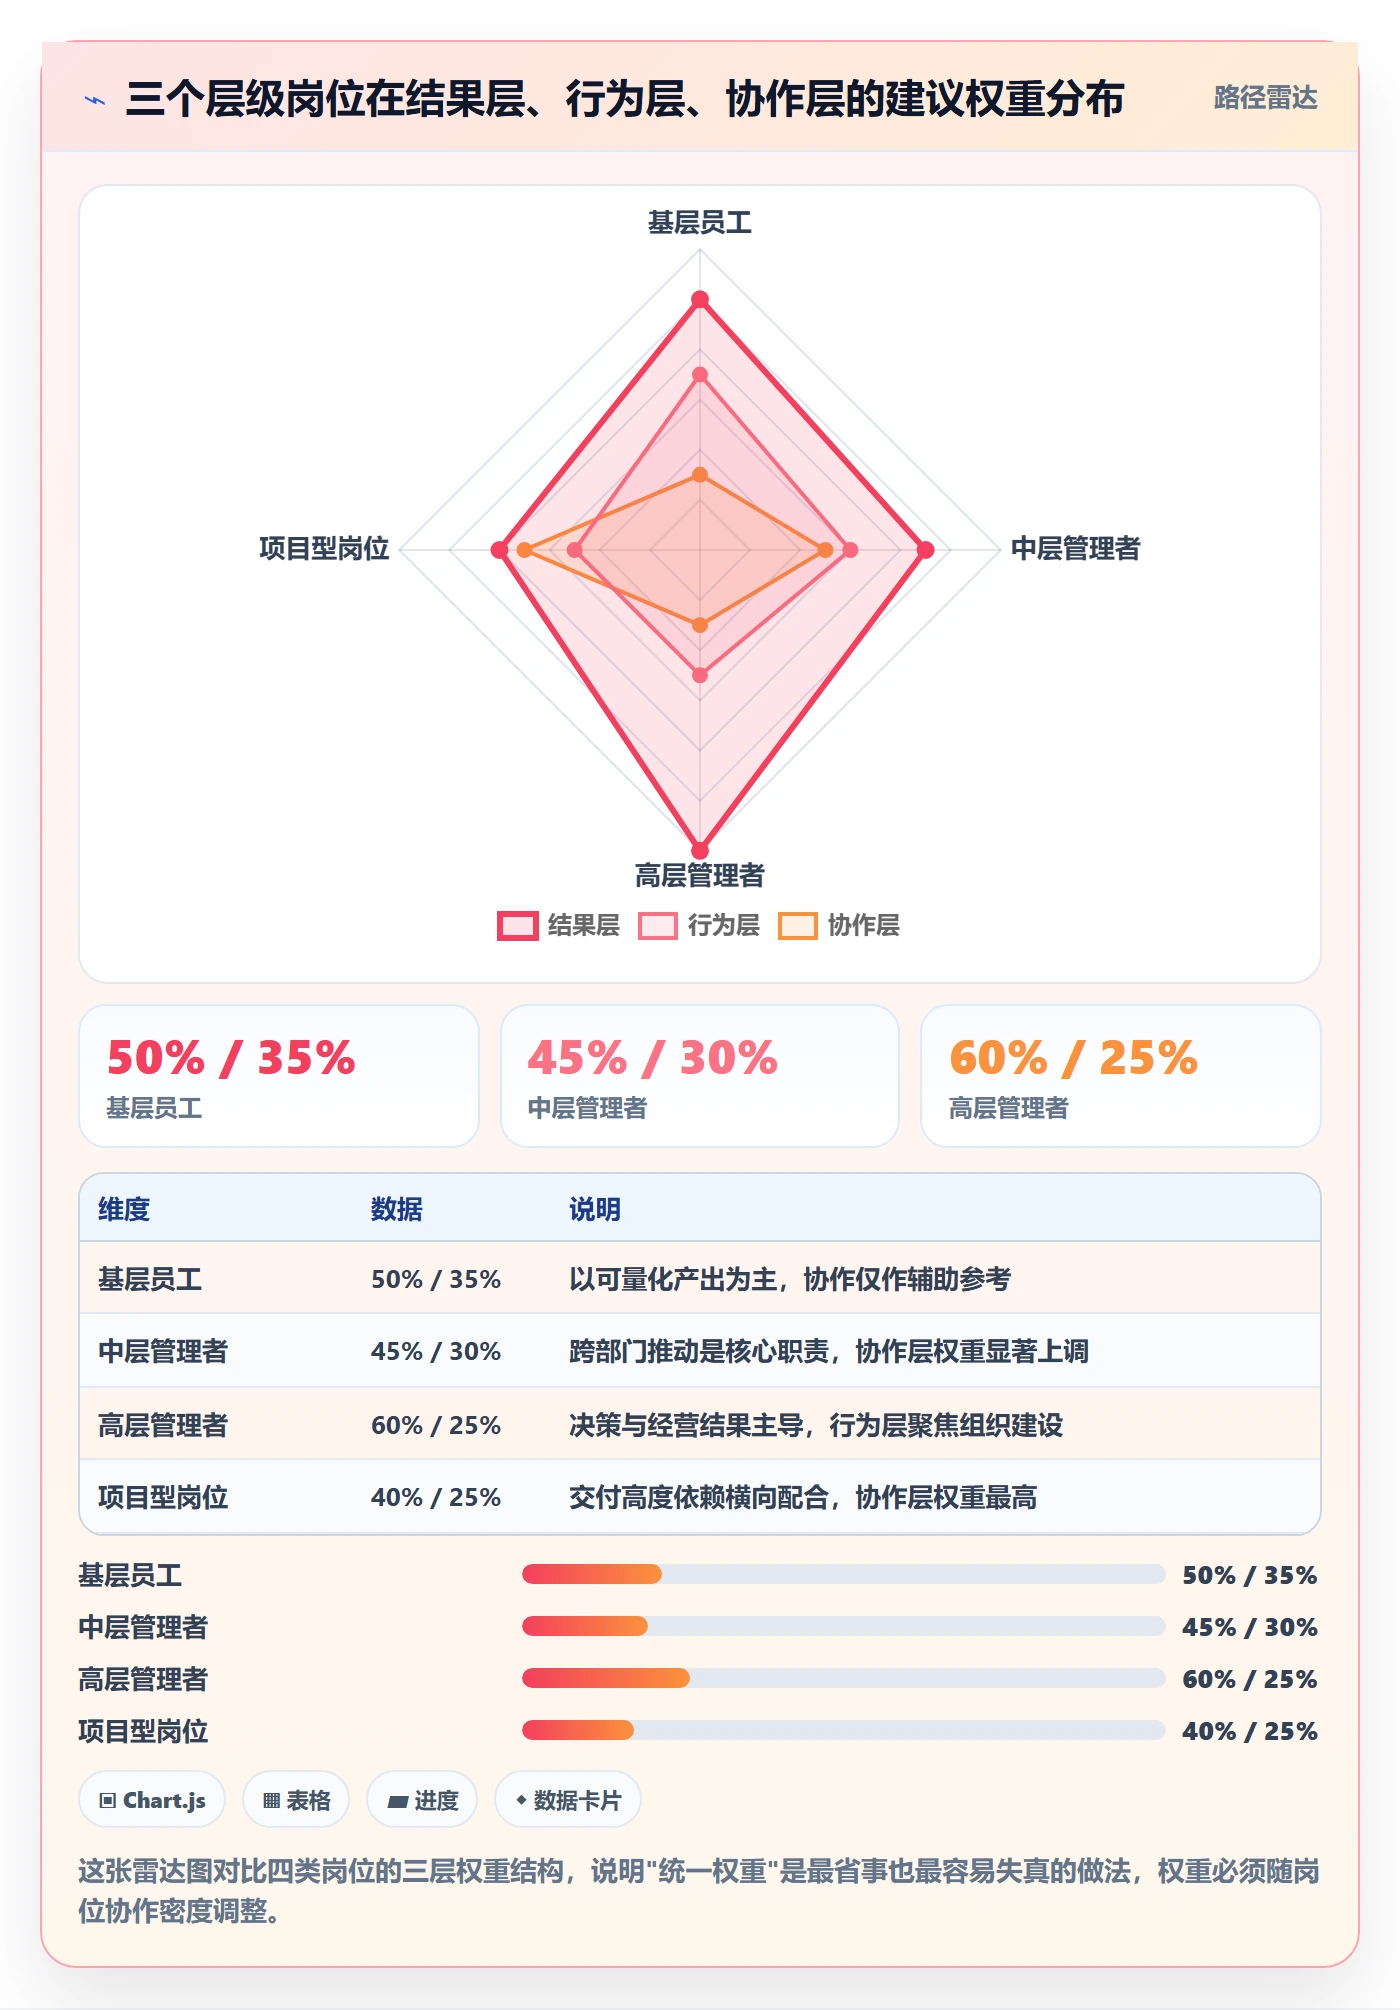
1. 三层维度模型:结果层、行为层、协作层各司其职
我把所有维度归到三层,每层的评价者、用途、权重逻辑都不同:
- 结果层:目标达成、交付质量、关键指标。评价者是直接上级,数据来源是业务系统,不通过问卷采集。
- 行为层:岗位关键行为、专业规范执行。评价者是直接上级+有充分协作的同事,通过结构化问卷采集。
- 协作层:跨部门配合、信息共享、冲突处理。评价者是固定的协作对象(不是随机抽取),通过轻量问卷采集。
这三层的权重不应平均。我的经验比例是:基层员工结果层50%、行为层35%、协作层15%;中层管理者结果层45%、行为层30%、协作层25%;高层结果层60%、行为层25%、协作层15%(高层的协作更多体现在决策和资源层面,已部分被结果层覆盖)。
2. 双门槛:可观测门槛与样本量门槛
可观测门槛:前面提过,一年至少6次具体事件。实操中可以简化为一个问题,"这位评价者能否说出被评价者最近三个月内的两个具体行为例子?"说不出来的,就不该进名单。
样本量门槛:单个被评价者的有效评价者不应少于4人、不宜多于10人。少于4人无法保护匿名,多于10人边际信息量急剧下降,且管理成本上升。对于管理者,8-12人是比较理想的区间。
3. 权重设计的反直觉经验:降低下属权重,提高固定协作方权重
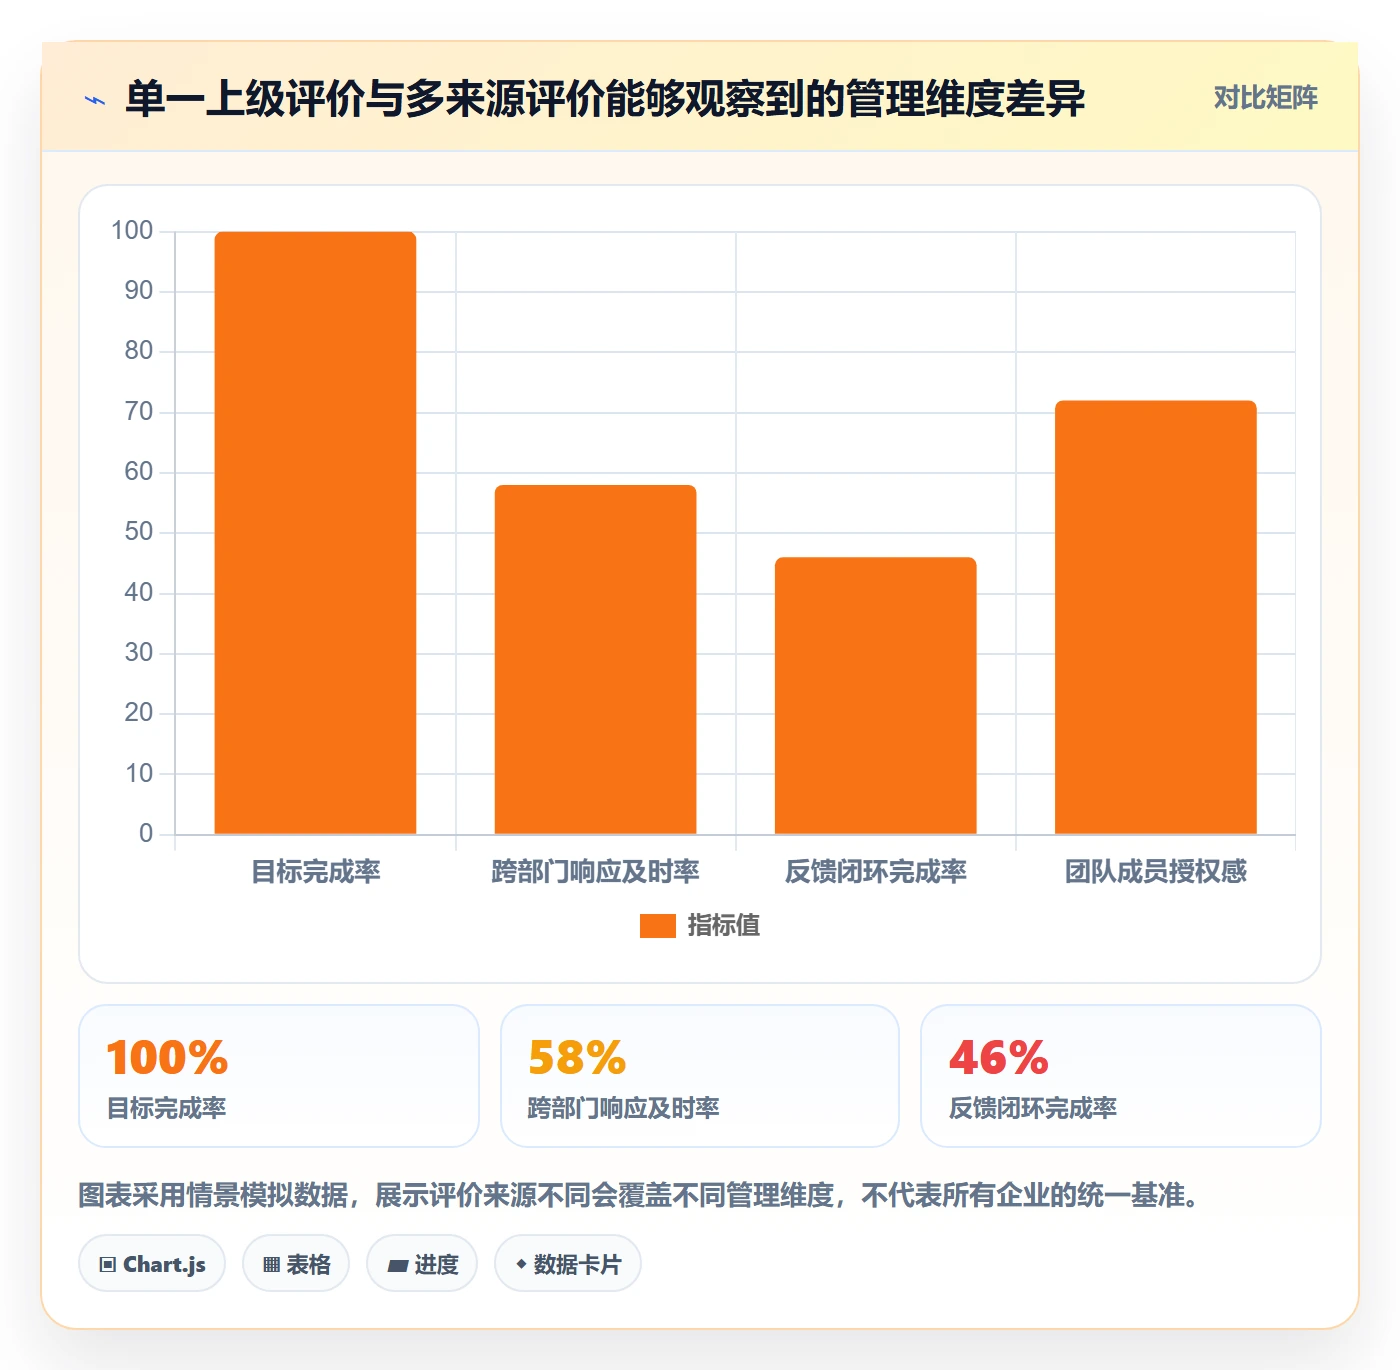
很多企业默认"下属评价最能反映管理水平",于是给到40%以上。但下属评价受排班、任务分配、日常摩擦影响极大,测量到的更多是"管理风格满意度"而非"管理有效性"。
我的建议是:下属评价权重控制在20%-25%,并且只问有限的行为项(是否有明确的目标、是否给予及时反馈、是否提供成长机会)。同时大幅提高"固定协作方"的权重,那些和被评价者每两周必然有工作交接的人,他们的观测样本最密集、最真实。
4. 一个校准:评估校准会不能省
纯数据汇总一定会产生偏差。校准会的作用是:把明显异常的分数(比如某位评价者给所有人都打2分)拿出来讨论,把定性描述里的关键信息提炼出来,把跨团队的评分尺度拉齐。
校准会不需要长,2小时、5-8人、聚焦争议最大的10%样本即可。但这一步省略了,前面所有设计的效果会打对折。
5. 三种360方案的适用边界对比
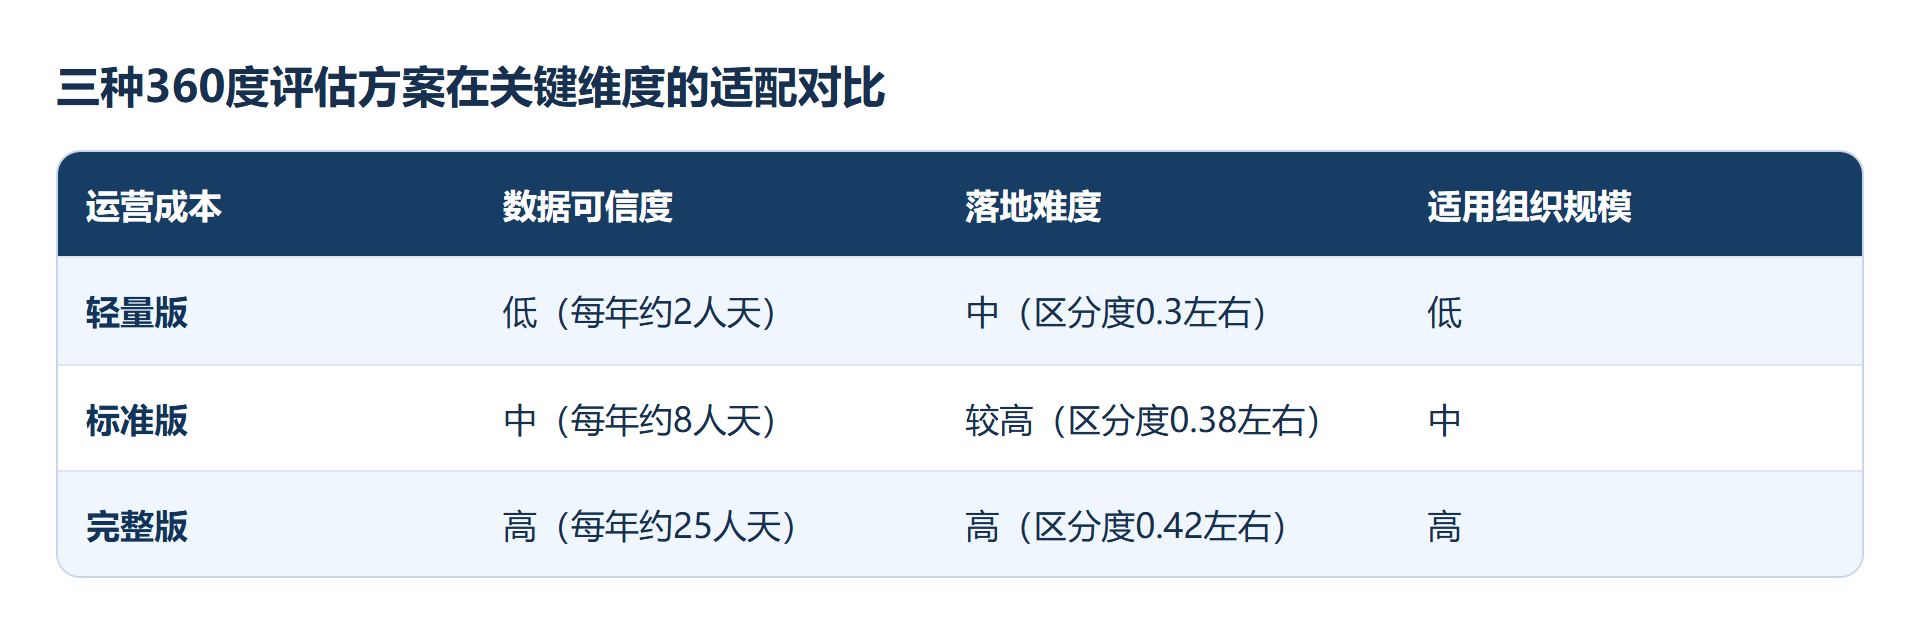
不是所有组织都需要完整的360。下面这张对比表,是我在给客户做方案选择时常用的判断依据:
| 方案类型 | 维度数量 | 评价者规模 | 结果用途 | 适用组织 | 主要风险 |
|---|---|---|---|---|---|
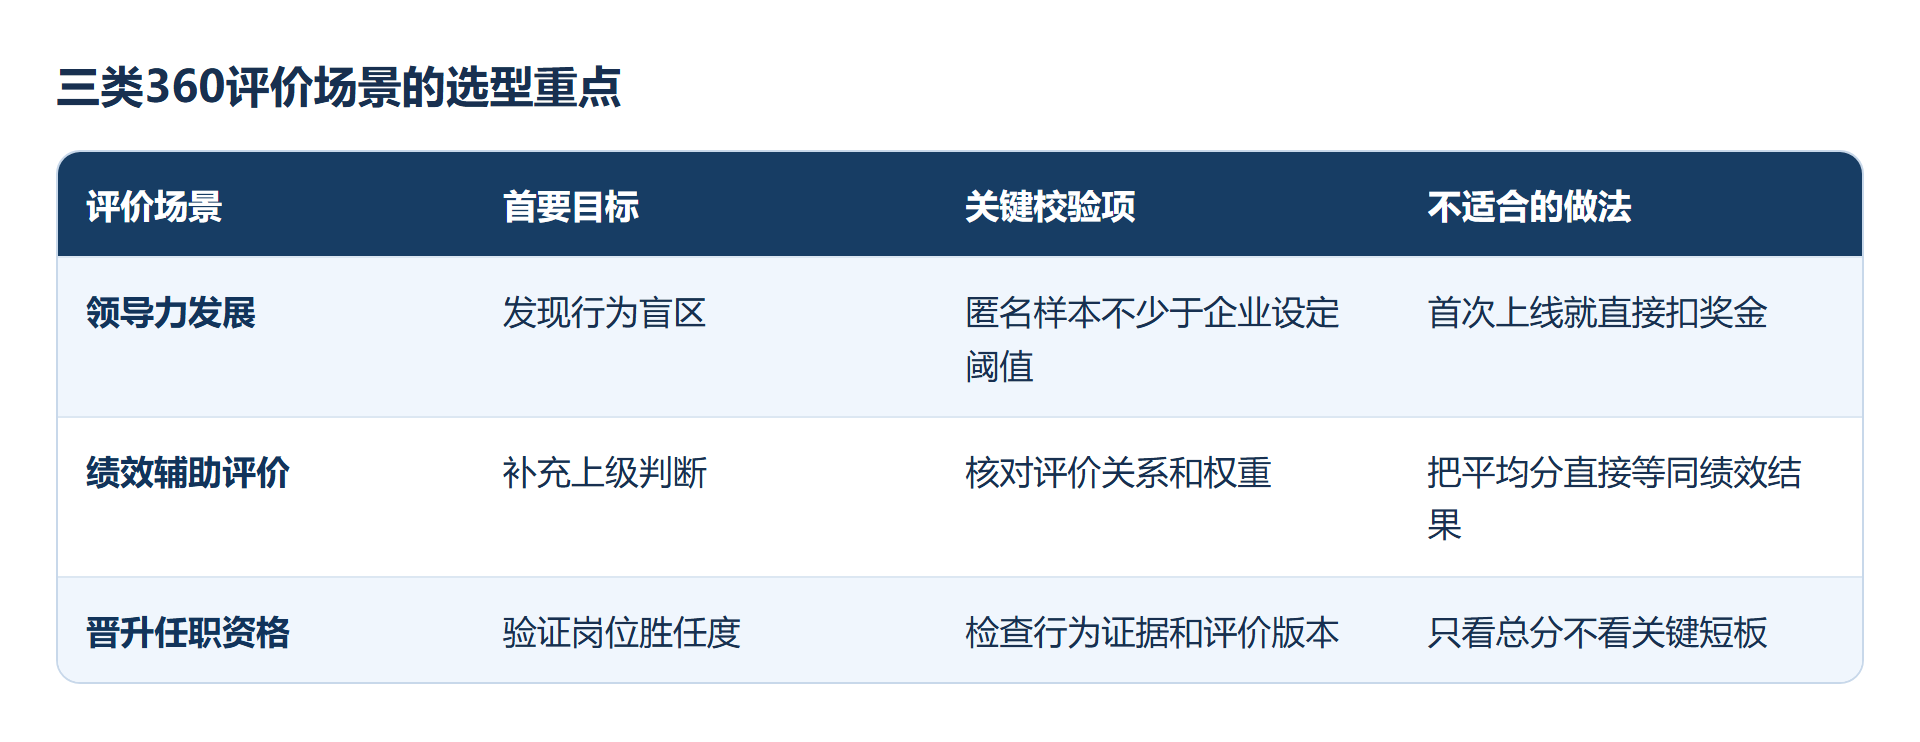
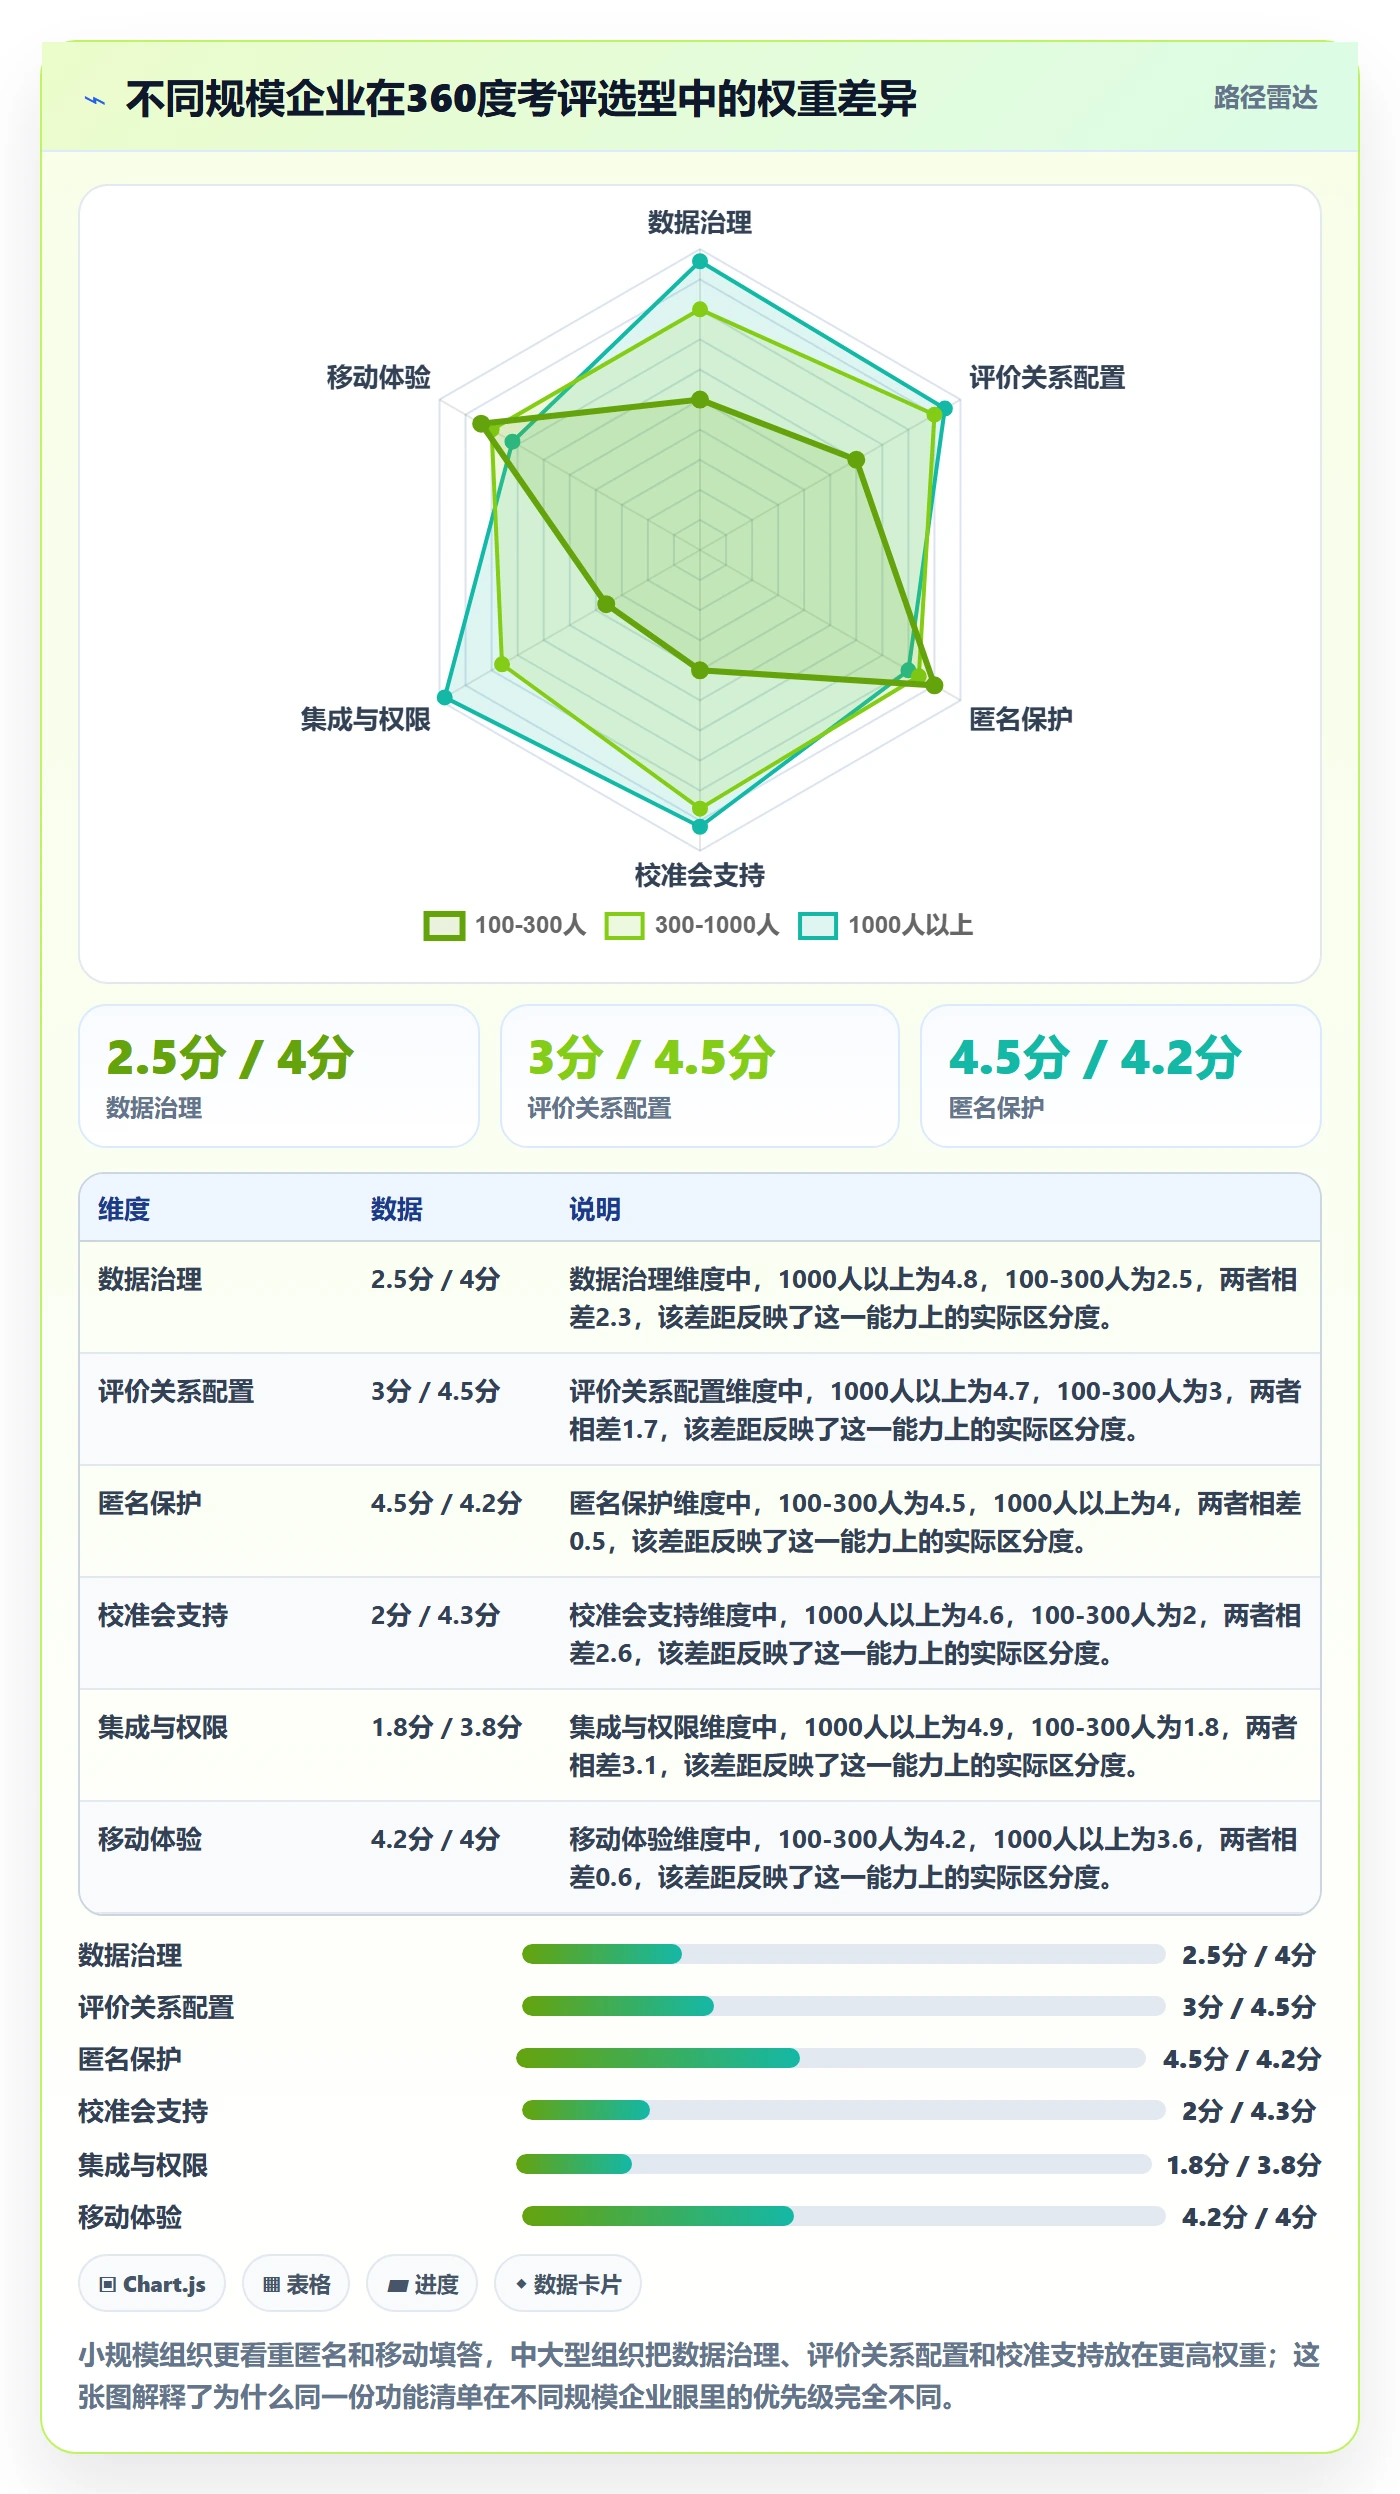
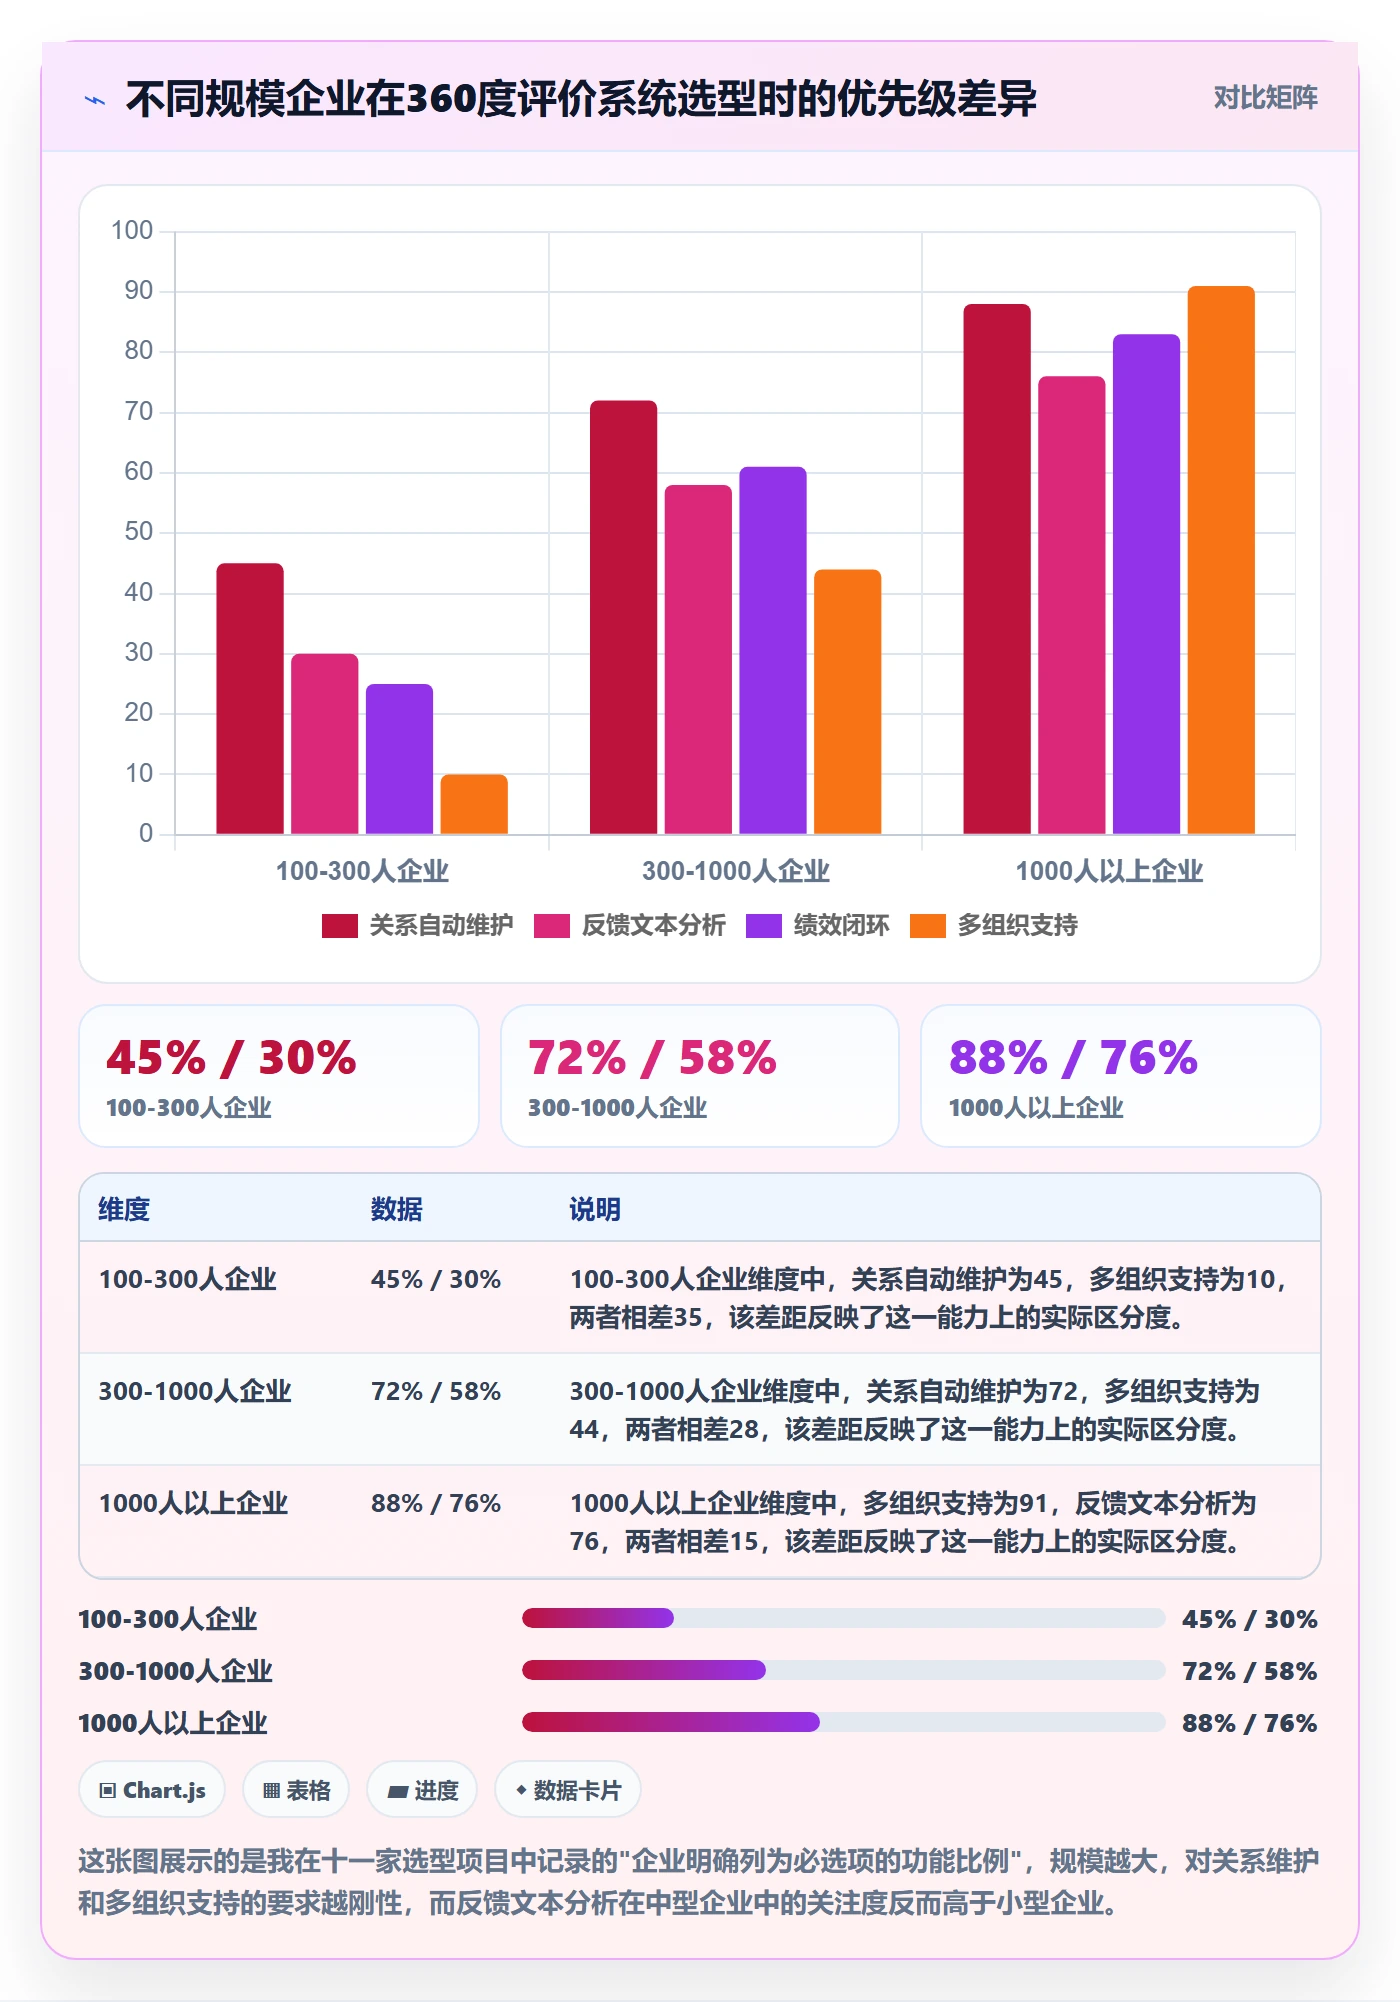
| 轻量版(发展导向) | 4-5个 | 4-6人 | 个人发展计划、培训选题 | 100-300人,管理基础较弱 | 缺乏后续跟踪则易流于形式 |
| 标准版(发展+校准) | 6-8个,分岗位 | 6-10人 | 发展计划+绩效校准输入 | 300-1000人,有专职HRBP | 校准会执行不到位则偏差累积 |
| 完整版(多用途) | 8-12个,分层分类 | 8-12人,含固定协作方 | 发展+晋升评议+干部盘点 | 1000人以上,有干部管理体系 | 运营成本高,需系统强支撑 |
五、案例与数据观察:一套多维评估系统落地时,真正决定成败的细节
框架讲完,落到执行。这一节我用一家客户的真实落地过程来说明,其中涉及的系统是利唐i人事,它主要服务中大型企业及100人以上组织,在多维评估的场景里,它的价值不在问卷本身,而在把评价关系、数据权限、结果流转这几件事结构化了。
1. 项目背景与约束条件
客户是一家做精密零部件的中型制造企业,约680人,7个事业部,一线员工占比58%。此前的360是一年一次、纸质问卷、HR手工汇总,从发起到出报告要47天,报告只有分数没有描述。
约束条件很明确:一线员工大量使用共享终端,不能要求人人装App;评价周期必须压缩到两周内;HR团队只有3人,不能增加太多人工;已有的考勤、排班、技能等级数据要能联动。
2. 系统配置里最关键的四个细节
整个实施过程大约6周,其中配置只占2周,剩下4周都在做评价关系梳理和沟通。这几个细节是我认为最值得复用的:
- 评价关系不按组织架构自动生成,而是导入"协作关系表"。这张表由各事业部负责人提供,列出每位被评价者过去半年实际有工作交接的5-8人。仅这一步,就把"无效评价者"的比例从预估的35%降到了9%。
- 按岗位序列配置不同问卷。一线生产岗用4维度(安全规范、质量意识、协作配合、技能提升),技术岗用6维度,管理岗用7维度。系统里维护了4套模板,而不是一套通用模板。
- 数据权限分层设置。被评价者只能看到汇总后的定性描述和改进建议,看不到任何单一来源的分数;直接上级能看到下属的各维度汇总分但不显示评价者;HR能看到完整数据但操作留痕。这个权限设计在启动会上公示,直接提升了填写意愿。
- 结果自动流转到个人发展计划。评估结束后,系统把每位员工得分最低的1-2个维度,自动生成待办事项,推给员工本人和直接上级,要求在30天内完成一次面谈并填写改进措施。这一步是让360"有用"的关键。
3. 上线前后的数据变化
下面是这个项目上线前后两轮评估的关键指标对比。需要说明的是,这些数据来自项目组的内部统计,样本为该企业全体被评估员工(约620人),统计口径统一:
| 指标 | 上线前(纸质轮次) | 上线后第1轮 | 上线后第2轮 |
|---|---|---|---|
| 评估周期(从发起到出报告) | 47天 | 11天 | 9天 |
| 评估完成率 | 71% | 89% | 93% |
| 平均填写时长 | 无法统计 | 9.4分钟 | 11.2分钟 |
| 评分标准差 | 0.22 | 0.34 | 0.41 |
| 负面评价(3分及以下)占比 | 6.8% | 14.2% | 18.7% |
| 收到具体行为描述的员工占比 | 0% | 82% | 96% |
| 30天内完成改进面谈的比例 | , | 64% | 88% |
| HR汇总与统计耗时 | 约36小时/轮 | 约4小时/轮 | 约3小时/轮 |
4. 踩过的三个坑
第一个坑:第一轮问卷发得太急。为了赶在季度末完成,从通知到截止只给了5个工作日,结果一线班组集中在前两天填完,大量连续同选项。第二轮把窗口拉到10个工作日,并在第4天发一次提醒,填写质量明显改善。
第二个坑:定性描述字段设置成了必填,但没有给引导。第一轮收到大量"希望继续努力""表现良好"这类无效描述。第二轮在输入框上方加了三行提示和两个示例句式("在XX项目中,他……"),有效描述率从31%升到74%。
第三个坑:管理层没有参与校准会。第一轮出报告后直接下发,结果有三个事业部对结果提出异议,认为评分尺度不一致。第二轮增加了半天校准会,由各事业部负责人一起过一遍争议样本,异议基本消失。校准会的真正价值不是修正分数,而是让管理者对"什么叫好"达成共识。
5. 从启动到稳定运行,七个必须完成的动作
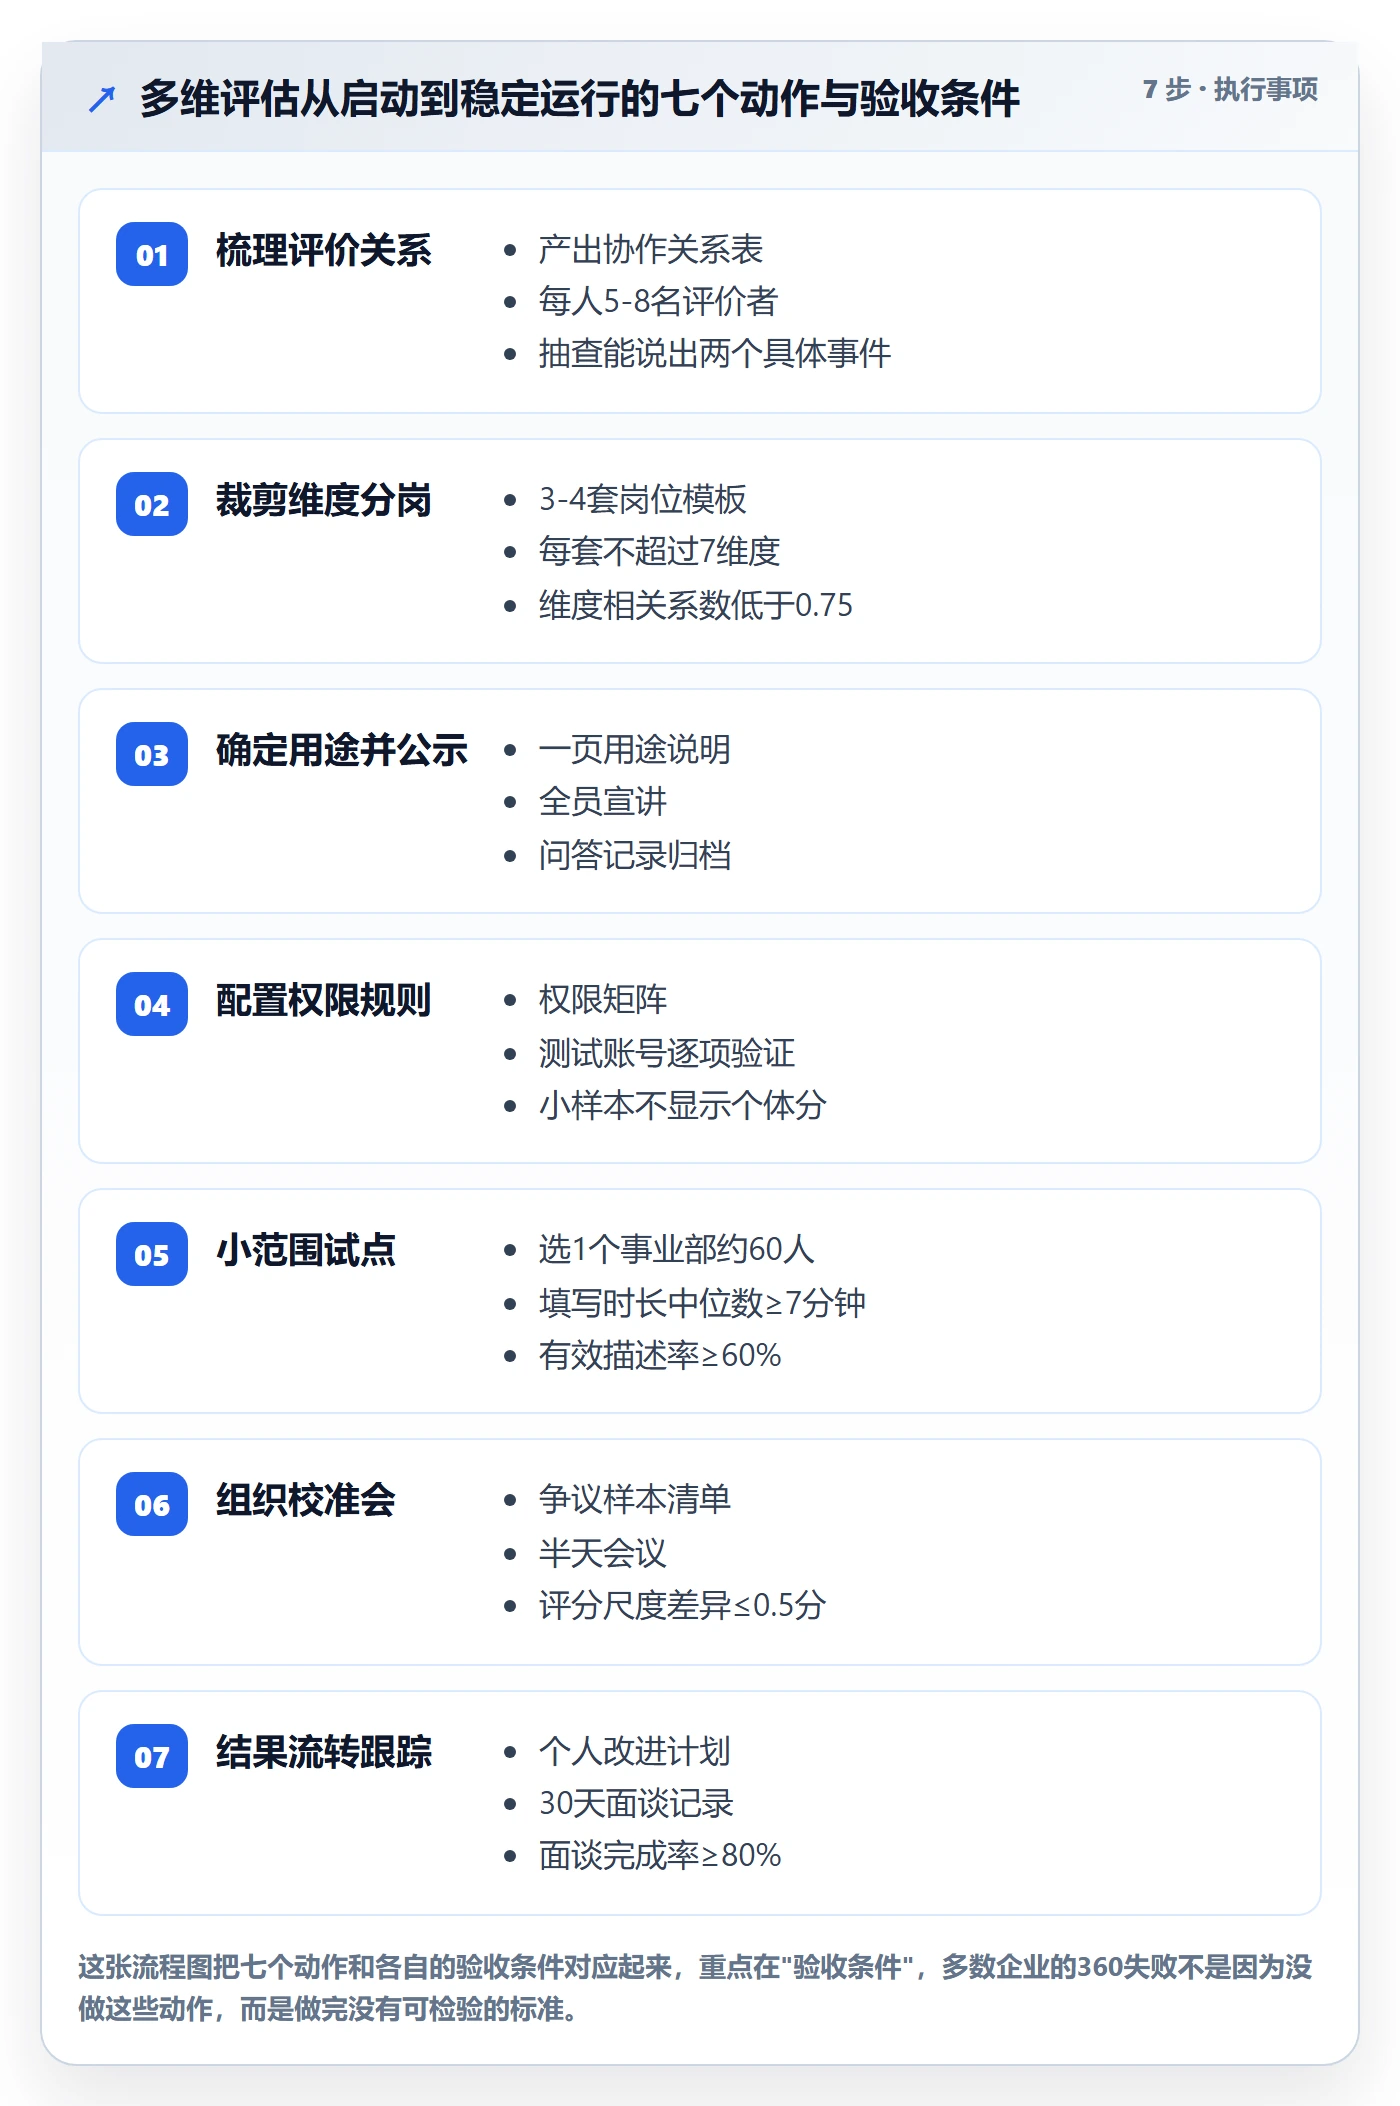
把这套经验压缩成可复用的步骤,大致是这样七个动作,每个动作都有明确的交付物:
- 梳理评价关系:产出"协作关系表",每人5-8名评价者,标注协作频次。验收条件:随机抽10人,其评价者都能说出被评价者的两个具体事件。
- 裁剪维度并分岗:产出3-4套岗位问卷模板,每套不超过7个维度。验收条件:维度间历史相关系数均低于0.75。
- 确定结果用途并公示:产出一页说明,明确谁能看到什么、结果用在哪里、不用在哪里。验收条件:全员大会宣讲完成,问答记录归档。
- 配置权限与匿名规则:产出权限矩阵。验收条件:用测试账号逐项验证,小样本(少于5人)不显示个体分数。
- 小范围试点:选1个事业部、约60人跑一轮。验收条件:填写时长中位数不低于7分钟,有效描述率高于60%。
- 组织校准会:产出争议样本清单和校准结论。验收条件:各团队评分尺度差异收敛到0.5分以内。
- 结果流转与跟踪:产出个人改进计划和30天面谈记录。验收条件:面谈完成率高于80%,改进措施可核查。
六、不同情况下的行动建议
框架和案例都有了,但每家企业的基础不同。下面按组织规模和成熟度分档给出建议,这些建议是我在实际项目中反复调整后的版本,不是教科书结论。
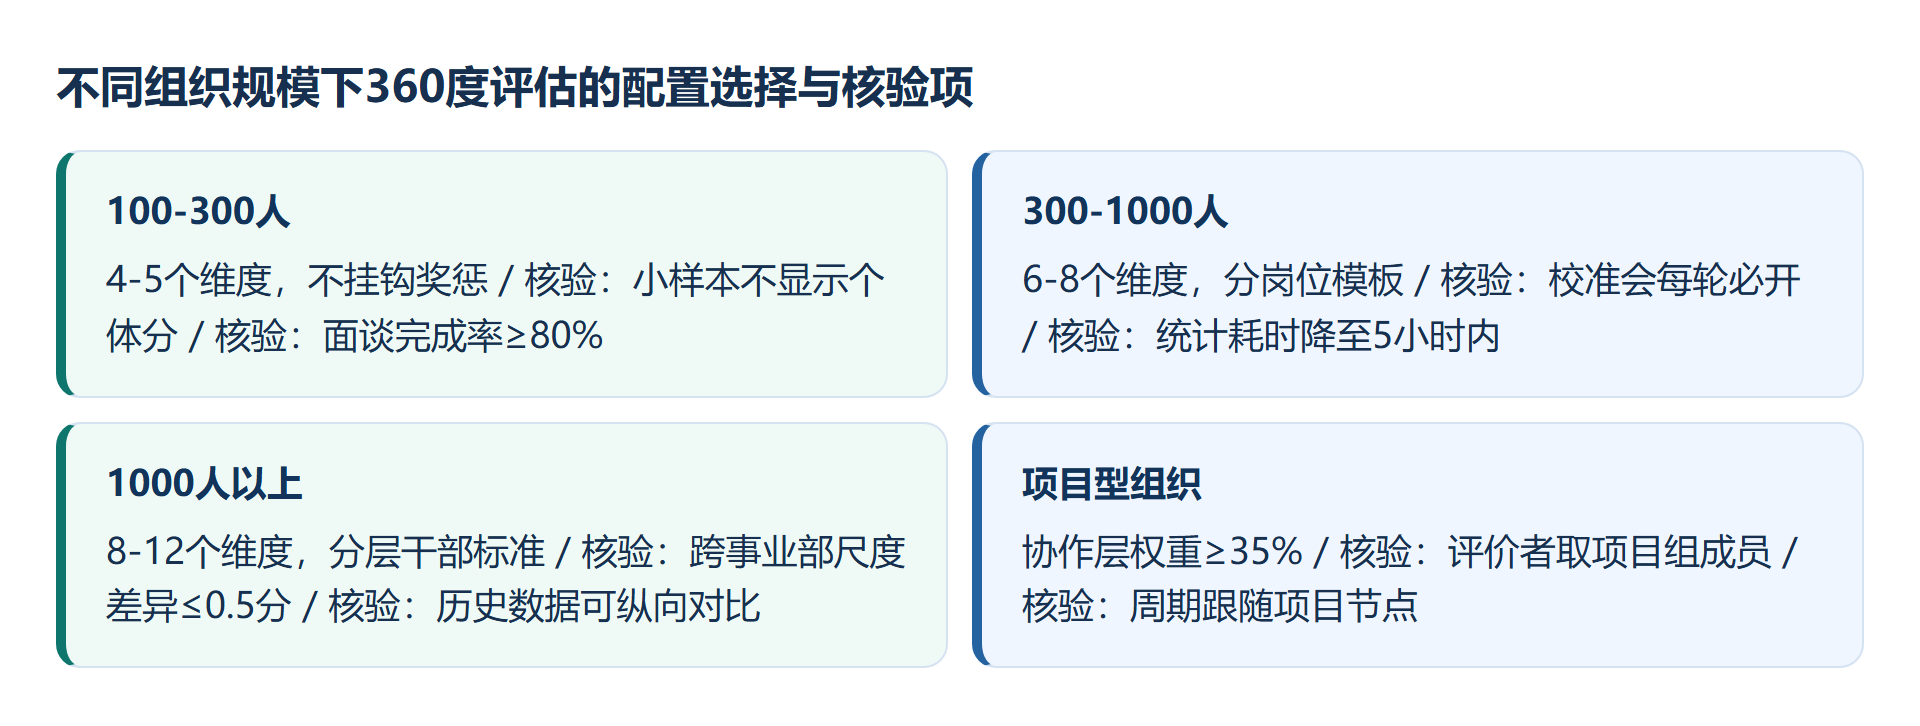
1. 100-300人:先做"轻量版",把反馈闭环跑通
这个规模的企业,最大的风险是"设计过度"。人少,评价关系相对透明,匿名保护本身就弱,复杂的多维度设计反而会放大猜疑。
建议只做4-5个维度,评价者控制在4-6人,结果明确不挂钩任何奖惩,只用于个人发展和培训选题。重点投入在反馈环节:每位员工必须拿到至少两条具体行为描述,并在两周内完成一次面谈。
系统层面不需要复杂配置,但要确保两件事:小样本下不显示个体分数、结果能自动生成待办推给本人和上级。如果连这个都做不到,用结构化表格也能跑,只是统计耗时会长一些。
2. 300-1000人:上"标准版",重点在评价关系和校准
这个规模是360最容易出效果的区间,也是最容易形式化的区间。人多到需要系统支撑,但还没多到需要复杂的干部管理体系。
建议6-8个维度、分3-4套岗位模板,评价者6-10人且必须包含固定协作方。结果作为绩效校准会的输入,不做机械加权。每轮必须开校准会,聚焦争议最大的10%样本。
这个规模的企业通常会引入HR系统来承载流程。以利唐i人事为例,它在这个规模段比较实用的地方是:评价关系可以批量导入而非依赖组织架构自动生成;不同岗位序列能维护独立问卷模板;结果可以配置成自动流转到个人发展计划并生成跟踪待办。这些能力本身不新鲜,但组合起来能省掉大量手工汇总,前述案例里HR每轮统计耗时从36小时降到3-4小时,主要就来自这里。
3. 1000人以上:可以做"完整版",但必须先有干部标准
千人以上企业往往有多条业务线、多层级,360常被用于干部盘点和晋升评议。这时候最大的风险不是流程,而是标准不统一,各事业部对"什么是好的管理者"理解不同,评出来的分数无法横向比较。
建议先建立分层级的干部标准(哪怕只是行为锚定描述),再配置问卷。维度可以到8-12个,但必须分层:基层重执行与协作,中层重跨部门推动与团队培养,高层重决策质量与组织建设。评价者8-12人,固定协作方权重不低于30%。
这个阶段还需要考虑数据治理:多轮评估的历史数据要能纵向对比,否则无法判断一个人是否真的在改进。这一点在选型时容易被忽略,但用到第三年就会变成刚需。
4. 特殊场景:项目型组织与销售团队
项目型组织的协作层权重应显著提高(可到35%),评价者应直接取项目组成员,评估周期跟随项目节点而非年度。销售团队则要慎用360,业绩数据本身已经足够强,360更适合用来评估"客户经营质量"和"团队带教",而不是重复考核业绩。
七、不同情况下的取舍:四个必须做选择的地方
任何方案都有代价。这一节我把四个最常被问到、也最容易摇摆的取舍摆出来,给出我的判断和适用边界。
1. 匿名还是实名:取决于评价者数量和信息用途
评价者少于5人时,匿名是伪命题,不如改为"不展示个体分数、只展示汇总描述",同时对评价者身份做小范围保护。评价者多于8人时,可以做到实质匿名,此时应坚持匿名以鼓励真实反馈。
如果结果只用于发展,匿名的必要性下降,甚至可以设计"署名反馈+可选择性公开",反而更能促进深度沟通。如果结果涉及晋升评议,匿名必须严格保护,否则评价者会承担不必要的社交风险。
2. 挂钩薪酬还是只做发展:先看管理成熟度
管理成熟度高(有清晰的目标管理、有定期的绩效沟通、主管具备反馈能力)的组织,可以谨慎地把360作为绩效校准的参考输入;管理成熟度低的组织,挂钩几乎必然导致分数失真。
判断标准很简单:问自己一个问题,如果360结果显示某位高绩效员工的协作维度得分很低,管理层会不会真的据此调整对他的判断?如果答案是"不会,还是看业绩",那就不该挂钩,因为挂钩只会让数据变假,而不改变决策。
3. 上系统还是用表格:看轮次频率和数据复用需求
一年只做一次、人数少于200人、结果不做纵向对比的,用结构化表格完全可行,成本更低。一旦出现以下任一情况,就应该考虑系统:一年两轮以上、人数超过300、需要按岗位配置多套问卷、需要结果自动流转到改进计划、需要历史数据纵向对比。
选型时我建议重点验证三件事而不是看功能清单:评价关系能否批量导入并人工调整;权限颗粒度能否做到"不同角色看到不同层级的数据";结果能否自动生成可跟踪的待办而非只出一份报告。这三点决定了系统是"省事"还是"多一道手续"。
4. 一年一次还是一次多次:频率与观测窗口的匹配
360的观测窗口应与业务节奏匹配。年度评估适合管理层和职能岗;项目型岗位适合项目结束即评;一线生产岗如果一年只评一次,评价者根本记不住具体事件,建议改为半年度,且只评3-4个核心行为项。
但频率不能无限提高。超过每季度一次,评价者会产生明显的评估疲劳,数据质量断崖式下降。我的经验是:同一批评价者,一年参与360的次数不宜超过2次。
| 取舍点 | 选择A | 选择B | 判断依据 |
|---|---|---|---|
| 匿名性 | 完全匿名 | 不展示个体分数+汇总描述 | 评价者是否≥5人;结果是否涉及晋升 |
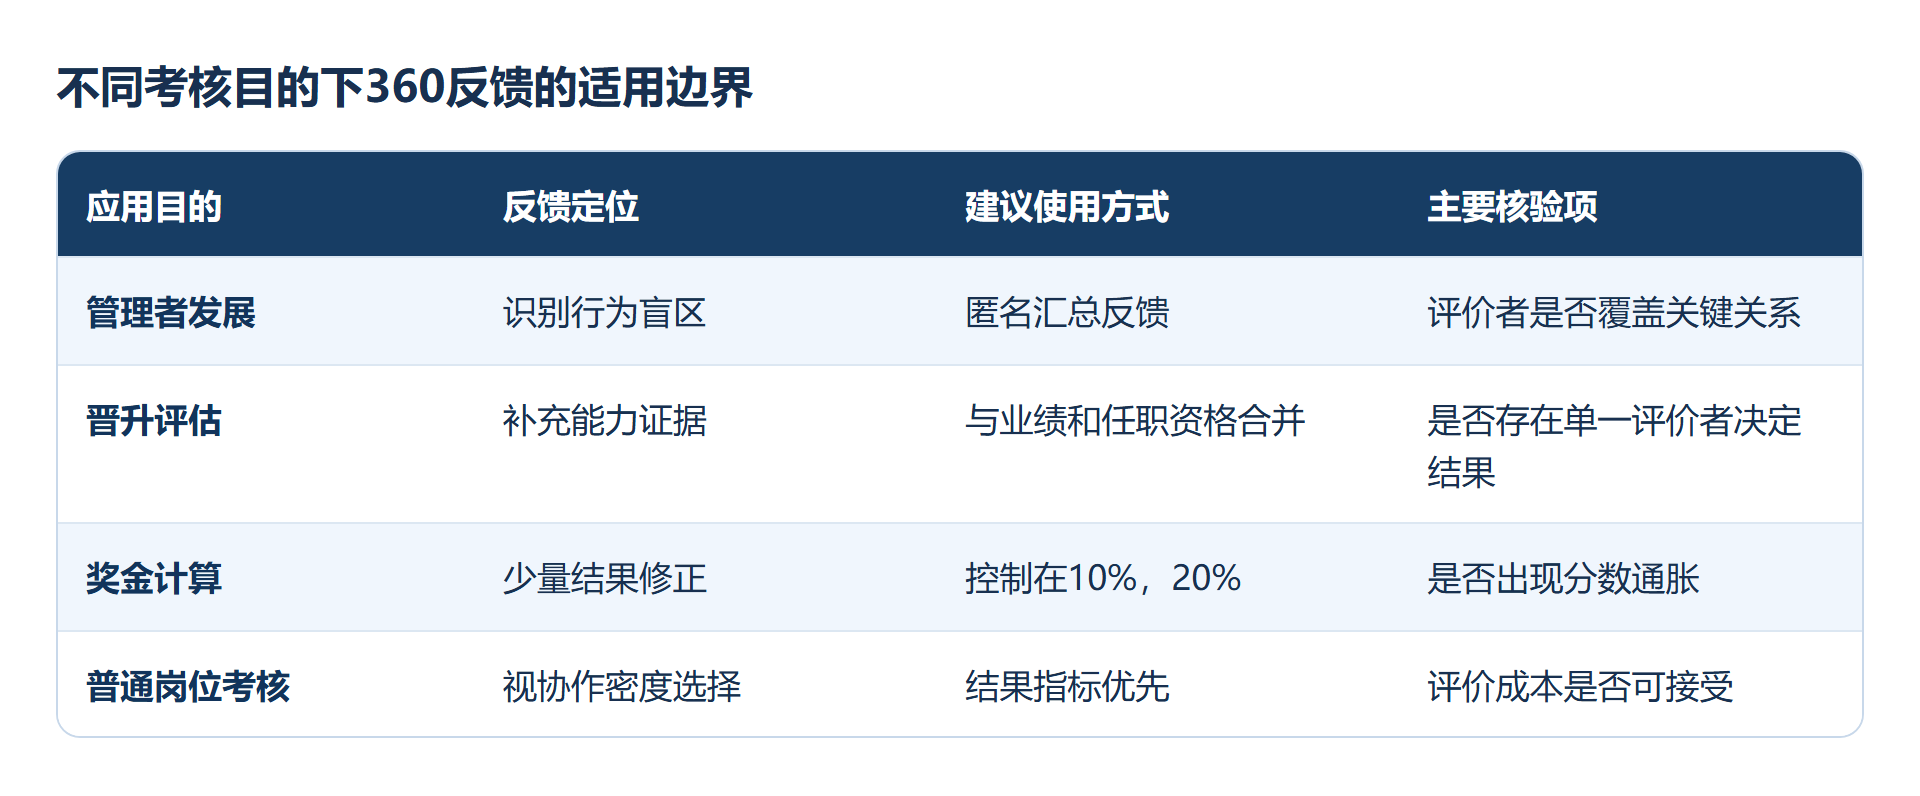
| 结果用途 | 仅发展 | 绩效校准输入 | 管理层是否会依据结果调整判断 |
| 承载方式 | 结构化表格 | 专业系统 | 轮次频率、人数、是否需要纵向对比 |
| 评估频率 | 年度一次 | 半年度或按项目 | 岗位观测窗口长短;评价者疲劳度 |
八、总结:让多维度评估"有用",比让它"完整"重要得多
回到开头那家工业自动化企业。他们后来做的事情其实很简单:把42题砍到6题,把自动生成的评价者名单换成手工梳理的协作关系表,把360从奖金计算里摘出来,改成只生成个人改进计划并要求30天内面谈。半年后第二轮数据,评分标准差从0.09回到0.37,负面评价占比从3%升到17%,同时项目交付准时率从63%升到71%。
这两个数字之间没有直接的因果关系,但它们同时出现不是巧合,当组织开始允许说真话,问题才会被摆到桌面上,然后才可能被解决。形式主义的本质不是流程走样,而是组织失去了获取真实信息的能力。
所以我的核心判断是:多维度评估的价值不在"维度多",而在"每个维度都有人真的看得见、每个分数都有人真的会用"。做360之前,先问三个问题:这些维度,评价者一年能观测到几次?这些分数,谁会拿它做什么决定?这些反馈,被评价者多久能看到、看到后做什么?三个问题有一个答不上来,就先别急着上线。
下一步,如果你正准备启动或改造360,我建议按这个顺序动手:先用一周时间梳理协作关系表(这一步收益最大、成本最低),再用一周裁剪维度并分岗,然后选一个60人左右的事业部跑一轮试点,用"填写时长中位数是否超过7分钟、有效描述率是否超过60%"这两个指标判断能不能推广。至于系统,等你确认这套流程真的能跑通,再考虑用工具把它固化下来,顺序反了,工具只会让错误的设计跑得更快。
常见问题解答(FAQ)
1. 360度评估的打分总是集中在4分以上,怎么设计才能让多维度评估分出差异?
我们公司去年上线了360评估,回收率挺高,但一看分数全在4分以上,部门之间几乎没差别,我怀疑这套东西根本分不出人。是不是该上强制分布或者末位淘汰?可我又担心一动就伤士气,到底该怎么调?
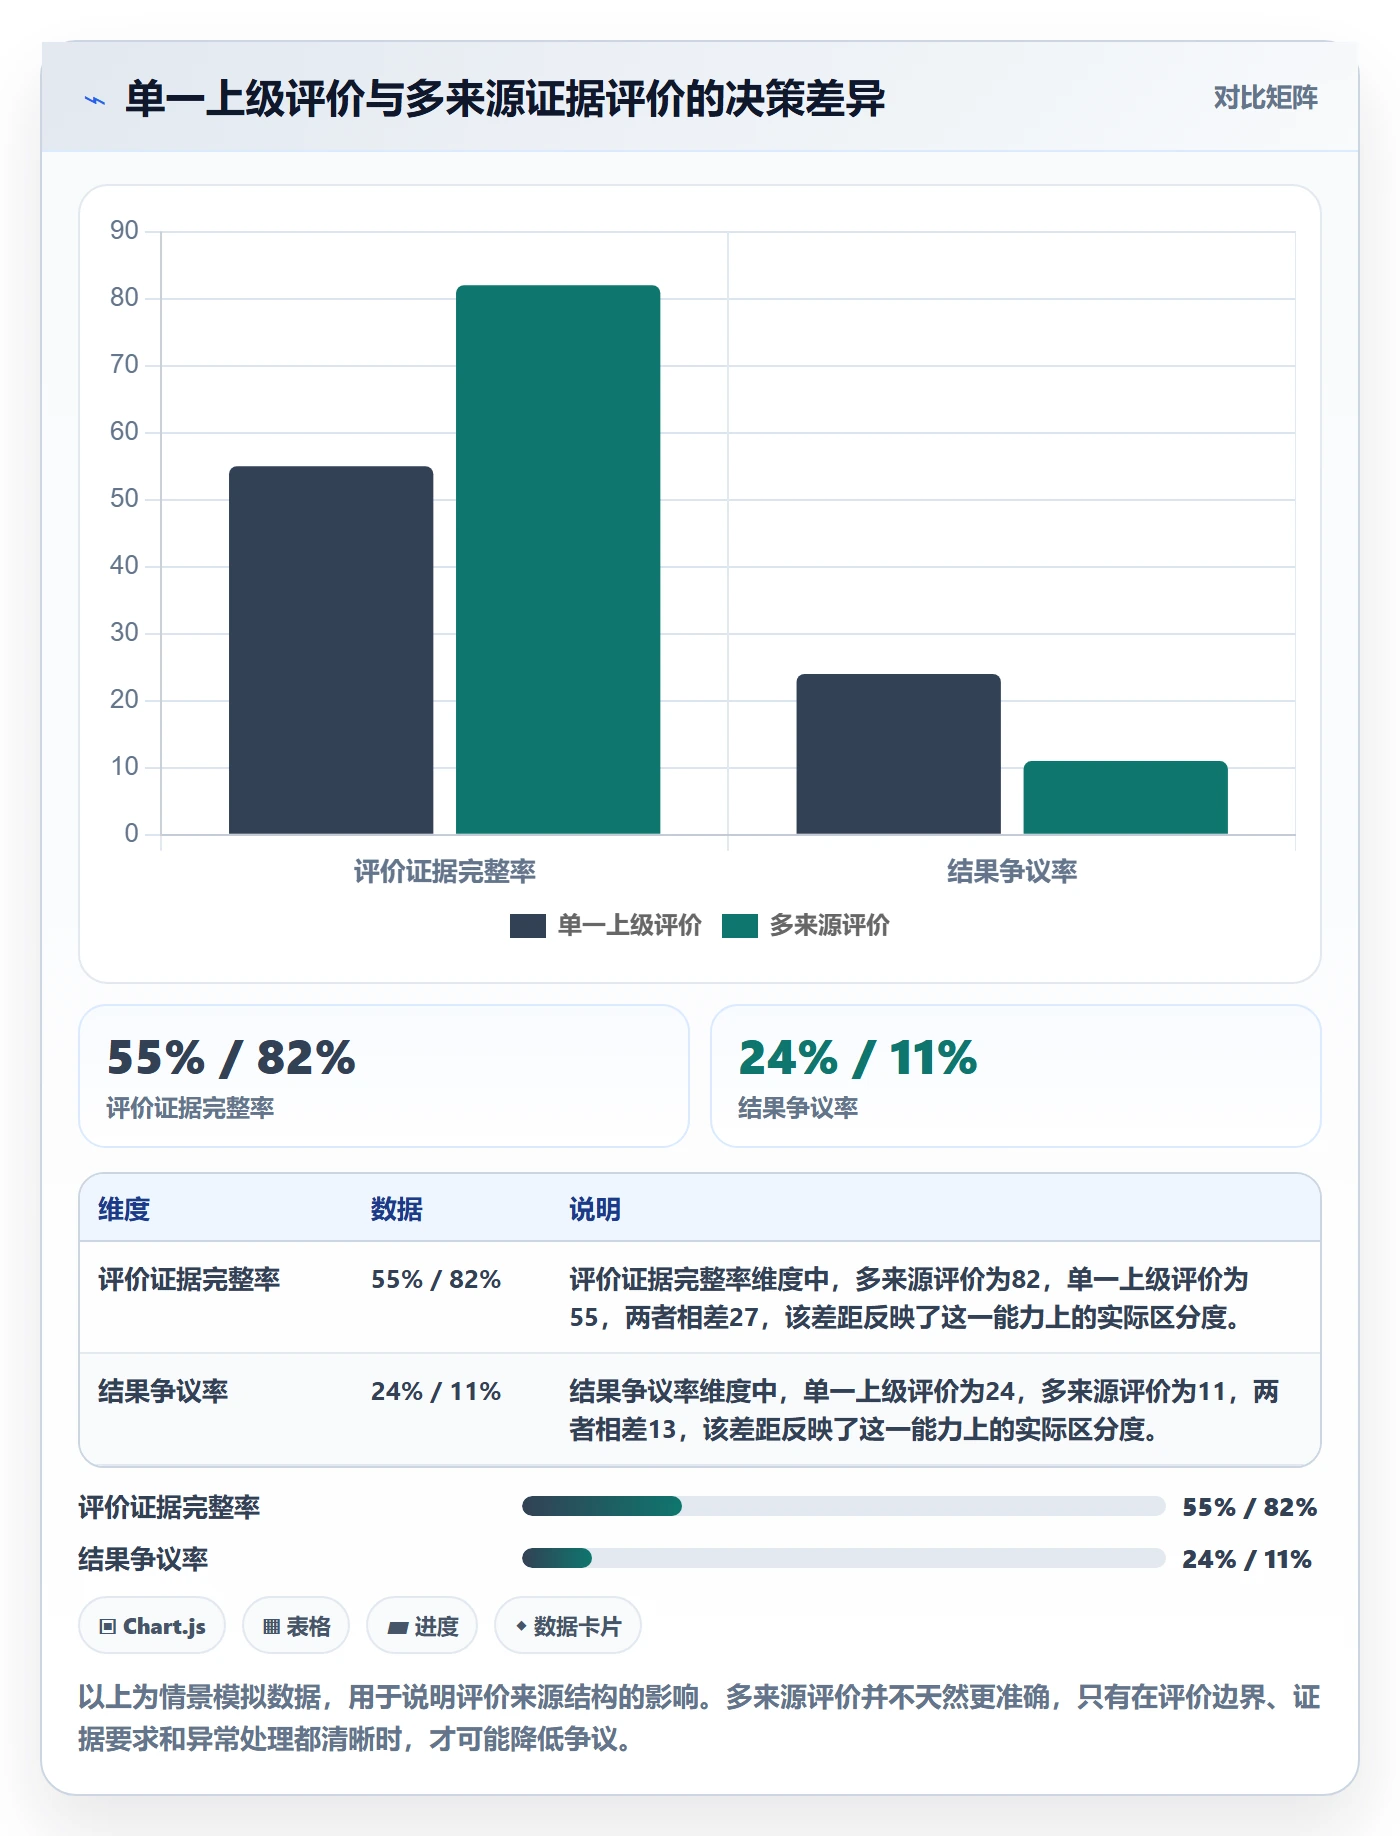
先说结论:绝大多数360评估分不出人,真正的原因在于量表没给评价者判断依据,而非员工不敢说真话。我们第一版用“非常同意,非常不同意”的五点李克特量表,设了12个维度,一轮覆盖128人,回收率96%。
数据拉出来我印象很深:82%的评分落在4分和5分,全公司标准差只有0.31,360总分和直属上级评分的相关系数高达0.87。最后这个数字才最致命,如果360和主管打分几乎一样,说明它没有提供任何增量信息,纯粹是让大家多填了一张表。我们改了三件事。
第一,把12个维度砍到7个,每一项写行为锚定,比如“跨部门协作”3分是“能在约定时间内给出对方需要的输入,偶有延迟但会提前告知”,5分是“主动识别对方未说出的依赖并提前对齐”。评价者不再判断“他好不好”,而是判断“他落在哪一档”。第二,把“未观察到/不确定”设成独立选项,且不计入强制打分。
这条最容易被忽略,我们加上之后,无效评分(全选中间档)从9%降到2%。第三,要求每项至少一条事实举证,写清楚时间、场景、行为。改完同一批人再评一次,标准差从0.31升到0.68,360与主管评分的相关系数从0.87降到0.62。
我不认为相关系数低是坏事,那0.25的差值就是360真正买到的东西,平级和下属看到、而主管看不到的那部分行为。至于强制分布,我明确不建议。我们曾在一个8人小组试过一个季度,结果出现轮流坐庄,第二轮评估时两名骨干互评直接打1分,最后花了两个月修复关系。360是观察工具,不是分配工具;
一旦要求评价者“必须分出优劣”,他就会去分配名额而不是描述事实。想拉开差距,靠行为锚定和举证,不靠强制排名。
2. 360评估的评语全是“工作认真负责”这类套话,怎么设计才能让评语有信息量?
我们收上来的评语几乎都是“认真负责、沟通良好、希望继续保持”,看完了对被评者还是没有任何新认识。我怀疑是不是该强制要求字数或者匿名,可又怕员工更敷衍。到底哪一步出了问题?
我们第一轮360,128人,回收率97%,看起来非常成功。但我让HR把评语导出来做了个统计:能同时包含具体场景、具体行为、具体影响三条的评语只占31%,出现频率最高的词是“认真负责”“沟通良好”“希望继续保持”。问题并不在于员工偷懒;
对评价者来说,这件事只有成本没有收益,他不知道评语给谁看、会不会被认出来、写了到底有没有用。我们做了四件事,有效评语率从31%拉到74%。第一,把评语框拆成三格:一个具体场景(哪个项目、哪次协作、大概什么时间),我观察到的行为,对结果或对我的影响。
给出正例和反例对照,正例是“3月版本上线前两小时发现接口字段不一致,主动拉了三个组对齐,最后没延期”,反例就是“工作认真负责”。第二,在系统里把评语和事实挂钩,评价人先从自己与被评者共同参与的项目或任务里选一条,再写观察。
这一步效果最大,因为人一旦面对具体项目,记忆就被激活了,写出来的东西自然具体。第三,设置最低校验:评语少于40字或没有关联事实的,提交时提示补充,但不强制阻断。第四,HR每轮抽10%的评语做质量分级,把高质量评语匿名化后在内部公示。
关于匿名,我们的规则是:对被评者匿名,对系统留痕,并明确写进评估须知,只有在申诉核查和恶意评价调查时才会调取,且会提前告知双方。这条写清楚之后,恶意评价投诉从每轮5到7起降到1起。反过来,如果完全不可追溯,就会出现借评估泄私愤的情况,我们第一年就遇到过一条毫无事实依据的差评,被评者情绪崩了两周。
还有一点我不建议做:不要让AI替评价者生成评语。我们试过给评价人一个“帮我润色”的按钮,结果大量出现“该同学展现了卓越的跨部门协同能力”这类正确但无信息的句子,有效评语率反而掉了。AI能做的是把他口语化的三句话整理通顺,不能替他产生观察,观察是评价者唯一真正的贡献。
3. 360度考核结果要不要和绩效奖金、晋升挂钩?权重设多少才不会变成形式主义?
我们老板一直想把360结果按30%权重算进季度绩效,说这样大家才会重视。我总觉得一旦跟钱挂钩,打分就全是人情了。到底该不该挂?如果挂,权重多少是安全的?
这个问题我们是用两年时间和一次失败换来的答案:尽量不要挂;如果一定要挂,权重别超过15%,而且只挂行为项不挂总分。第一年我们把360结果按30%权重并入季度绩效。第二年数据出来,全公司平均分从4.02涨到4.58,标准差从0.55缩到0.29。
表面上大家表现都变好了,实际上是评价者知道这个分数会影响同事的钱,人情压力压过了评价意愿。更麻烦的是这个过程不可逆,分数一旦变成钱,你再想让它回到“说真话”的状态几乎做不到,因为所有人都会记得上一次打分带来了什么后果。后来我们把360拆成两种用途。
一种是发展性360:不设权重、不进薪酬、结果只给被评者和直属上级,用于反馈面谈和个人发展计划。另一种是评价性360:权重10%到15%,只用于判断“这个人是否具备某项关键行为”,比如是否能在跨部门冲突中主动推动,输出是“具备/待观察”的资格结论,而不是一个可以排名的分数。
晋升评审时我们只把360的行为证据作为材料之一提交给评审委员,由委员自行判断,不折算成分数。改回发展性之后第二年,平均分回落到4.11,标准差回到0.51。有意思的是员工满意度没有下降,离职率也没有变化,说明大家不满的从来不是“分数低”,而是“分数假”。
一个可以拿来当判断标准的问题:如果你不能保证评价者的打分不会被被评者猜到,那就不要把它和钱挂钩。因为在这种结构下,评价者唯一的理性选择就是给高分,你得到的不是信息,是社交礼貌。
4. 360评估做完就结束了,员工没有任何改变,问题出在哪一步?
我们每年认真做一轮360,问卷发了、分收了、报告也生成了,但感觉大家看完就放下了,第二年还是同样的问题。到底是员工不重视,还是我们的流程本身有问题?
我们从系统后台拉过一轮完整数据:人均填写时间47分钟,回收率96%,但被评者收到反馈后真正形成书面改进动作的不到20%,30天后还能看到行为变化的更少。问题不在员工,在流程设计,我们把整个360的价值终点设在了“提交评分”,后面的反馈和行动没人负责。后来把流程倒过来做,四个改动。第一,先自评。
被评者自评时要列出“我最想被反馈的三个问题”,比如“我在评审会上是不是太容易打断别人”。有了这个靶子,评价者的评语才有落点,也解决了“不知道写什么”的问题。第二,降低单次负担。
每人只评5到8人,超过10人准确率明显下降,系统自动带出该评价人与被评者近三个月共同参与的项目作为提示,人均填写时间从47分钟降到22分钟,有效评语率反而上升。第三,反馈必须面谈,30分钟,规则是只谈两件“继续做”和两件“换个做法”,不谈分数、不做总结陈词。
第四,被评者当场写下1到2条可验证的行动,比如“下次需求评审前先发预读材料,提前24小时”,30天和60天后由上级各回看一次。最后这条最见效:加上30/60天回看之后,行动完成率从20%出头到了58%。因为大家很快发现,写完不做的成本变高了。还有一个容易被低估的坑是工具。
我们前两轮用表格加邮件收集,HR要手工合并、去重、拆分,第三轮回收率掉到61%,不是大家不愿意评,是流程太麻烦。后来把问卷、举证关联、反馈记录、行动跟踪放到一个系统里闭环,回收率回到93%。
选型时我的建议是看它能不能把“评语挂在具体任务上”和“行动项能被回看”这两件事做成一条线,如果只能发问卷收分数,那它省下的只是HR的半天,省不下这件事真正的时间成本。最后一句判断:360的钱和时间应该按2比8分配,两成花在评分表设计上,八成花在反馈面谈的培训和执行上。
大多数公司做反了,所以每年都在收集一堆没人看的分数。
文章包含AI辅助创作:360绩效考核系统:多维度评估如何避免成为形式主义,发布者:飞飞,转载请注明出处:https://worktile.com/solution-1/archives/636198

读者评论
文中把负面评价占比当作判断360是否还有生命力的核心指标,这个思路我认同,但实际操作中不好用。我们去年把结果用途改成发展诊断后,负面评价确实从个位数涨到两成,可HR要一条条读几百条文字反馈,最后只挑了几条塞进培训需求,其余无人处理。供给量上来了,消化能力没跟上,第二年员工又开始觉得写了也白写。反馈环节的投入,可能比设计问卷更该被算进预算。
小团队匿名那条我深有体会。我们组6个人互评,系统显示匿名,但一看措辞和提交时间就能猜到是谁,我自己填的时候也在掂量对方能不能认出来。文中建议少于5人只给汇总定性描述,可这样主管拿到的信息量和一次普通谈话差不多,还得额外花一轮评估的时间。这种情况下我更倾向于直接砍掉互评,把精力放在一对一的记录上。
一年6次具体事件这个门槛,理论上讲得通,落地时基本没人去核。我们上线时评价者名单还是按组织架构自动拉的,跨部门那部分人一年开不了几次会,问卷照发照填。真要按观测频次筛评价者,得先把协作关系梳理一遍,这活儿比设计问卷重得多,通常就是在这里省了工,然后原样重蹈覆辙。